ML: Шар Embedding у Keras
Вступ
У нейронних мережах існує спеціальний тип шару Embedding, який на вхід отримує номери слів, а на виході видає їхні векторні представлення (до початку навчання вони випадкові):

Вище VEC_DIM = 2 і у шару три входи (inputs = 3). У першого слова номер 0, у другого 2, а у третього 1. Шар Embedding зберігає матрицю форми (DIC_SIZE, VEC_DIM), з якої, при подачі на вхід числа i, видає i-й рядок.
Супровідний файл: NN_Embedding_Layer.ipynb. Загальну теорію векторизації слів можна знайти в цьому документі. Шар Embedding у бібліотеці PyTorch описаний тут.
Embedding у Keras
Як і в багатьох інших шарах бібліотеки Keras, при створенні шару Embedding можна не вказувати розмір батча (batch_size - число прикладів, за якими обчислюють помилку). Обов’язково задання числа слів у словнику VOC_SIZE і розмірності векторів VEC_DIM (вони визначають розмірність матриці векторів). Опціонально можна одразу задати і число входів:
VOC_SIZE = 5       # число слів у словнику
VEC_DIM  = 2       # розмірність векторного простору
inputs   = 3       # число входів (число цілих чисел)

m = Sequential()
m.add(Embedding(input_dim = VOC_SIZE, output_dim = VEC_DIM, input_length = inputs)
Форма вхідного і вихідного тензорів шару Embedding виглядають таким чином:
(batch_size, inputs) => (batch_size, inputs, VEC_DIM)Шар завжди йде першим, бо на його вході знаходиться тензор з цілими числами: [0...VOC_SIZE-1]. Число входів, як і розмір батча, можна не вказувати (вони автоматично визначаться за вхідним тензором):
m = Sequential()
m.add(Embedding(VOC_SIZE, VEC_DIM))    # змінне число батчів і входів
Наприклад, нижче batch_size=1 і inputs=1, 2:
print(m.predict([[0]]))    # (1,1)=>(1,1,2): [ [[0.01  0.025]] ]
print(m.predict([[0,4]]))  # (1,2)=>(1,2,2): [ [[0.01  0.025], [0.035 0.012]] ]
Аналогічно з batch_size=2 (список списків необхідно явно перетворити на numpy-тензор!):
print(m.predict(np.array([ [1,2], [3,4] ]) ))

    input1             input2
[ [[-0.044  0.029],  [ 0.01   0.038]]       sample1
  [[-0.018 -0.045],  [ 0.035  0.012]] ]     sample2
Матриця векторів
У методі m.layers[0].get_weights(), як звичайно, міститься список матриць з параметрами нульового шару. У даному випадку він складається з однієї матриці розмірності (VOC_SIZE,VEC_DIM):
[[ 0.01   0.025]          <= перше слово       id = 0
 [-0.044  0.029]
 [ 0.01   0.038]
 [-0.018 -0.045]
 [ 0.035  0.012]]         <= останнє слово    id = VOC_SIZE-1
Перед навчанням значеннями компонент векторів будуть випадкові числа, генератор яких задається параметром embeddings_initializer (за замовчуванням 'uniform': $[-0.05, 0.05]$, див. initializers).
Можна завантажити готову матрицю компонент векторів (наприклад, навчену на іншій задачі). Якщо необхідно, щоб вона далі не змінювалася, треба вказати trainable=False:
m = Sequential()
m.add( Embedding(VOC_SIZE,VEC_DIM, weights=[embedding_matrix], trainable=False) )
Регуляризація і обмеження
Компоненти векторів шару Embedding є навчаними параметрами. Для них (як і для будь-яких параметрів) можна встановити обмеження значень і регуляризаційні доважки до помилки.
Параметр embeddings_constraint (None за замовчуванням) задає обмеження. Наприклад:
m.add(Embedding(100,2, embeddings_constraint = keras.constraints.UnitNorm(axis=1)))буде контролювати, щоб вектори були одиничними.
Параметр embeddings_regularizer (None за замовчуванням) робить обмеження на компоненти векторів більш м’якими. Для цього до функції помилки додається, наприклад, сума квадратів компонент, помножена на невелику константу (нижче 0.01). Градієнтний метод буде одночасно намагатися зменшити помилку передбачення моделі і величину компонент, тим самим не даючи їм неконтрольовано збільшуватися:
m.add(Embedding(100,2, embeddings_regularizer = keras.regularizers.l2(0.01) ))
Взаємодія з Dense і RNN
Повнозв’язний шар Dense зв’язує синапси з останньою розмірністю попереднього тензора: $\sum_\alpha X_{i...j\alpha}\,W_{\alpha k}=Y_{i...jk}$. На виході шару Embedding знаходиться тензор з розмірністю не два, а три, форми (batch_size, inputs, VEC_DIM). Тому (якщо вектори необхідно проконкатенувати), при приєднанні після Embedding шару Dense між ними треба вставити шар Flatten():
m = Sequential() # 5         2                        Output shape:    Params:
m.add(Embedding(VOC_SIZE, VEC_DIM, input_length=3)) # (None,3,2)       5*2 = 10
m.add(Flatten())                                    # (None,6=2+2+2)   0
m.add(Dense(1))                                     # (None,1)         3*2+1 = 7
Нижче на першому рисунку наведено архітектуру цієї моделі. Число параметрів шару Embedding дорівнює VOC_SIZE*VEC_DIM, а у шару Dense з одним нейроном (units=1) матриця (inputs*VEC_DIM, 1) і зміщення (одне число) призводить до inputs*VEC_DIM + 1 параметрів.
Шар Flatten параметрів не має. Його задача зробити вхідний тензор даних лінійним. При цьому він не зачіпає нульову вісь батча, тобто при дії Flatten() на тензор (batch_size, size1,...,sizeN) виходить тензор (batch_size, size1*...*sizeN):
t = keras.backend.ones((10, 2, 3, 4, 5))            # (10, 2, 3, 4, 5)
print( Flatten()(t).shape )                         # (10, 120)
Якщо зниження розмірності Flatten не зробити, то модель:
m = Sequential() # 5         2                        Output shape:    Params:
m.add(Embedding(VOC_SIZE, VEC_DIM, input_length=3)) # (None,3,2)       5*2 = 10
m.add(Dense(1))                                     # (None,3,1)       2+1 = 3
згорне виходи Embedding шару і ваги шару Dense c units нейронами таким чином:
np.dot( (batch_size, inputs, VEC_DIM), (VEC_DIM, units) ) = (batch_size, inputs, units).
Число параметрів у шарі Dense тепер буде дорівнювати VEC_DIM+1. Це означає, що до кожного вектора приєднується шар з одними й тими самими вагами. Нижче ця архітектура намальована в центрі:
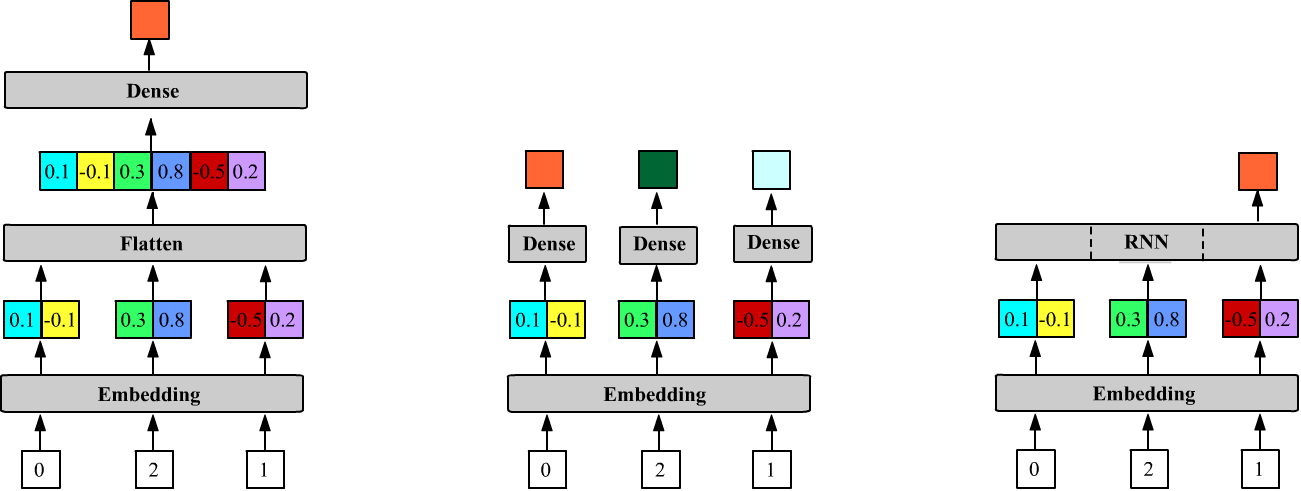
На відміну від шару Dense, рекурентні шари очікують на своїх входах вектори, тому Embedding до них приєднується безпосередньо (вище третій рисунок):
m = Sequential() # 5         2                        Output shape:    Params:
m.add(Embedding(VOC_SIZE, 2, input_length = 3))     # (None, 3, 2)     5*2 = 10
m.add(LSTM(1))                                      # (None, 1)        4*((2+1)+1)=16
Рекурентна мережа (LSTM) за замовчуванням має return_sequences=False, тому вище повертається прихований стан (одновимірний) лише останньої (третьої) комірки.
Маскування входів
Рекомендується перше слово у словнику (нульовий індекс) резервувати і не займати значущим словом. Тоді нульовий індекс можна буде використовувати як ознаку відсутності входу. Це корисно при змінному числі входів, наприклад у RNN. Для використання маскування в Embedding треба вказати mask_zero=True. Шар як і раніше буде видавати вектори за числом входів. Однак наступний RNN шар вектор з нульовим індексом буде ігнорувати, переходячи до наступної комірки:
m = Sequential()
m.add( Embedding(VOC_SIZE,VEC_DIM, mask_zero=True) )
m.add( SimpleRNN(1,  return_sequences=True) )

print(m.predict(np.array([ [1,0,3,0,2,0,0] ]) ))

[[[0.02 ]        # обчислили для 1
  [0.02 ]        # пропустили (0), повторивши прихований стан для 1
  [0.069]        # обчислили для 3
  [0.069]        # пропустили (0), повторивши прихований стан для 3
  [0.065]        # обчислили для 2
  [0.065]        # пропустили (0), повторивши прихований стан для 2
  [0.065]]]      # пропустили (0), повторивши прихований стан для 2
Зазвичай масковані входи з нулями йдуть наприкінці послідовності, "добиваючи" короткі речення до максимальної довжини нулями.
Маскування враховується також при обчисленні помилки, ігноруючи помилку від маскованих входів.