ML: : Передбачення букв
Вступ
Розглянемо приклад прогнозування чергової букви тексту за допомогою рекурентної нейронної мережі. Вихідний код можна знайти в нотбуці NN_RNN_Torch_Chars.ipynb
Формування даних
Як невеликий полігон будемо використовувати "Казку про царя Салтана". Алфавіт CHARS візьмемо фіксованим і включимо до нього кінець рядка '\n' (вірші):
CHARS  = " .абвгдежзийклмнопрстуфхцчшщъыьэюя\n"        # алфавіт
charID = { c:i for i,c in enumerate(CHARS) }           # буква в номер
Завантажимо текст з файлу, переведемо у нижній регістр, вичистимо подвійні пробіли тощо:
import re

with open("saltan.txt", "r", encoding='utf-8-sig') as file:
    text = file.read()

    text = text.lower().replace('ё','e')
    text = ''.join( [c if c in CHARS else ' ' for c in text] )
    text = re.sub(' +',    ' ',  text).replace(' .', '.')
    text = re.sub('\n\s+', '\n', text)
Для формування навчальних даних ковзаємо по тексту вікном довжиною LENGTH з кроком STEP букв. Номери букв, що потрапили у вікно, поміщаємо в X_dat. У цільовий масив Y_dat поміщаємо букви, зсунуті на одну вперед:
LENGTH, STEP = 25, 25                         # довжина історії, зміщення по тексту
textID = [ charID[c] for c in text ]          # текст - список індексів (номери в CHARS)

num_seq  = int((len(textID)-LENGTH)/STEP)-1   # число послідовностей

X_dat = torch.empty (num_seq, LENGTH, dtype=torch.long)
Y_dat = torch.empty (num_seq, LENGTH, dtype=torch.long)

for i in range(num_seq):
    X_dat[i] = torch.tensor(textID[i*STEP:   i*STEP+LENGTH],   dtype=torch.long)
    Y_dat[i] = torch.tensor(textID[i*STEP+1: i*STEP+LENGTH+1], dtype=torch.long)
Крок STEP вибрано рівним ширині вікна LENGTH, щоб перевірочні дані
після перемішування не перетнулися з тренувальними (див. наступний розділ).
Перемішаємо дані і розіб’ємо їх на тренувальне (X_trn, Y_trn)
і перевірочне (X_val, Y_val) множини:
idx = torch.randperm( len(X_dat) )            # перемішаний список індексів
X_dat, Y_dat = X_dat[idx], Y_dat[idx]

num_trn = int(0.75*len(X_dat))                # частка тренувальних даних
X_trn, Y_trn = X_dat[:num_trn], Y_dat[:num_trn]
X_val, Y_val = X_dat[num_trn:], Y_dat[num_trn:]
Стратегія навчання
У принципі, можна навчати мережу передбачати Y_trn за входом X_trn, задіюючи всі виходи рекурентного шару. Однак ми зробимо інакше. Введемо гіперпараметр NUM, який менший за довжину послідовності LENGTH. За першими LENGTH - NUM комірками мережа буде накопичувати прихований стан (історію). Помилки ж передбачення обчислюватимуться лише за останніми NUM комірками. Використання значень NUM > 1 доцільне для зменшення затухання градієнта при його зворотному поширенні.
Нижче намальована двошарова RNN-мережа. На входи комірок першого шару надходить текст "вечерко" Насправді одночасно в навчанні бере участь не один, а B прикладів довжини L (батч). Тому на вході мережі знаходиться тензор форми (B,L), що містить номери букв. Він проходить через шар Embedding і кожна буква перетворюється на E-вимірний вектор, тобто виходить тензор (B,L,E):
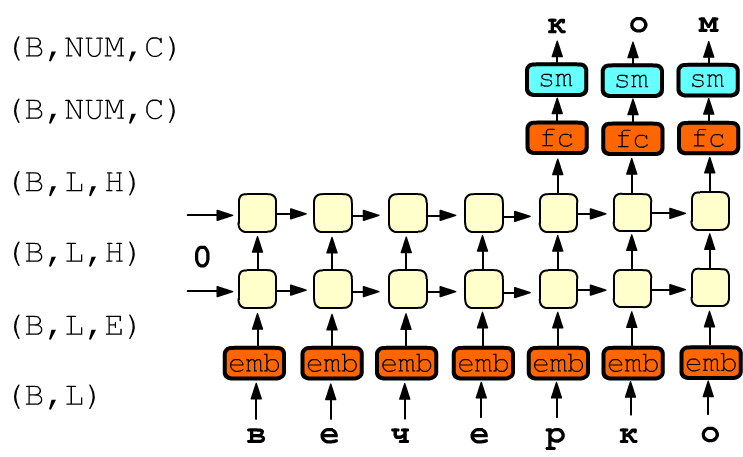
Вихід останнього RNN-шару має розмірність (B,L,H), де H - розмірність прихованого стану. Для обчислення помилки беруться лише останні NUM комірки. Тому тензор (B,NUM,H) за допомогою повнозв’язного шару fc (fully connected) з матрицею форми (H,C) перетворюється на тензор (B,NUM,С), де С-число букв в алфавіті (число класів). Після пропуску цього тензора через функцію софтмакса sm для кожного прикладу B і виходу NUM виходить С чисел, які інтерпретуються як ймовірності тієї чи іншої букви (сума чисел після sm дорівнює одиниці). Помилка передбачення обчислюється як середня CrossEntropyLoss по всіх виходах NUM і прикладах B.
Модель
У конструкторі моделі створимо шар ембедингу, стопку з NUM_LAYERS рекурентних шарів GRU, вихідний повнозв’язний шар Linear і Dropout шар, який з імовірністю DROP обнуляє компоненти тензора перед fc:
class Model(nn.Module):
    def __init__(self, C, E, H, LAYERS = 1, DROP = 0):
        super(Model, self).__init__()

        self.emb  = nn.Embedding(C, E, scale_grad_by_freq=True)
        self.rnn  = nn.GRU    (E, H, num_layers=LAYERS, batch_first=True, dropout=0.2)
        self.drop = nn.Dropout(DROP)
        self.fc   = nn.Linear (H*LAYERS, C)
Звернімо увагу на параметр scale_grad_by_freq при створенні шару Embedding. Букви в тексті мають суттєво різну ймовірність. Тому під час навчання більш часті букви інтенсивніше змінюватимуть компоненти своїх векторів, ніж більш рідкісні. При параметрі scale_grad_by_freq = True за поточним батчем обчислюються ймовірності букв і вектори більш рідкісних букв оптимізатор зсуває сильніше.
Метод прямого поширення forward визначає послідовність обчислень. Праворуч у коментарях наведено форми отримуваних тензорів.
.   def forward(self, x, h0=None, NUM=1):       # (B,L), (1,B,H)
        x      = self.emb ( x )                 # (B,L,E)
        yr, hr = self.rnn ( x, h0 )             # (B,L,H),  (1,B,H)

        y = yr[:, -NUM:,  :]                    # (B,NUM,H) останні виходи
        y = self.drop(y)
        y = self.fc(y)                          # (B,NUM,C)
        return y.transpose(1,2), hr             # (B,C,NUM), (LAYERS,B,H)
У нашій стратегії навчання матриця повнозв’язного шару fc згортається
не з усім вихідним тензором (B,L,H), а лише з його зрізом
(B,NUM,H).
Крім прискорення, це може призводити до суттєвої економії пам’яті при великому розмірі словника
(коли замість букв працюють зі словами). Нехай, наприклад, у батчі B=100 прикладів,
розмірність прихованого стану H=500
і в словнику C=100'000 слів.
Тоді тензор усіх виходів RNN-шару
має 100*500*L елементів, а тензор після повнозв’язного шару
в 200 разів його більший: 100*100000*L. При довгих послідовностях L
такий тензор може навіть не поміститися в пам’ять графічної карти. Тому згортати
всі виходи RNN шару з повнозв’язним вихідним шаром fc не доцільно.
Створення екземпляра моделі стандартне. За наявності графічної карти gpu параметри моделі одразу відправляються в її пам’ять. Список losses нам знадобиться далі для візуалізації історії помилок навчання.
E_DIM, H_DIM, NUM_LAYERS, DROP = 10, 250, 1, 0

model = Model(len(CHARS), E_DIM, H_DIM)         # екземпляр мережі

gpu = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
cpu = torch.device("cpu")

model.to(gpu)
losses = []                                     # історія помилок для графіка
Ваги класів і функція помилки
Ще один спосіб боротьби з перекосом ймовірностей класів (букв) — це використання ваг ступеня важливості помилки даної букви. Якщо всі ваги однакові, то мережа прагне краще передбачати часті букви, ніж більш рідкісні. Щоб знизити цей ефект, обчислимо частоту кожної букви weight, а потім візьмемо її логарифм з оберненим знаком.
weight = torch.zeros(len(CHARS), dtype=torch.float)
for c in textID:
    weight[c] += 1

weight /= len(text)
weight = -weight.log_()
Наведемо ваги для 5 найчастіших і 5 найрідкісніших букв:
     ' ': 1.86   'о': 2.51   'е': 2.76   'а': 2.72   'и': 2.98
     'ю': 5.49   'щ': 6.44   'э': 7.49   'ъ': 7.49   'ф': 8.95
Використання логарифма робить збільшення ваги рідкісних букв більш м’яким
порівняно, наприклад, з оберненою ймовірністю.
Нормувати ваги не обов’язково, бо функція помилки це робить сама.
CE_loss = nn.CrossEntropyLoss(weight.to(gpu))
Навчання
Функція навчання на одну епоху має вигляд:
def fit(model, X,Y, batch_size=64, NUM=1, train=True):
    model.train(train)                                   # важливо для Dropout
    sumL, iters = 0, int(len(X)/batch_size)

    tm1 = tm()
    for it in range(iters):                                # приклади розбиті на пачки

        xb = X[it*batch_size: (it+1)*batch_size].to(gpu)   # (B,L)
        yb = Y[it*batch_size: (it+1)*batch_size].to(gpu)   # (B,L)

        y, _ = model(xb, NUM=NUM)
        L    = CE_loss(y, yb[:, -NUM:])

        sumL += L.detach().item()

        if train:                                        # у режимі навчання
            optimizer.zero_grad()                        # обнуляємо градієнти
            L.backward()                                 # обчислюємо градієнти
            optimizer.step()                             # підправляємо параметри

        if tm() - tm1 > 1 or it+1==iters:
            print('\r', f"{100*(it+1)/iters:.0f}%  loss: {sumL/(it+1):.4f}", end='')
            tm1 = tm()

    return sumL/iters
Запуск навчання:
from IPython.display import clear_output
import matplotlib.pyplot as plt

for epoch in range(100):
    optimizer = torch.optim.Adam(model.parameters(), lr=0.001, betas=(0.9, 0.999))

    idx = torch.randperm( len(X_trn) )     # перемішаний список індексів
    X_trn = X_trn[idx]
    Y_trn = Y_trn[idx]

    L_trn, A_trn = fit(model, X_trn, Y_trn, 256, NUM = 25, train=True )
    L_val, A_val = fit(model, X_val, Y_val, 256, NUM = 25, train=False)
    losses.append([L_trn, L_val])

    clear_output(wait=True)
    plt.figure(figsize=(16,4)); plt.plot(losses); plt.legend(['trn', 'val']);  plt.show()

    print('\r', f'epoch: {epoch:d}/{len(losses)-1}  {tm()-beg:.2f}s ',
                f'loss: trn={L_trn:.4f} val={L_val:.4f}  ' )
One-hot vs Embedding
Оскільки букв у словнику небагато, можна було б прибрати шар Embedding, виконавши one-hot кодування. Для цього достатньо покласти E_DIM=len(CHARS) і замінити у функції forward рядок x = self.emb ( x ) на:
B, L, C = len(x), x.size(1), self.fc.size(-1)
x = torch.zeros(B,L,C).scatter_(2, x.unsqueeze(2), 1.)    # (B,L,C)
x = x.transpose(0,1).contiguous()                         # (L,B,C)
Оскільки x має форму (B,L), спочатку створюється тензор (B,L,C), заповнений нулями. Метод x.unsqueeze(2) — це зміна форми тензора: (B,L) -> (B,L,1). Метод scatter_ ставить в останньому індексі тензора одиниці в позиції, що відповідає значенню x. Псевдокод для цього методу: self[i,j, x[i,j,k]] = 1. Наприклад:
L, C = 3, 4
x = torch.tensor([ [1,0,1],  [0,2,3] ], dtype=torch.long)
x = torch.zeros(len(x), 3, 4).scatter_(2, x.unsqueeze(2),  1.)   # (B,L,C)

[[[0., 1., 0., 0.],  [1., 0., 0., 0.],  [0., 1., 0., 0.]],
 [[1., 0., 0., 0.],  [0., 0., 1., 0.],  [0., 0., 0., 1.]]])