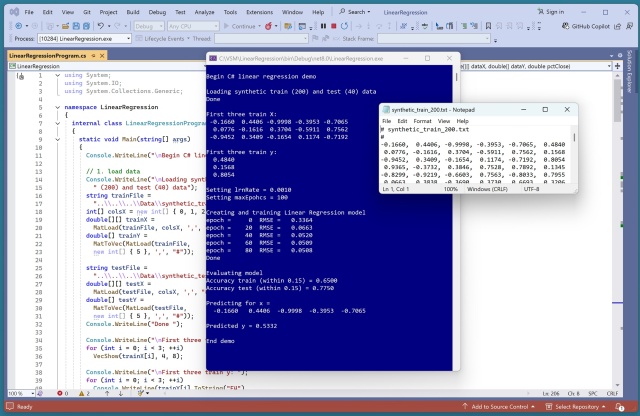
Співробітник технологічної компанії створює демонстрацію лінійної регресії, використовуючи дані, згенеровані нейронною мережею, щоб отримати уявлення про узгодженість дизайну API.
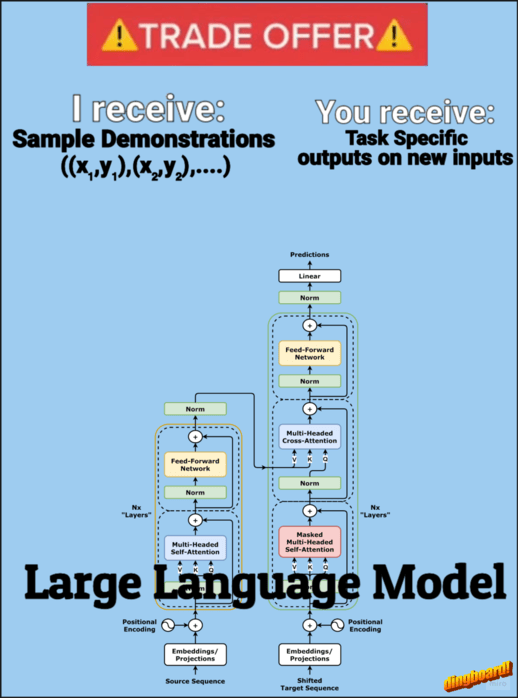
Моделі Transformer навчаються на основі прикладів за допомогою методів навчання в контексті (In-context learning, ICL) та підходів з використанням невеликої кількості прикладів (few-shot prompting). Механізм уваги Softmax з параметром "зворотної температури" дозволяє імітувати поведінку найближчого сусіда при обробці прикладів.

Сучасні найкращі практики навчання великих мовних моделей (LLM) акцентують увагу на попередній обробці даних, включаючи видалення дублікатів, вибірку даних та обробку упередженої/шкідливої мови для покращення продуктивності моделі. Розширені методи, такі як видалення дублікатів даних і видалення даних, що використовуються для наступних завдань, є важливими для забезпечення високоякісних і різно...
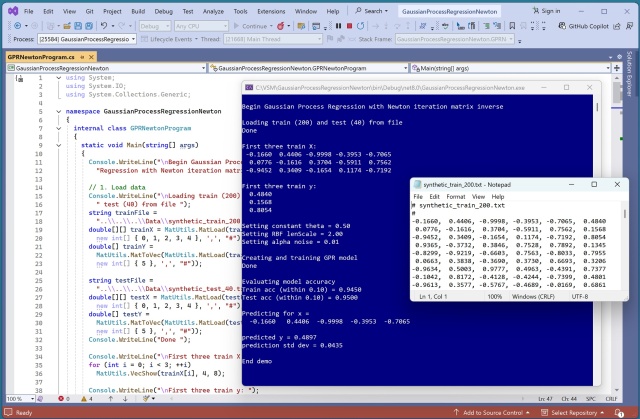
Обернена матриця ітерацій Ньютона була успішно використана в регресії гауссівського процесу для підвищення ефективності, точності та робастності. Демонстрація продемонструвала високий рівень точності прогнозування цільових значень для синтетичних даних зі складною базовою структурою.
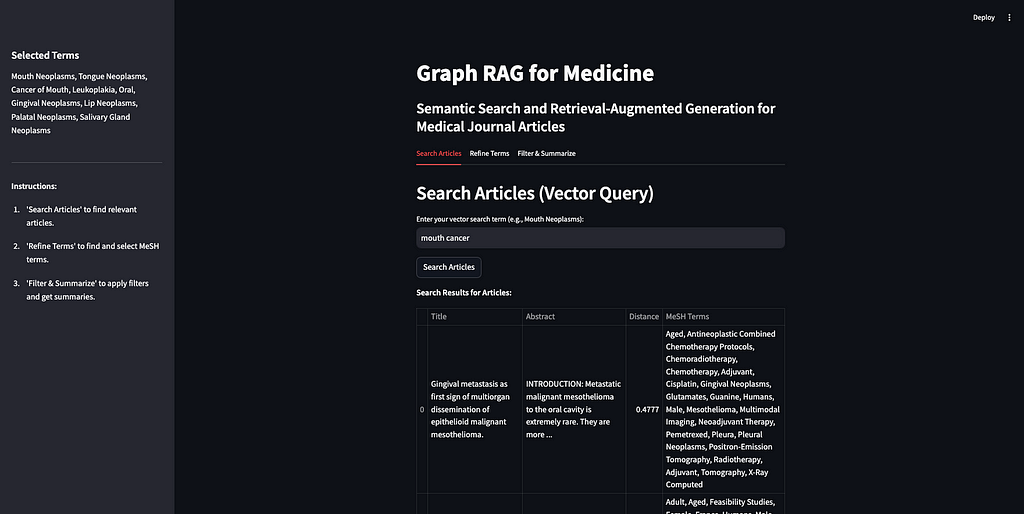
Графи знань та штучний інтелект об'єднуються в додатку Graph RAG, що покращує відповіді LLM за допомогою контекстних даних. Graph RAG набуває все більшої популярності, а Microsoft і Samsung роблять значні кроки в технології графів знань.
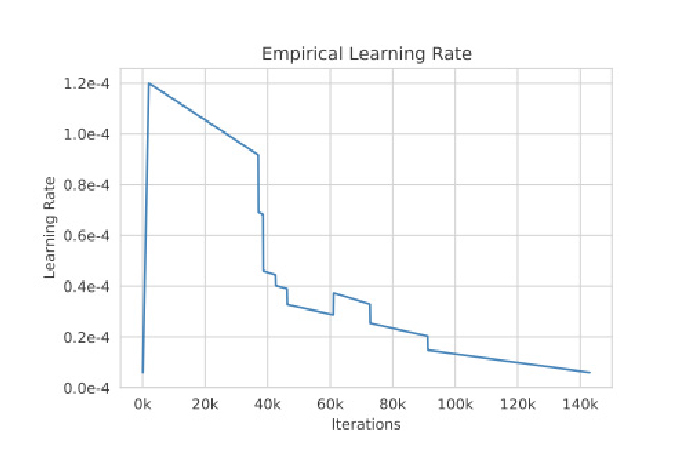
Навчання великих мовних моделей (LLM) з нуля передбачає масштабування від менших моделей і вирішення проблем, які виникають зі збільшенням розміру моделі. GPT-NeoX-20B та OPT-175B внесли архітектурні зміни для підвищення ефективності навчання та продуктивності, що демонструє важливість експериментів та оптимізації гіперпараметрів під час попереднього навчання LLM.
Реалізація інструменту оптимізації резюме за допомогою Python та API OpenAI для адаптованих заявок на роботу. Дізнайтеся, як оптимізувати процес за допомогою 4-етапного робочого процесу та прикладу коду.
Порогове значення є ключовим методом управління невизначеністю моделі в машинному навчанні, що дозволяє втручатися людині в складних випадках. У контексті виявлення шахрайства порогове значення допомагає збалансувати точність і ефективність, відкладаючи невизначені прогнози для перевірки людиною, що сприяє підвищенню довіри до системи.
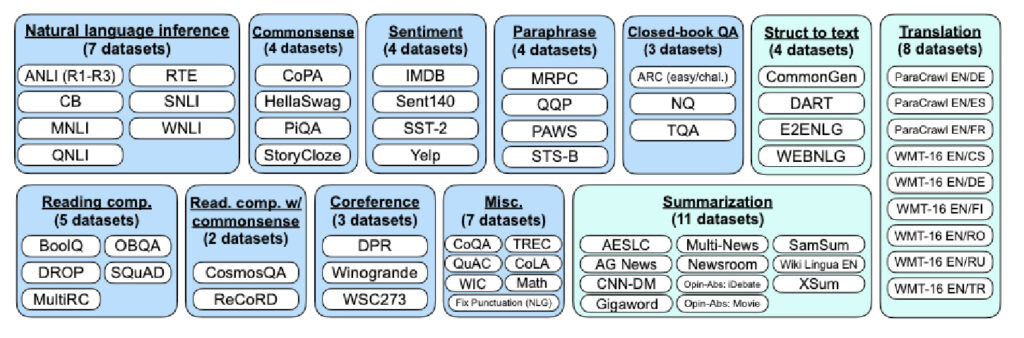
Сучасні найкращі практики навчання великих мовних моделей включають різноманітні методи оцінювання моделей у завданнях, таких як відповіді на запитання, переклад та логічне мислення. Методи оцінювання, такі як навчання з використанням невеликої кількості прикладів (n-shot learning) із підказками, є важливими для точної оцінки продуктивності моделі.

Штучний інтелект може маніпулювати рішеннями, оскільки компанії конкурують за прогнозування людської поведінки на ринку «економіки намірів». Дослідники Кембриджського університету показують, як інструменти штучного інтелекту прогнозують і продають людські наміри компаніям, що прагнуть отримати прибуток.
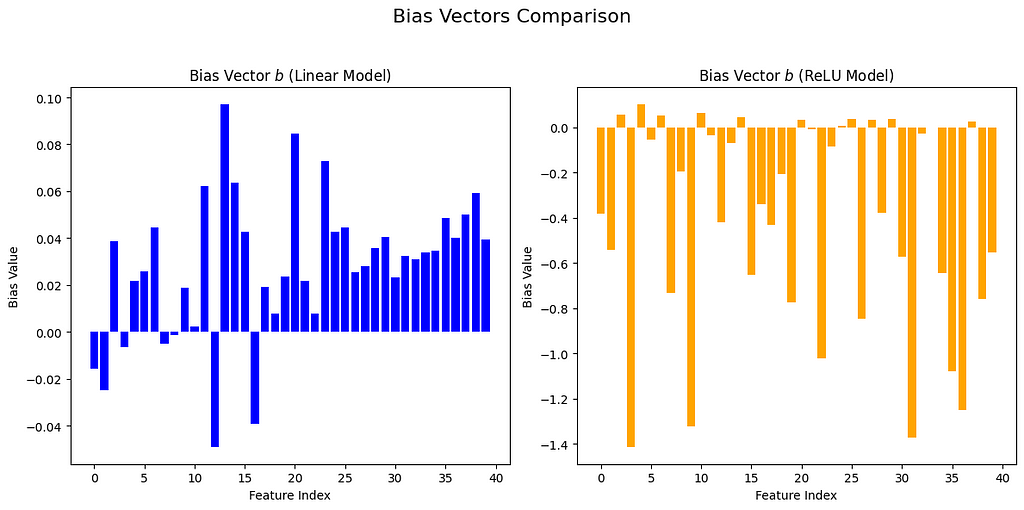
Нейронні мережі стикаються з проблемами суперпозиції, коли один нейрон представляє декілька ознак. Нелінійність та розрідженість ознак відіграють ключову роль у виникненні суперпозиції.
Paligemma VLM від Google поєднує в собі кодер технічного зору та мовну модель для таких завдань, як розпізнавання об'єктів. Paligemma може обробляти зображення з різною роздільною здатністю та ідентифікувати об'єкти без тонкого налаштування, але Google рекомендує тонке налаштування для специфічних завдань.

Великі мовні моделі трансформували корпорації, а «агенти» зі штучним інтелектом вийдуть на перший план у 2025 році. Ці інтелектуальні системи, керовані магістрами права, здатні розуміти цілі та здійснювати осмислені дії, як людина, пропонуючи допомогу у виконанні повсякденних завдань.

Покращуйте міжпродуктові інсайти за допомогою пакету dbtsetsimilarity. Розраховуйте індекс Jaccard для аналізу моделей прийняття продуктів у багатопродуктових компаніях.

Пурніма Рамарао ставить під сумнів спроможність поліції Сан-Франциско проводити розслідування після загадкової смерті свого сина Сучіра Баладжі. Друзі збираються на віче в Мілпітас, штат Каліфорнія, щоб вшанувати колишнього дослідника і викривача OpenAI.