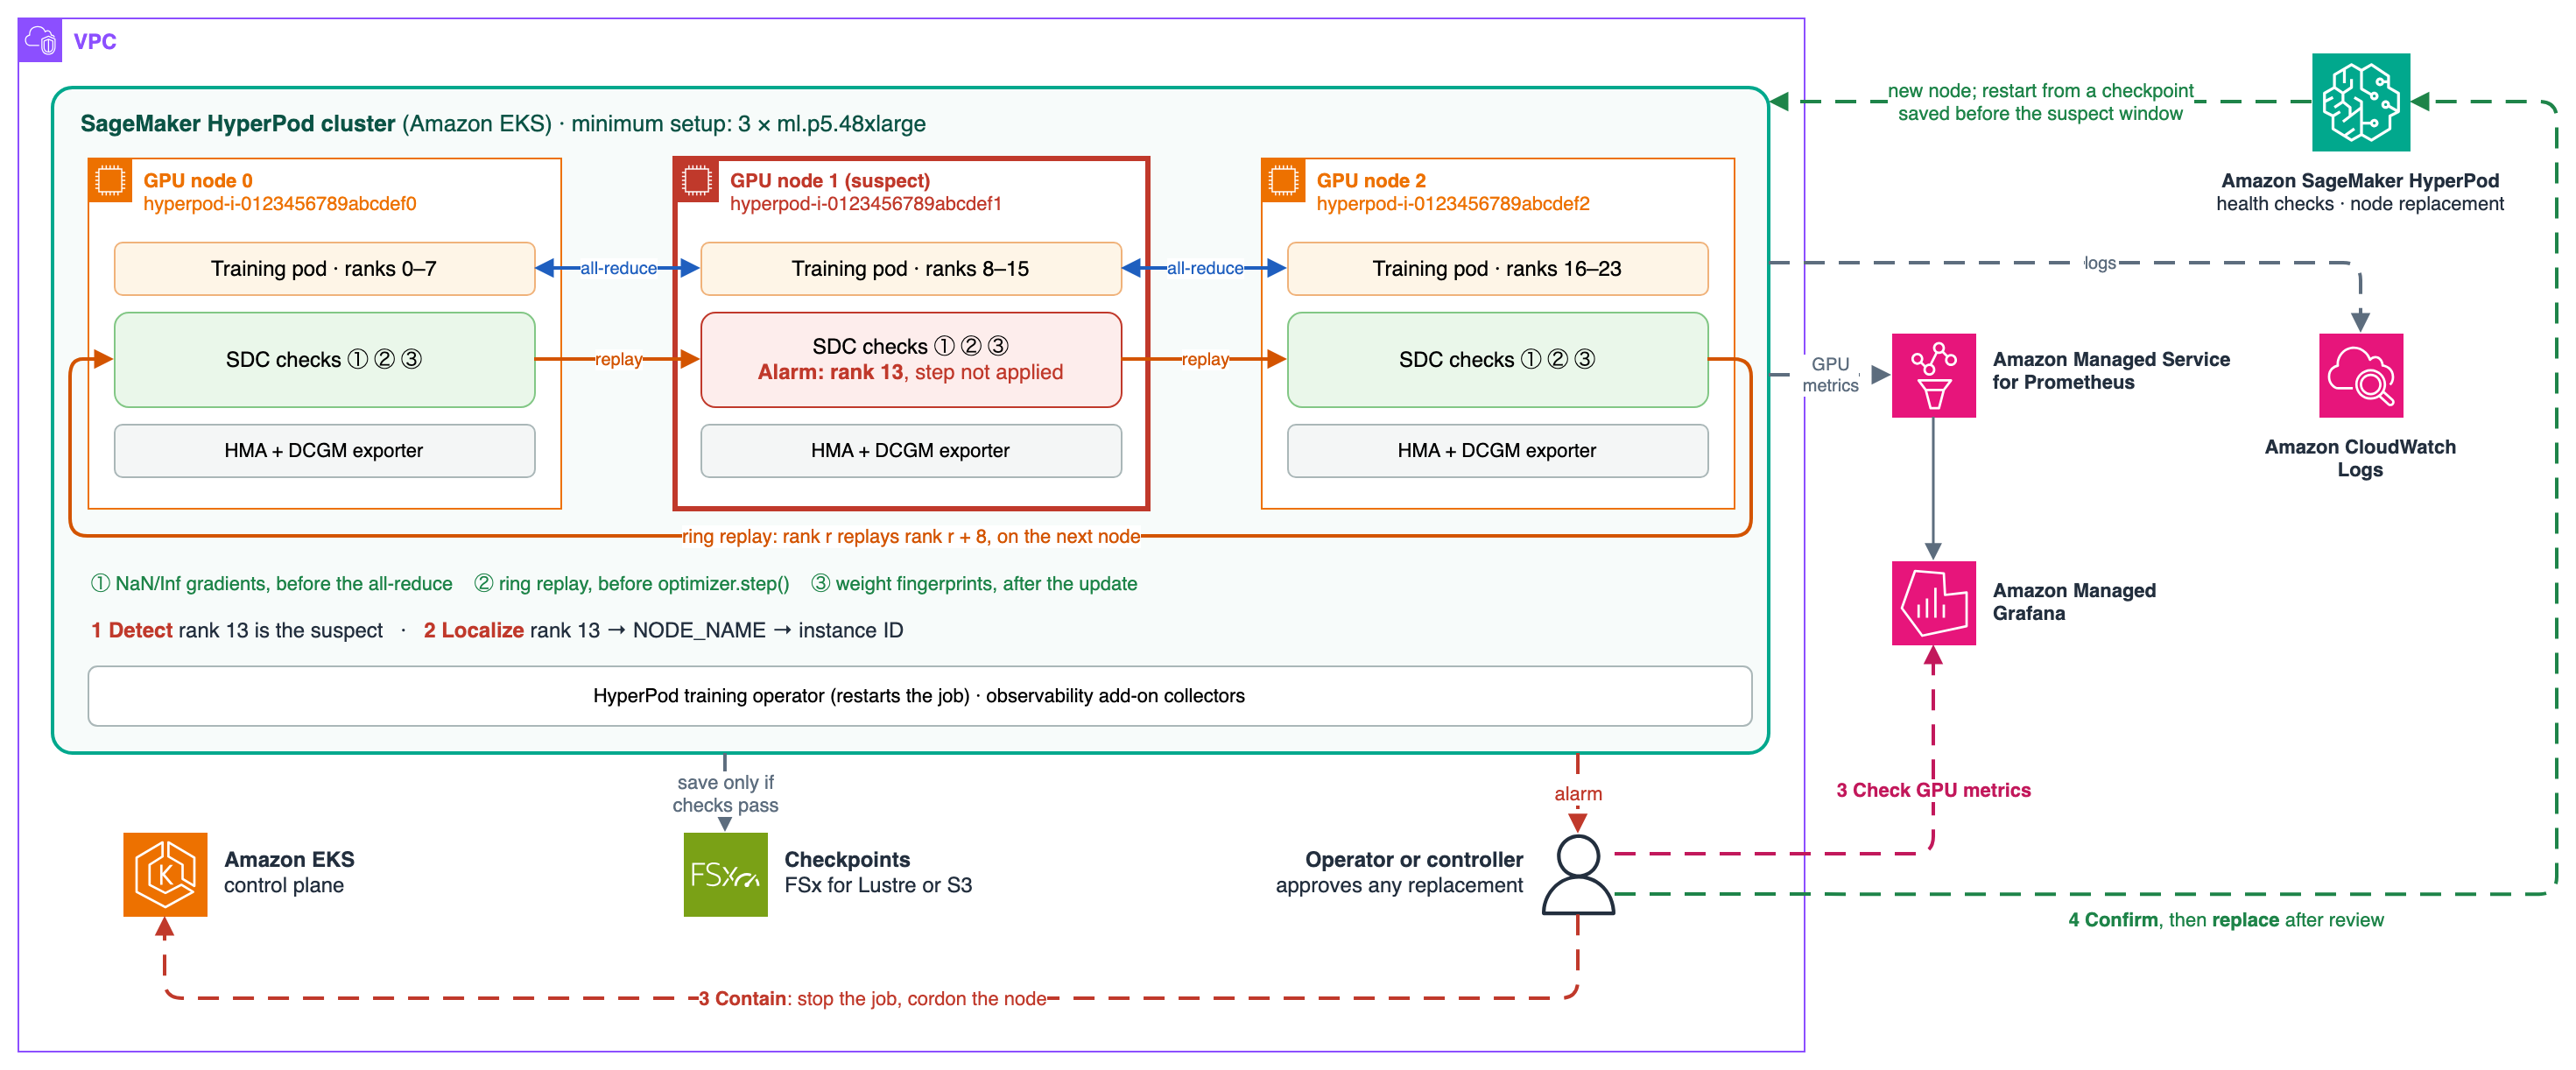
Приховані помилки в даних (Silent Data Corruption, SDC) під час навчання моделей машинного навчання виникають, коли апаратне забезпечення, наприклад графічний процесор (GPU), повертає невірні, але правдоподібні значення, не викликаючи при цьому жодних помилок. Це може призвести до поширення неправильних даних у градієнти та ваги під час розподіленого навчання, що в результаті може призвести до ...
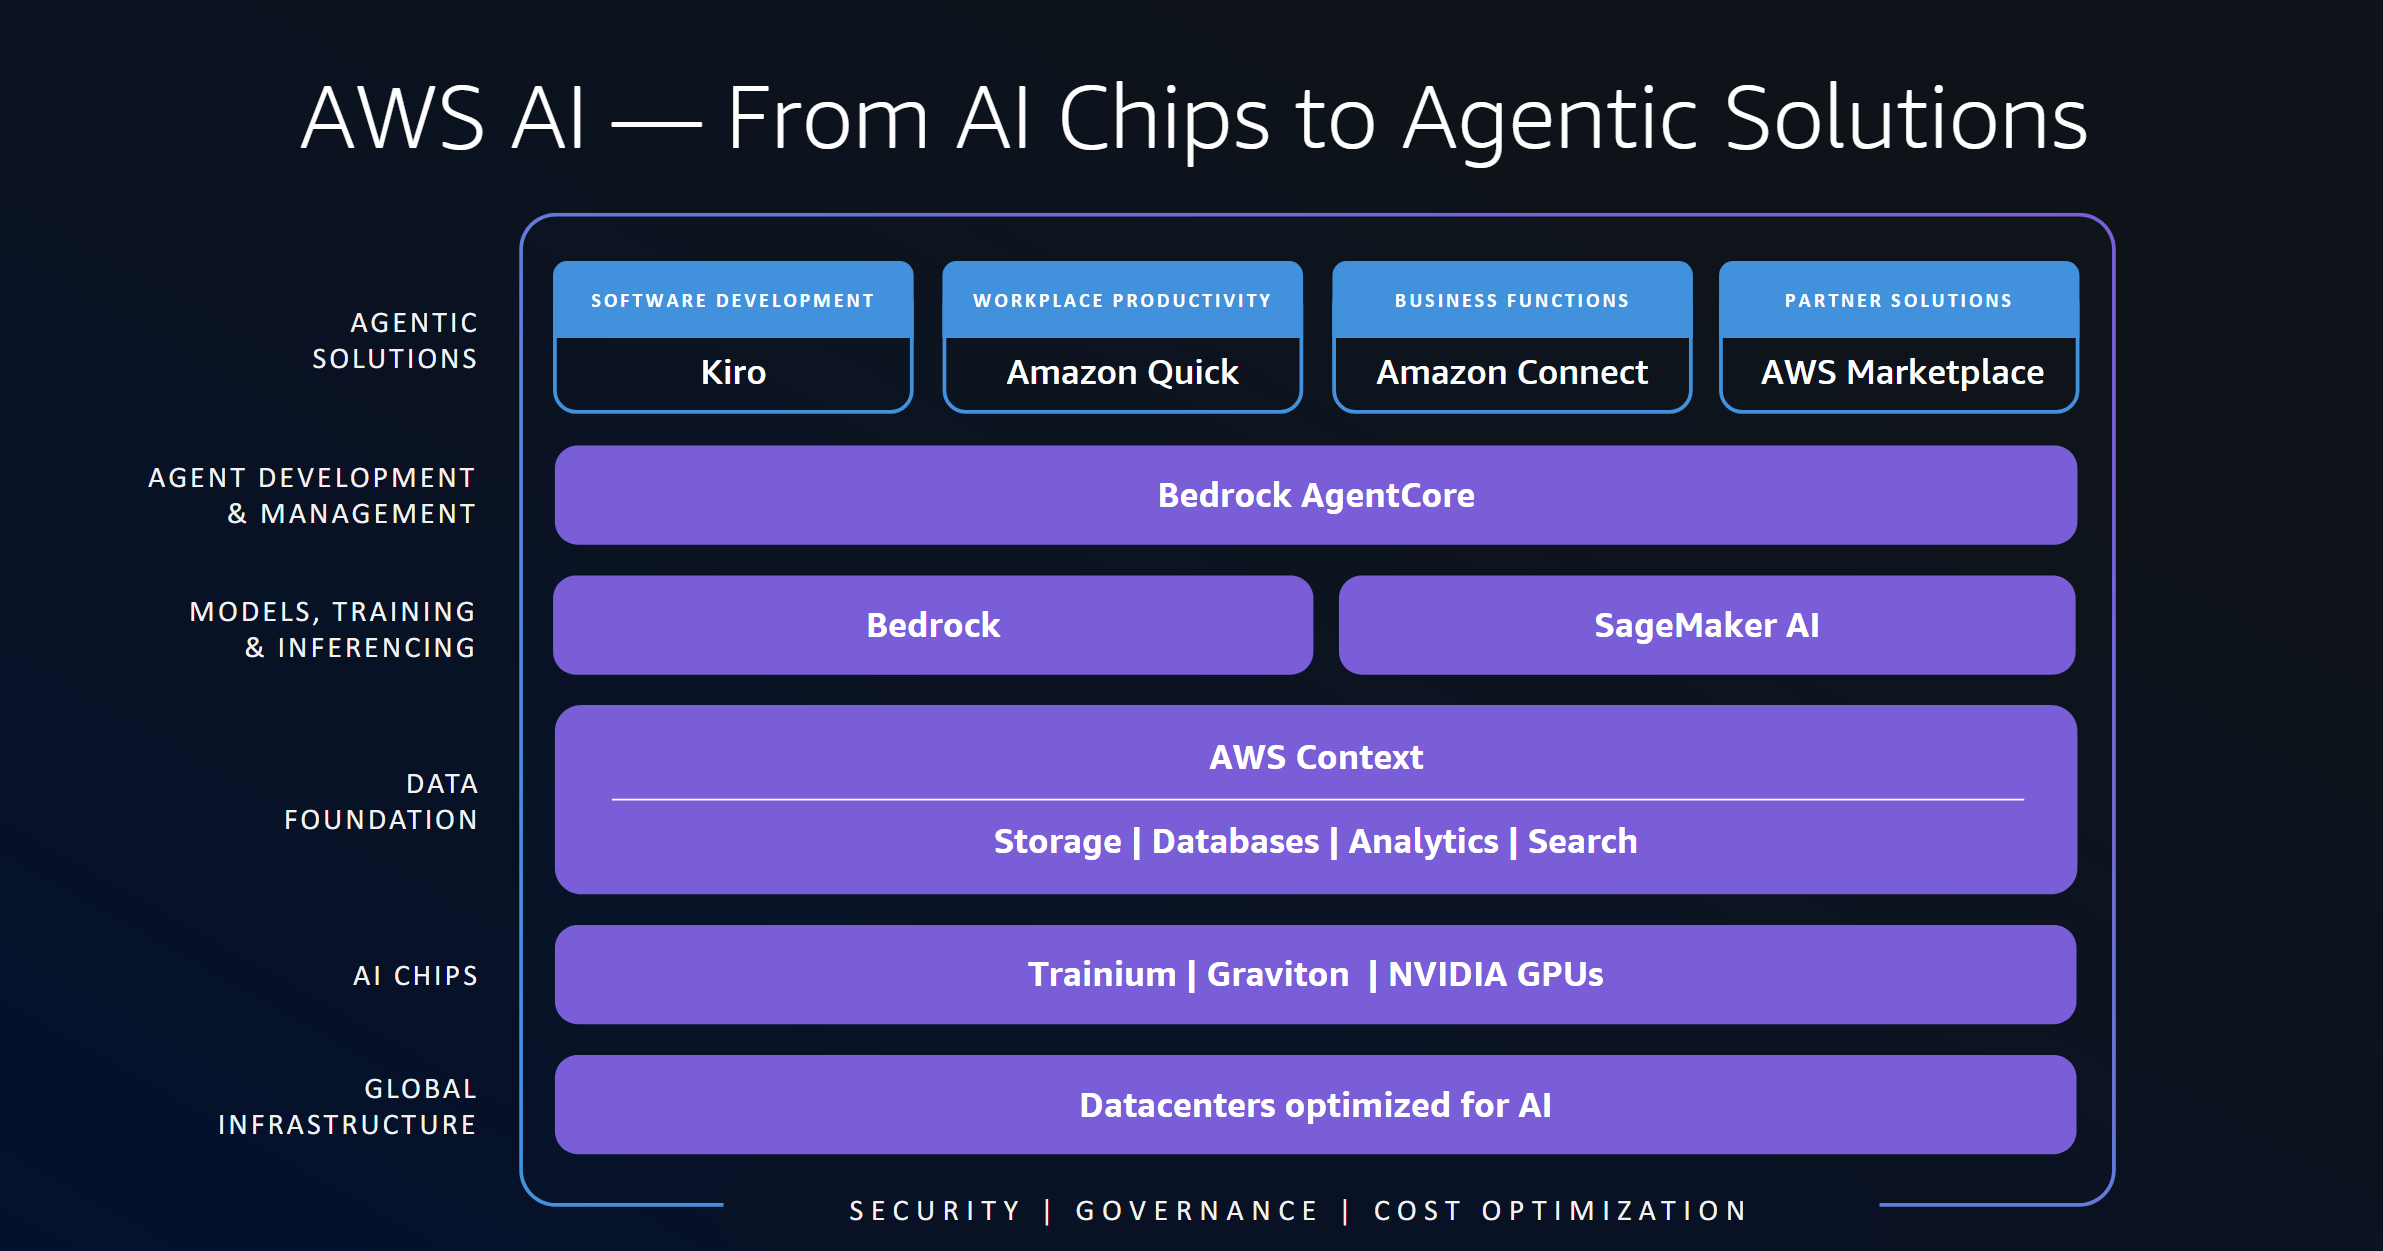
Amazon Web Services (AWS) проведе свою щорічну освітню конференцію re:Invent з 30 листопада по 4 грудня. Учасники зможуть ознайомитися з різними технологіями AWS за допомогою основних доповідей, інтерактивних заходів та понад 2000 сесій, включаючи 140 у напрямку штучного інтелекту/машинного навчання. Сесії доступні для різних рівнів підготовки, і деякі з них можна переглядати за вимогою. re:Inv...
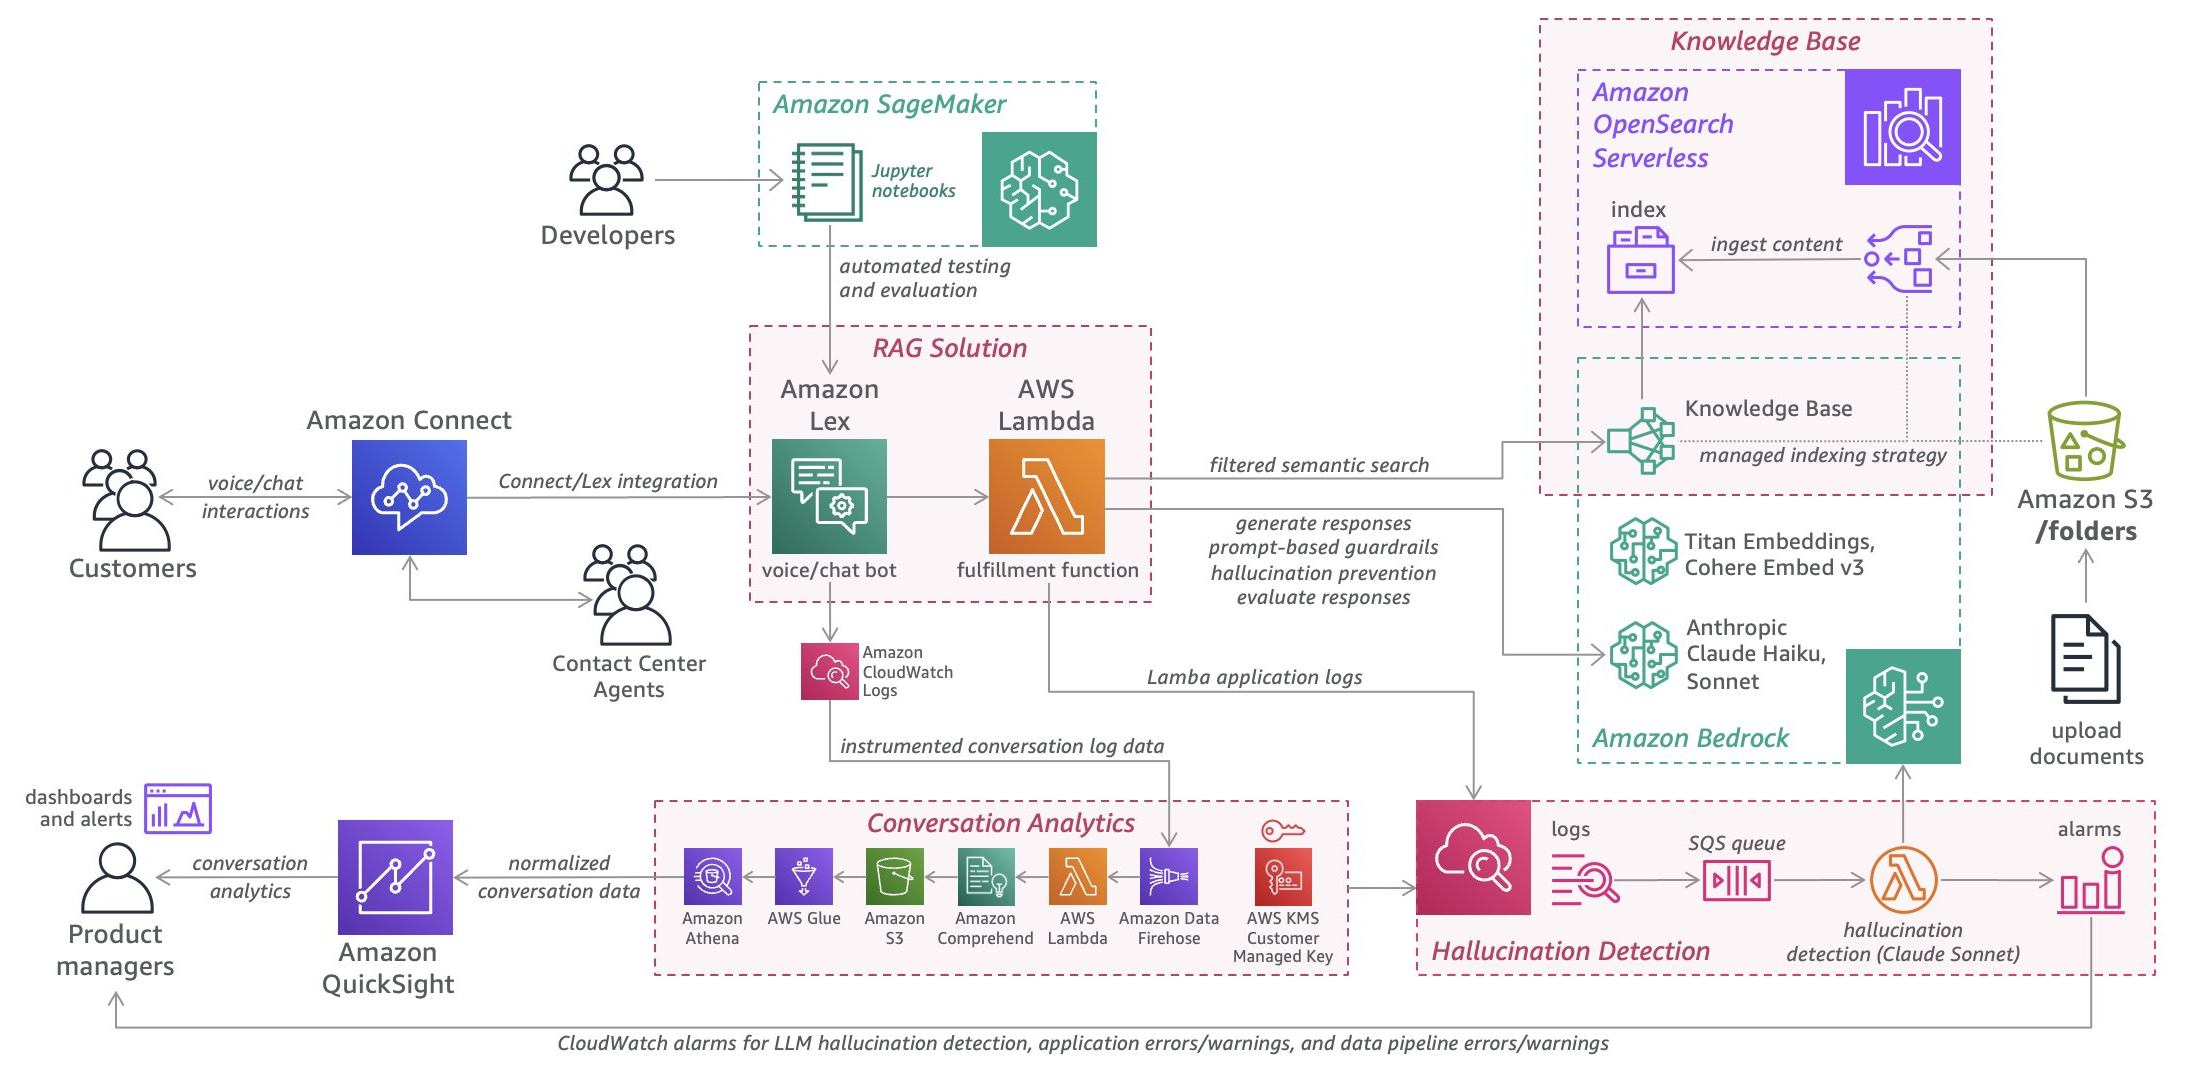
У цій статті ви дізнаєтесь, як повторно використовувані ресурси з Центру інновацій у сфері генеративного штучного інтелекту AWS можуть допомогти скоротити час і вартість розробки рішень на основі генеративного ШІ. Ці ресурси, включаючи конвеєри доповнення отриманої інформації (Retrieval Augmented Generation), обробники документів та шаблони для агентів, можуть заощадити командам місяці розробки...
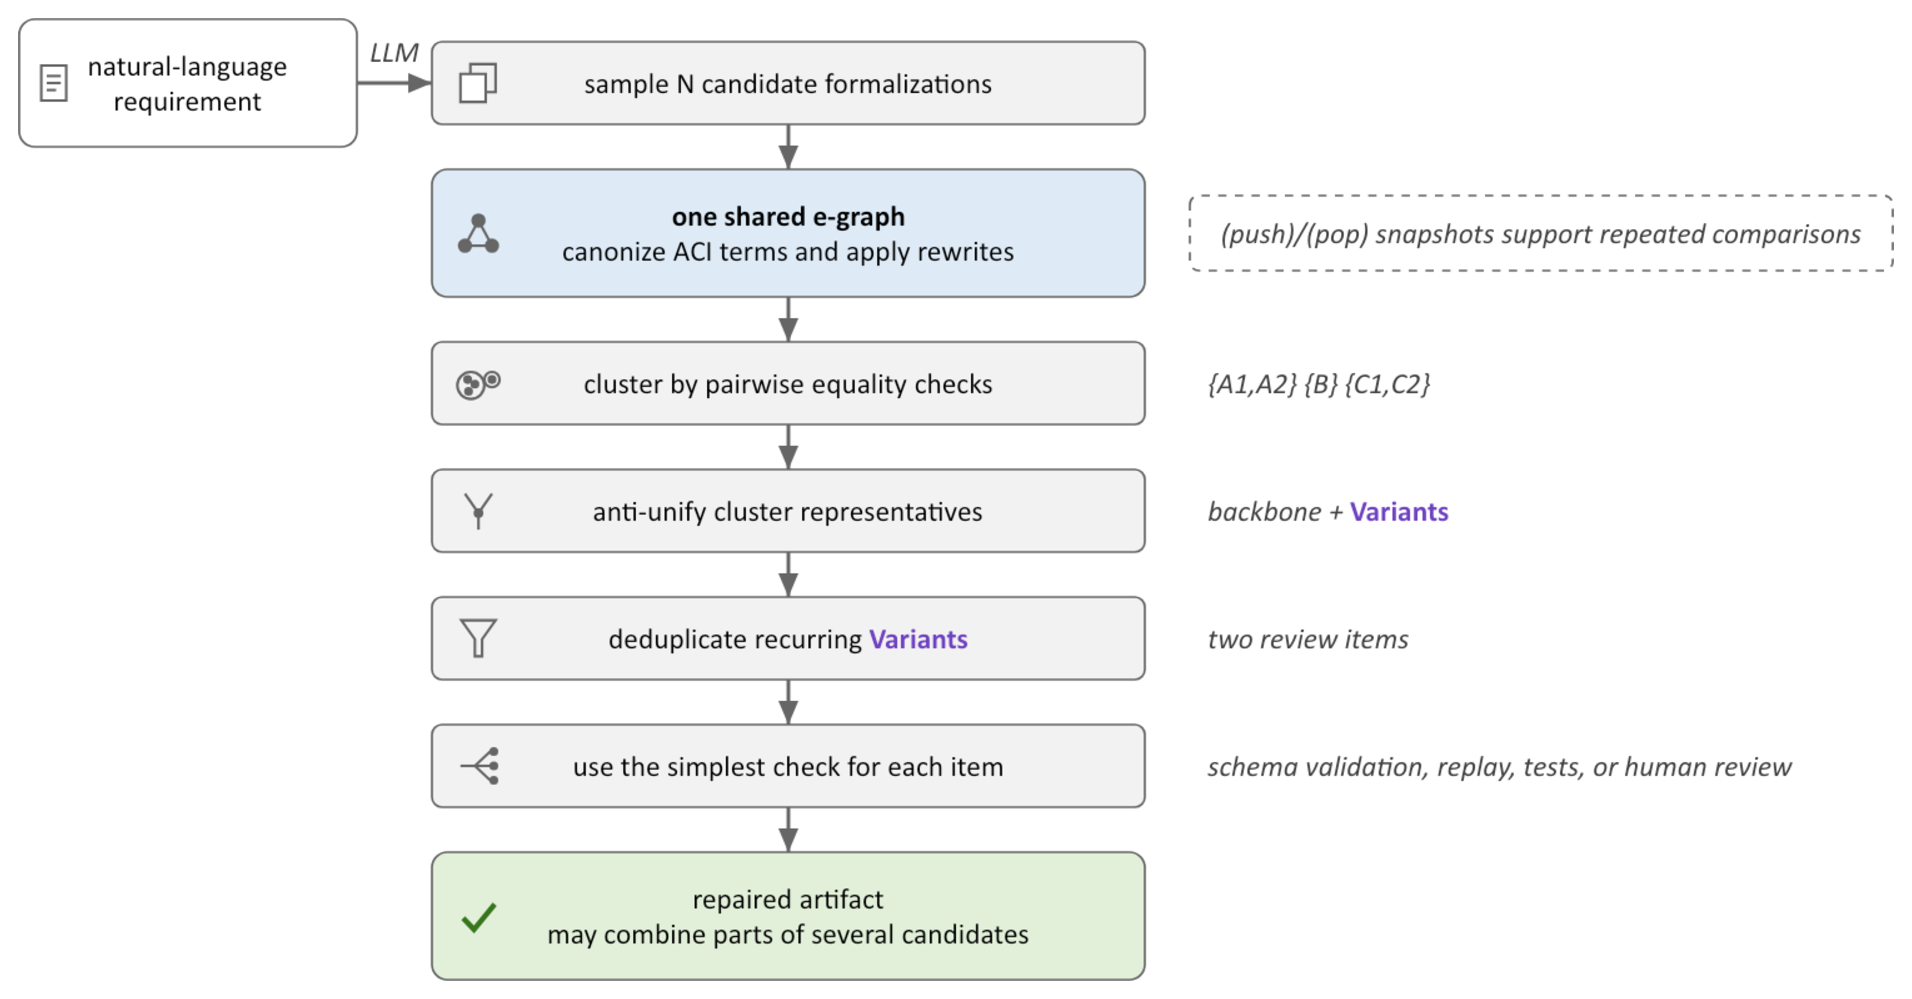
Під час перегляду коду, використання текстових відмінностей між файлами може бути оманливим через синтаксичні зміни, які не впливають на значення. Семантична різниця, обчислена за допомогою анти-об'єднання, визначає спільні частини та розбіжності між політиками. Це корисно при генерації формальних мовних моделей з природної мови або порівнянні різних форматів політик, таких як Cedar, Dogwood аб...
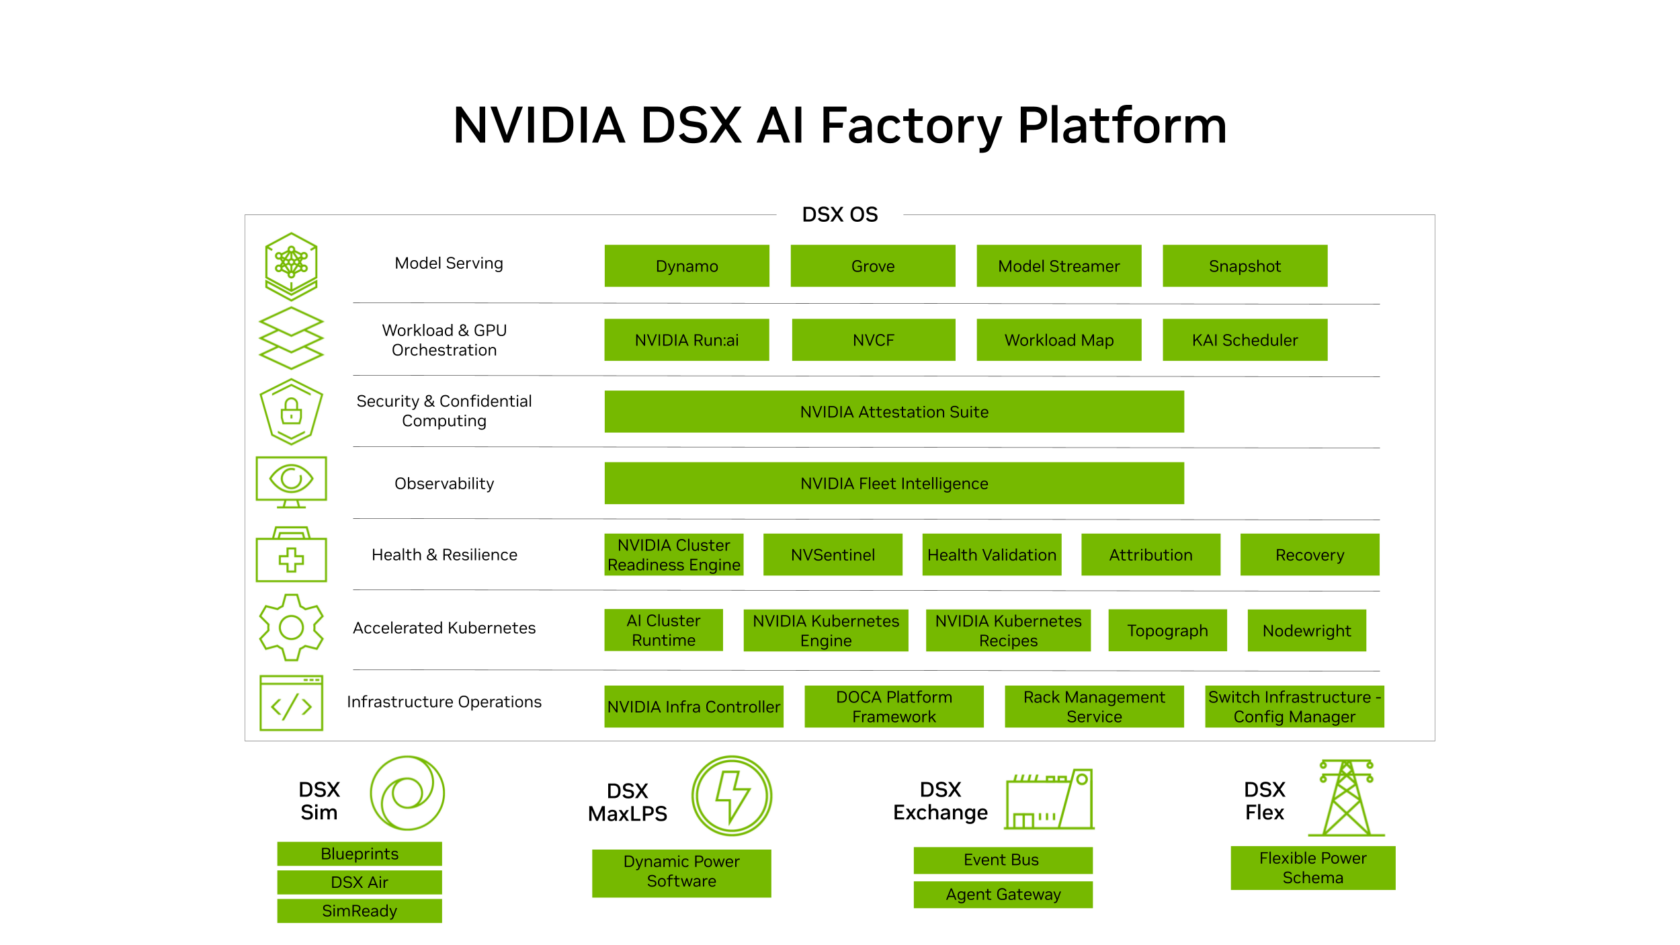
NVIDIA посилює свою підтримку системи Kubernetes з відкритим вихідним кодом, яка керує додатками в тисячах центрів штучного інтелекту, представляючи нові інструменти для підвищення безпеки та масштабованості на конференції KubeCon + CloudNativeCon. NVIDIA передає у фонд Cloud Native Computing Foundation (CNCF) NVIDIA OpenShell – платформу з відкритим вихідним кодом для забезпечення безпеки та у...
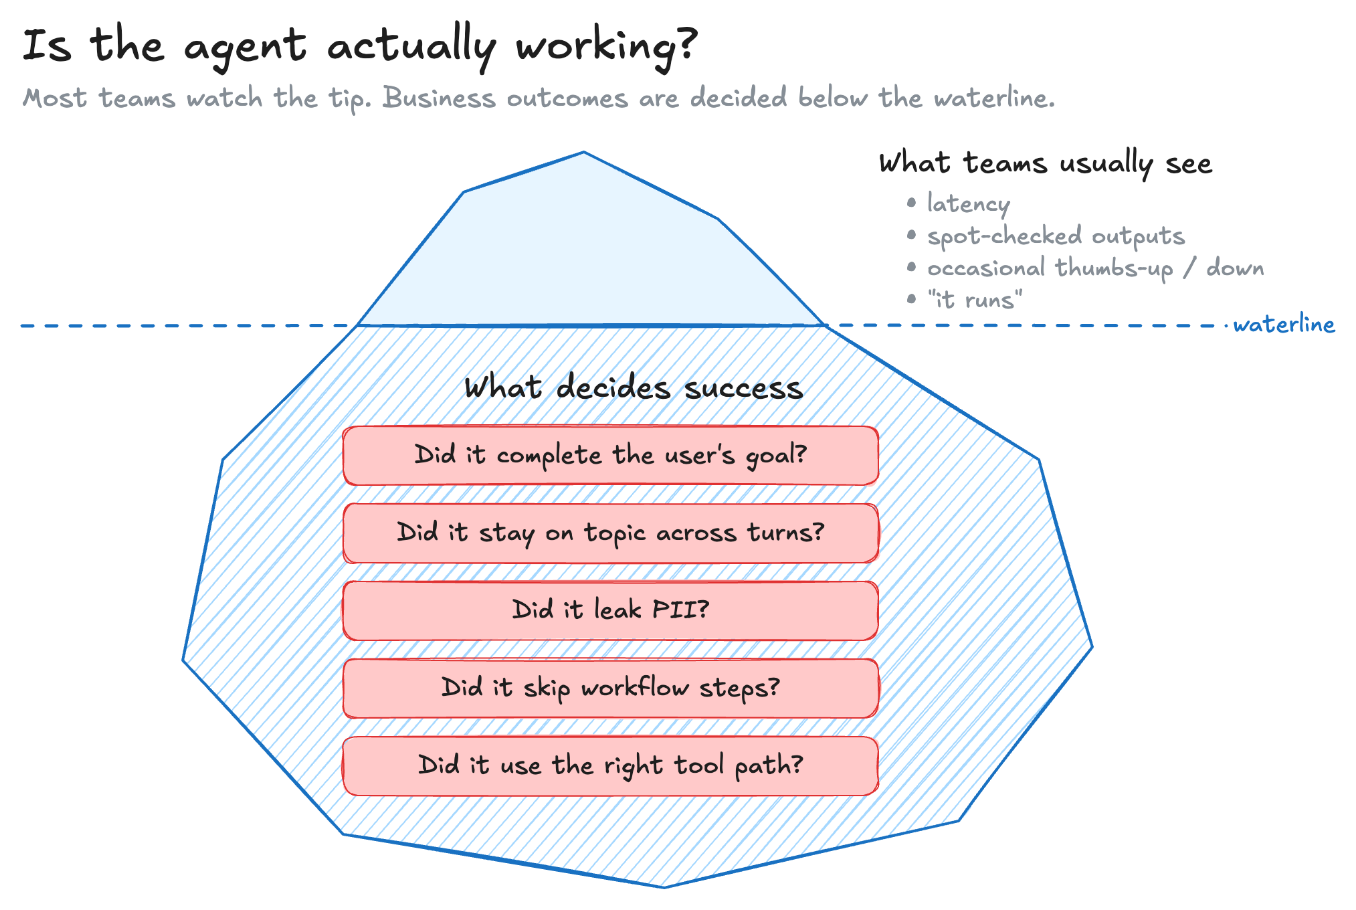
При розгортанні агента в робочому середовищі, забезпечення того, щоб він ефективно задовольняв бізнес-вимоги у великих масштабах, є поширеною проблемою. Команди часто орієнтуються на поверхневі показники, такі як відсоток завершення та затримка, але ці показники не дають інформації про те, чи агент завершує завдання, дотримується теми, не розголошує персональні дані або точно виконує запланован...
У даному дослідженні автор аналізує продуктивність двох методів кодування для моделей машинного навчання на основі дерев, зосереджуючись на градієнтному бустингу регресії з використанням слабких навчальних моделей у вигляді дерев рішень. Перший метод, який називається "надзвичайно простий", використовує порядкове кодування для категоріальних змінних. Другий метод, названий "складний", використо...
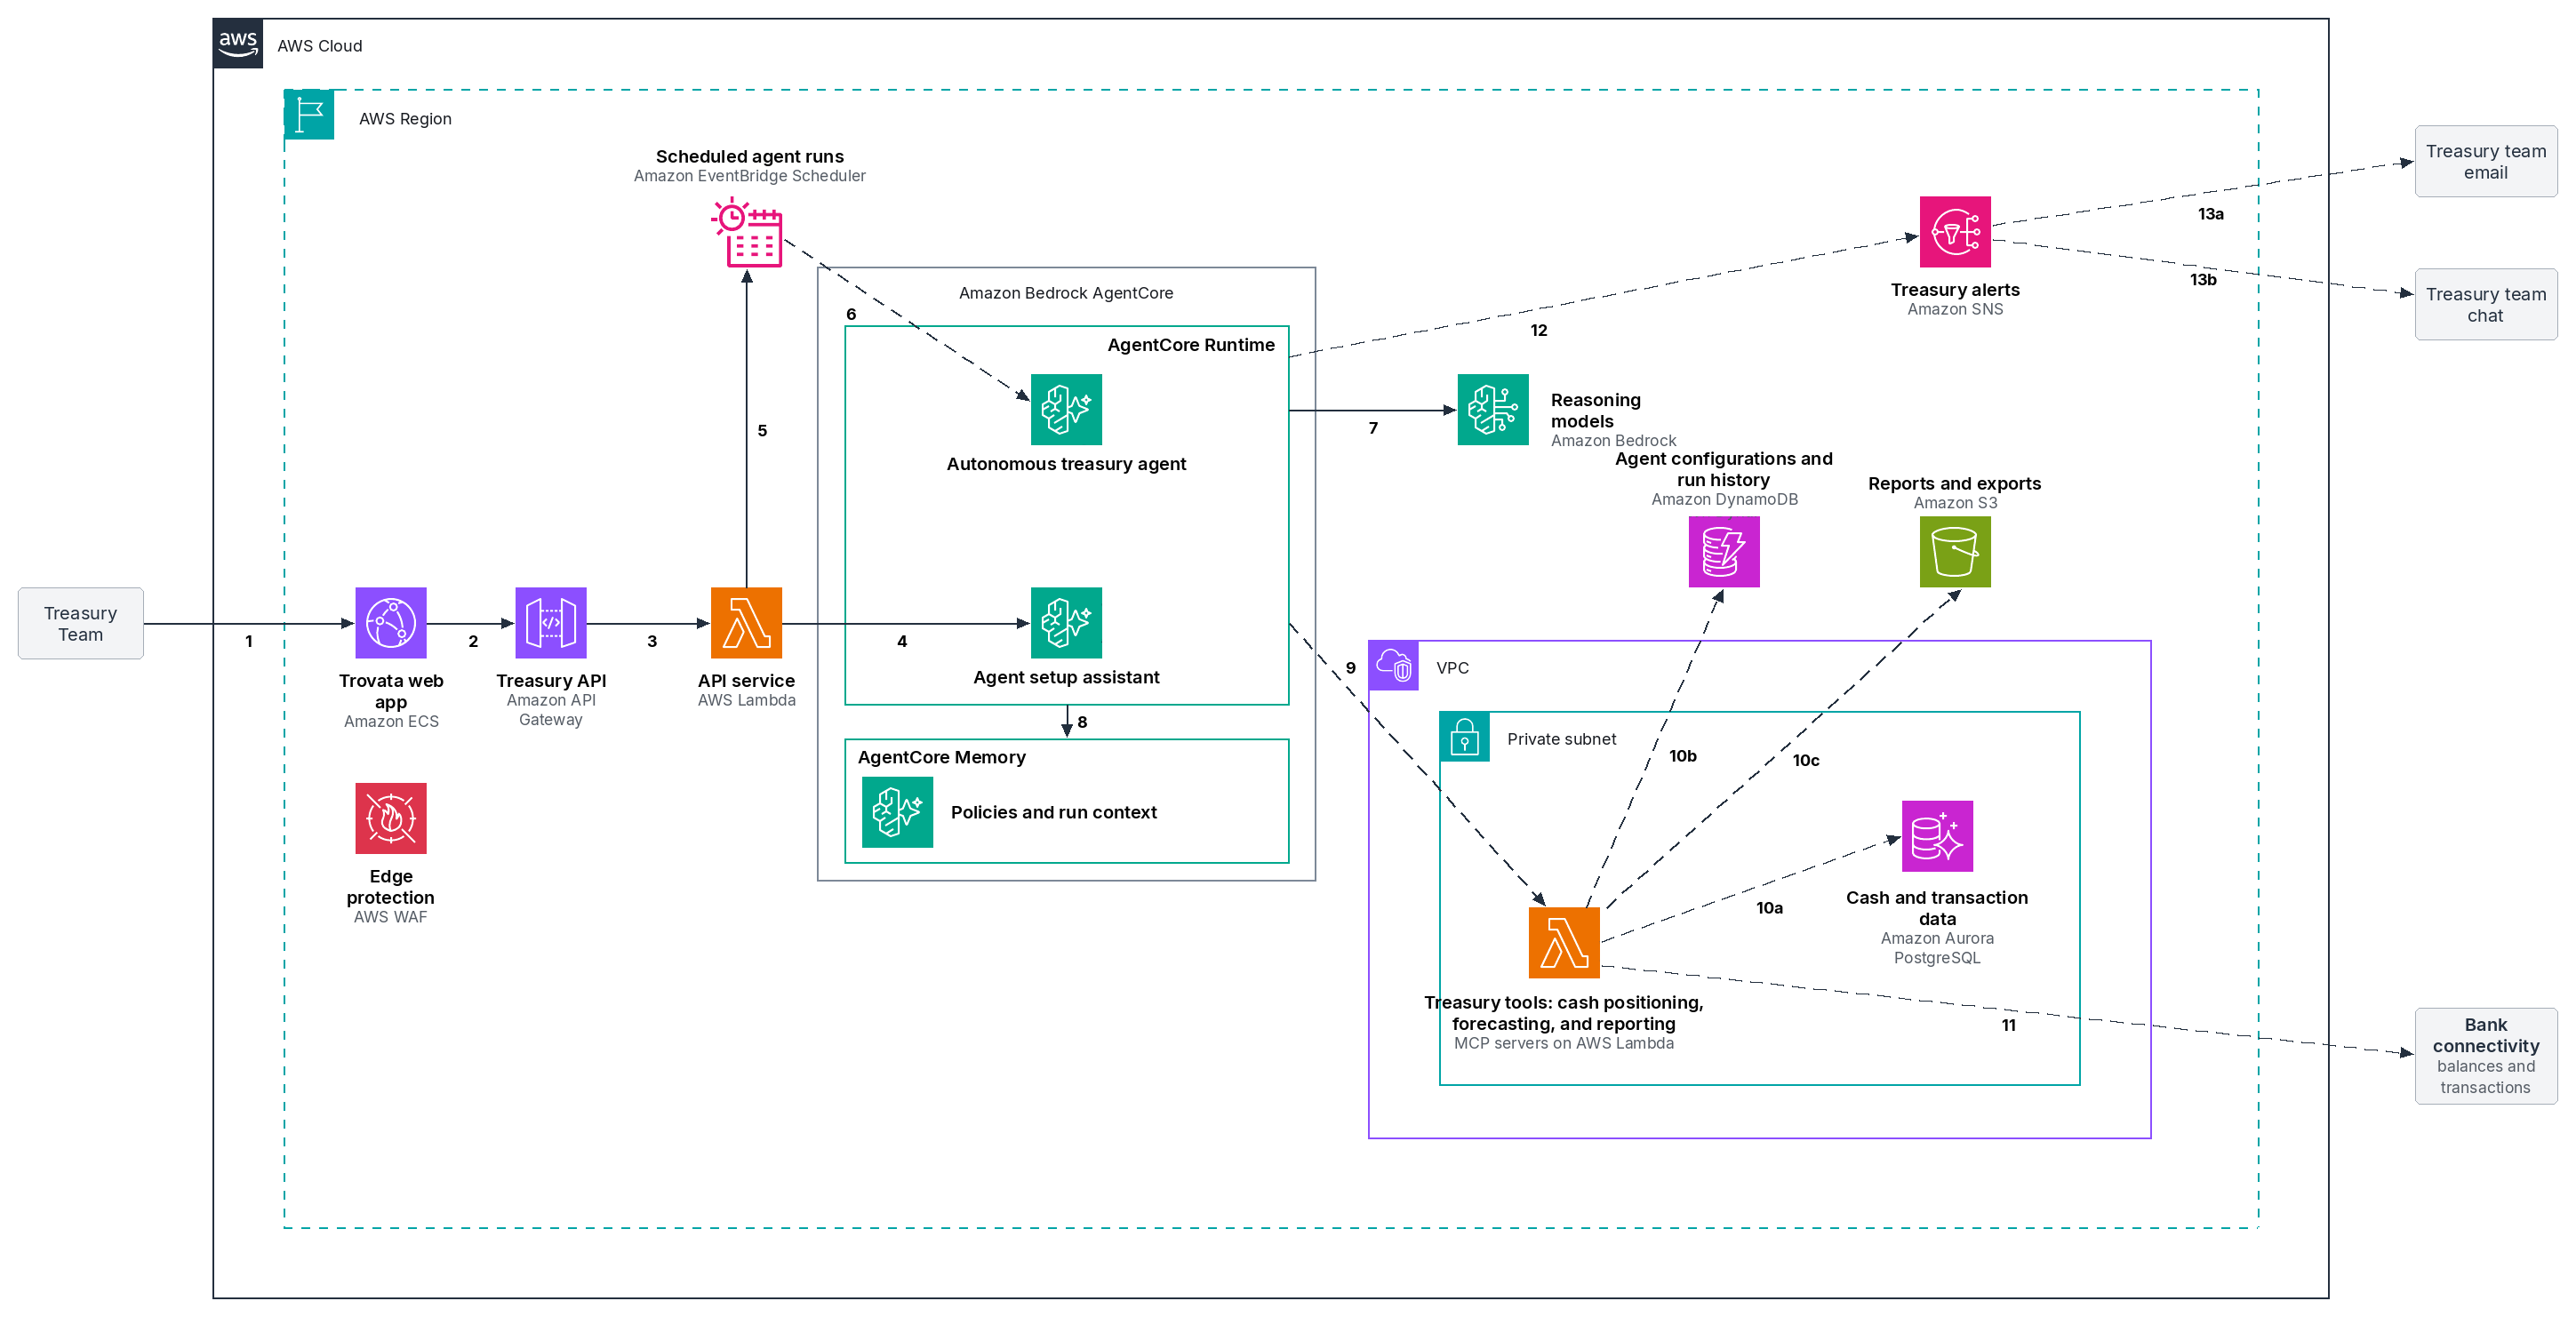
Trovata – це платформа на основі штучного інтелекту для управління корпоративними грошовими коштами та ліквідністю, яка забезпечує прямий доступ до понад 10 000 банків через єдину систему. Команди фінансових відділів стикаються з проблемами фрагментованих даних про банки, ручного звітування та застарілих систем управління фінансами (TMS). Інноваційне рішення Trovata вирішує ці проблеми, предста...
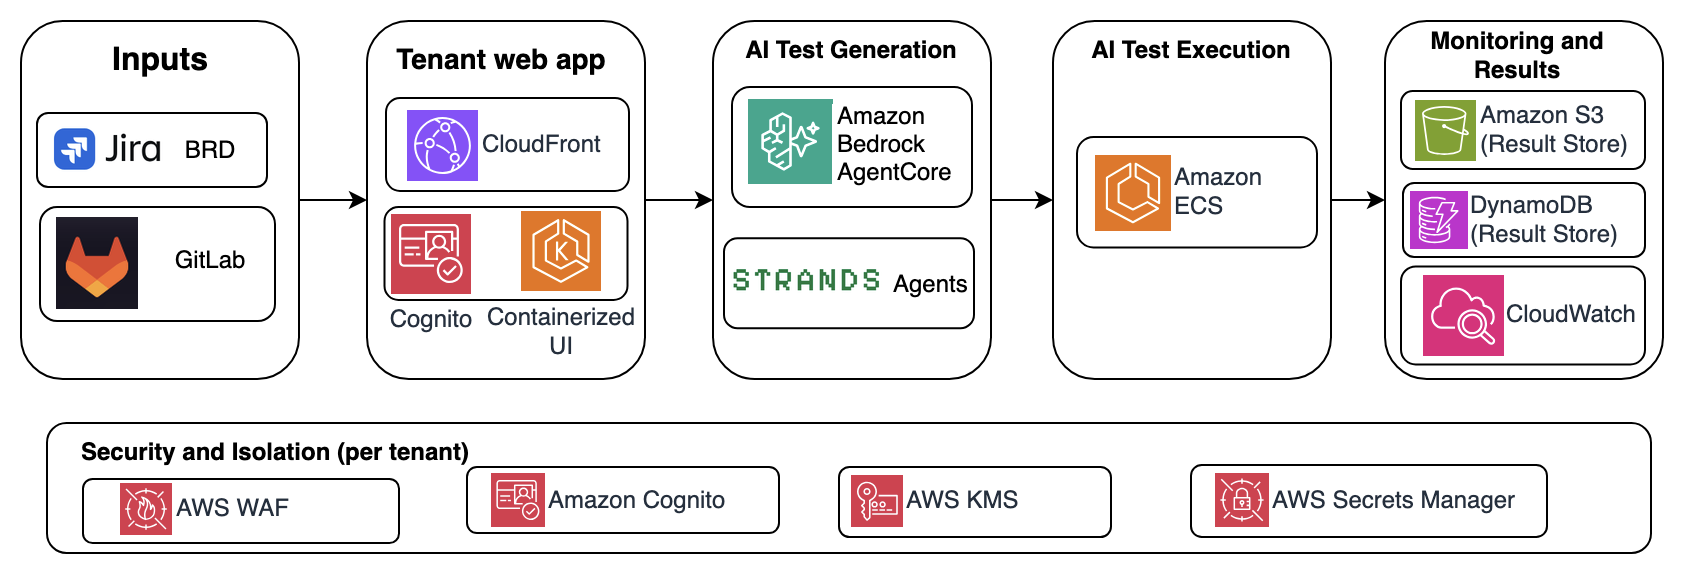
Компанія Tata Consultancy Services (TCS) виявила, що для клієнтів у сферах банківського обслуговування, фінансових послуг та страхування (BFSI) найповільнішою частиною процесу розробки є не написання коду програми, а ланцюжок робіт, який слідує за цим. Це включає інтерпретацію вимог, проєктування сценаріїв, написання та підтримку автоматизації, підготовку середовищ виконання, дослідження помило...
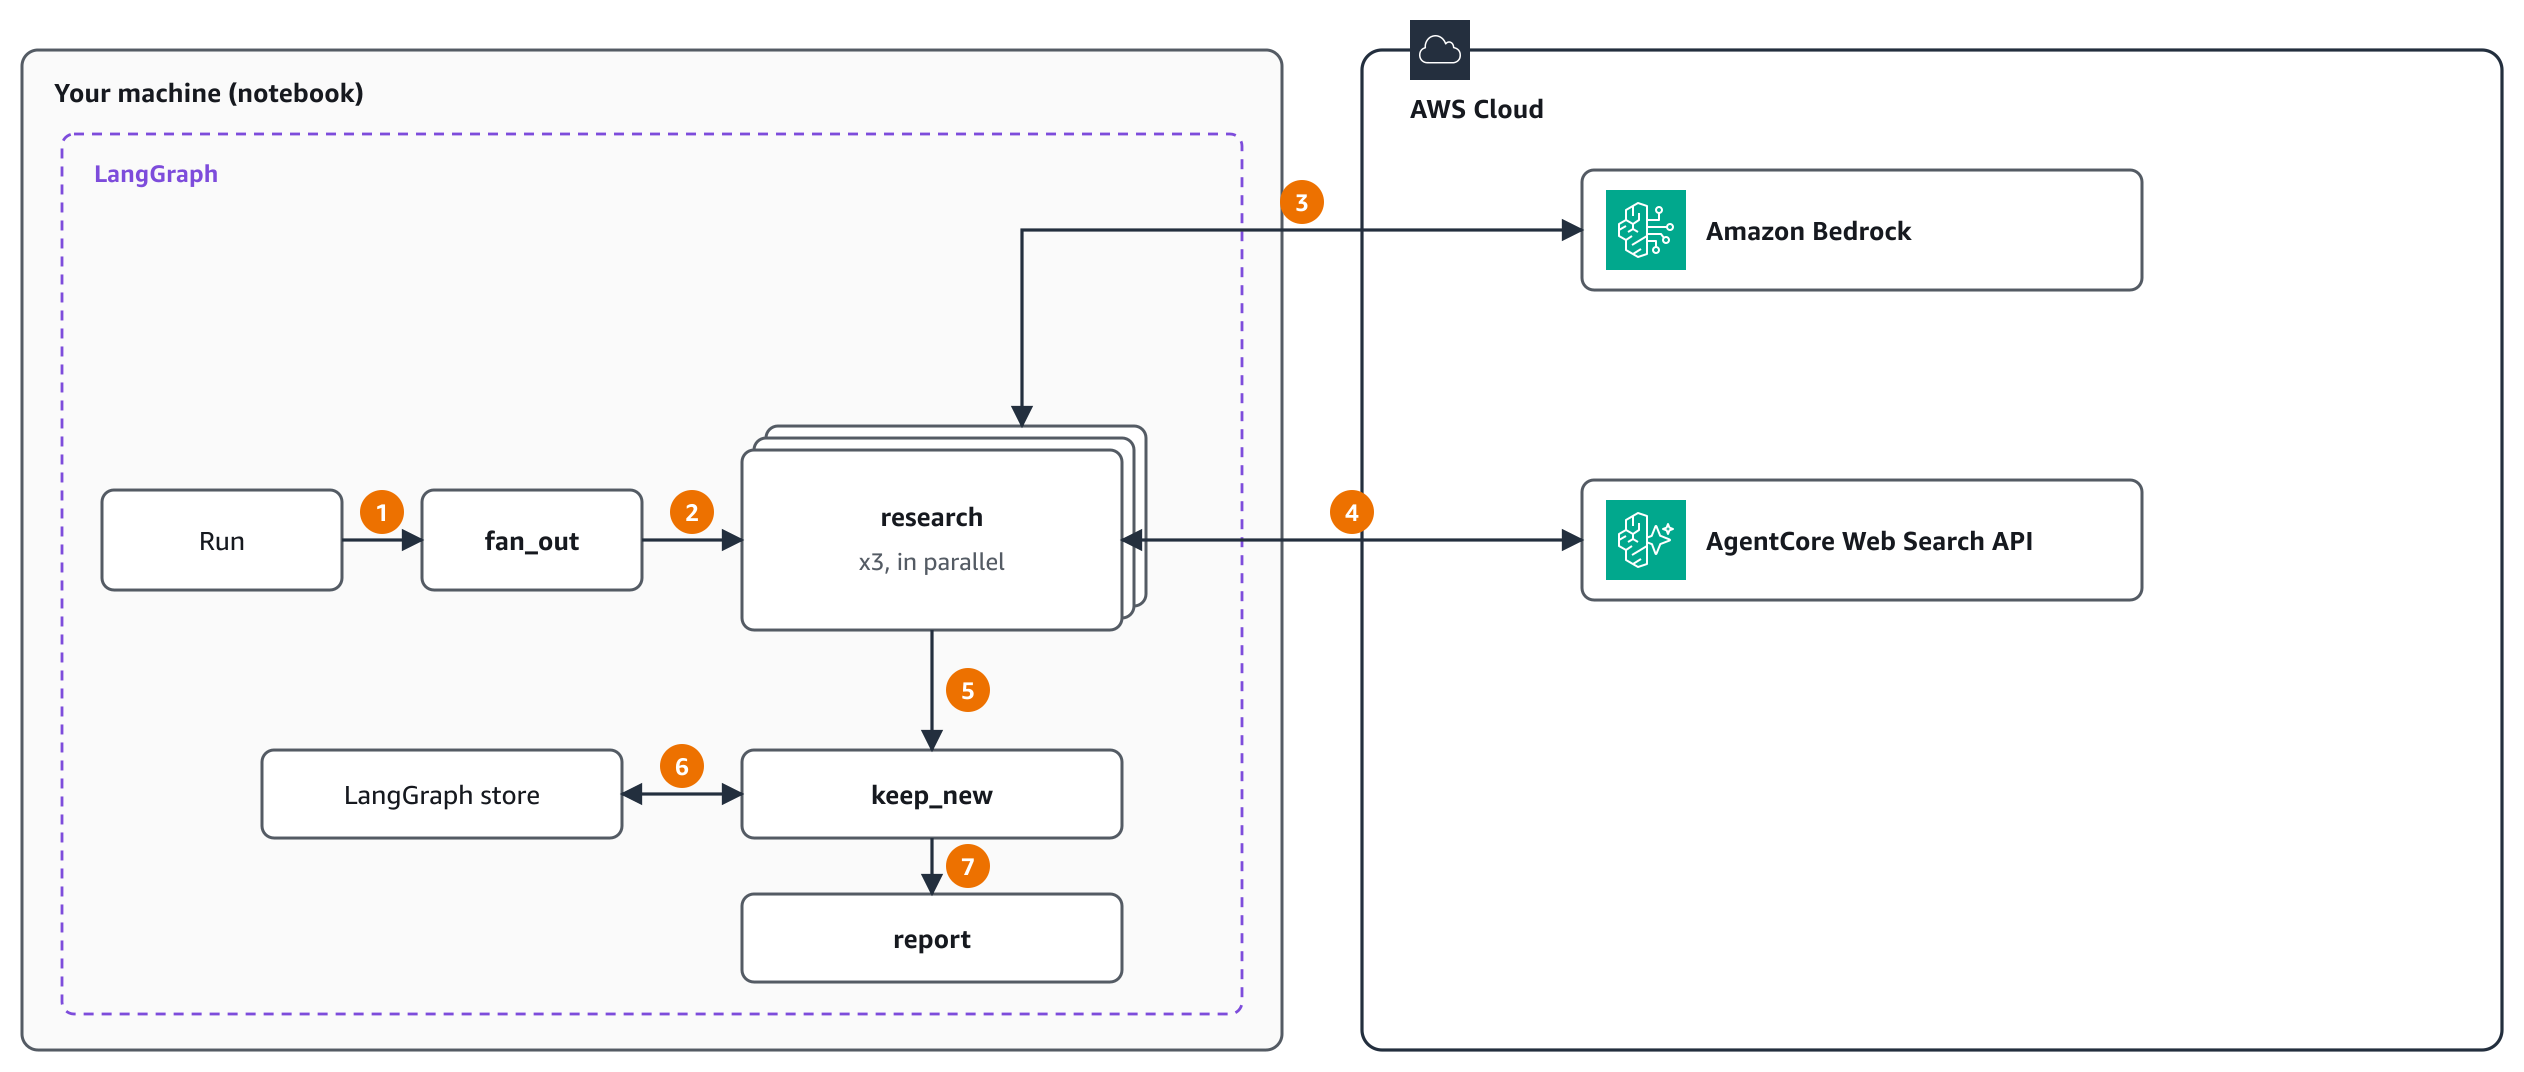
У цьому огляді ми зосереджуємось на новій функції Amazon Bedrock AgentCore – Web Search API. Цей API дозволяє AI-агентам отримувати доступ до актуальних результатів вебпошуку за допомогою одного виклику API, використовуючи їхні існуючі облікові дані AWS. Результати включають заголовки, URL-адреси, дати публікації та фрагменти тексту, що відповідають запиту. Користувачі також можуть вказувати об...
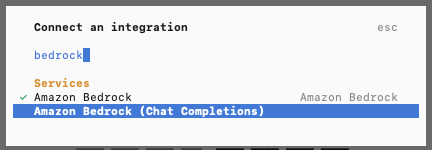
Нова версія моделі Kimi K3.1 від Moonshot AI, яка отримала назву Kimi K3.1 Pro Highspeed, тепер доступна на платформі Amazon Bedrock. Ця оновлена модель, що має ту ж відкриту архітектуру та контекстне вікно, покращена завдяки додатковим обчисленням після навчання, що дозволяє їй краще справлятися з задачами, що потребують довгострокового аналізу, і зменшує кількість фактичних помилок. Вона розш...
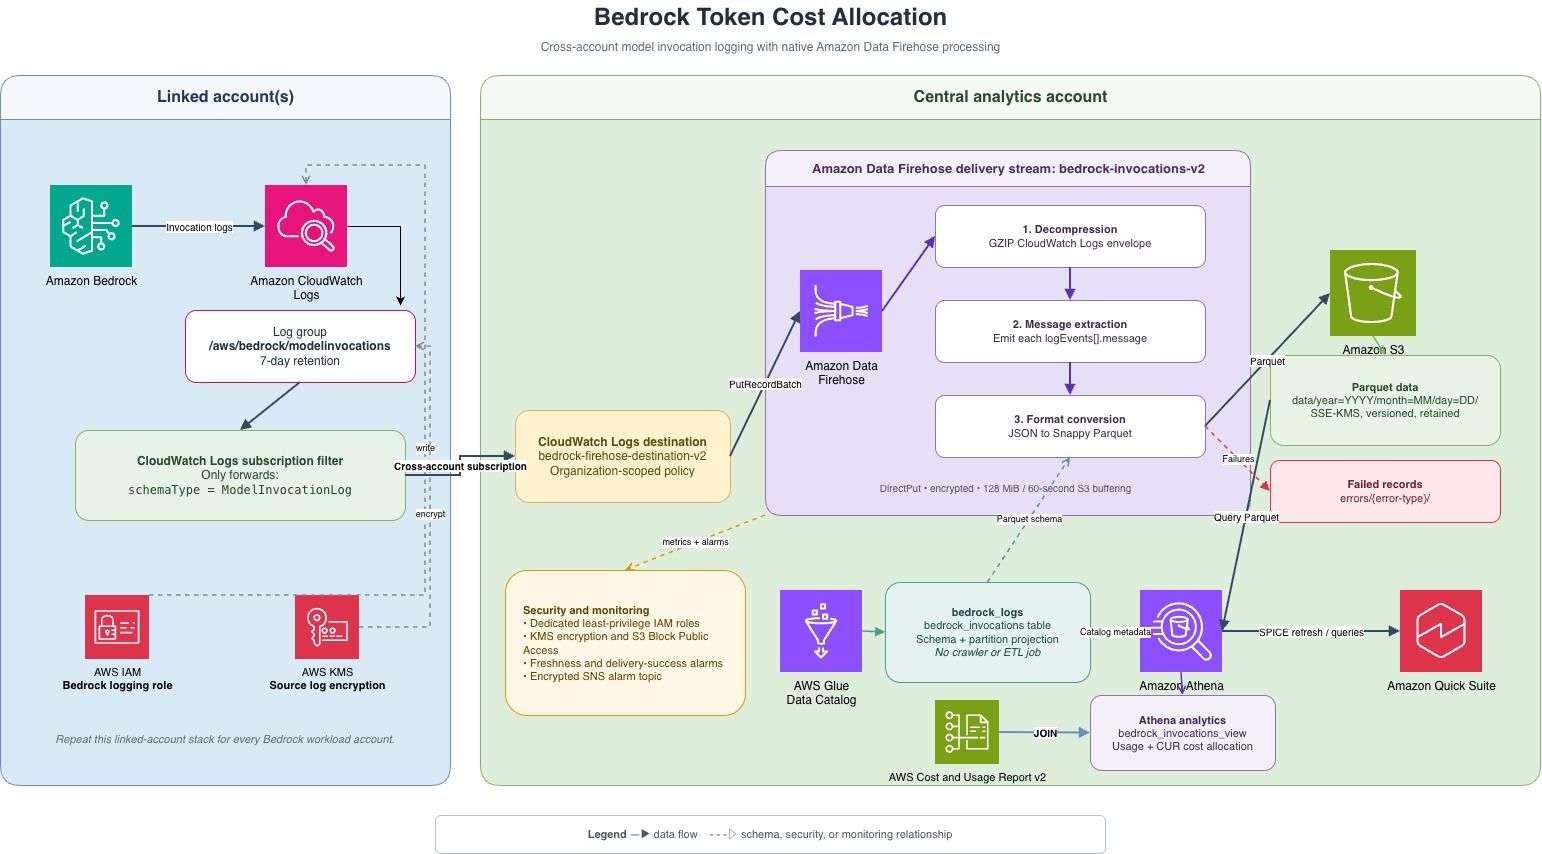
У цьому огляді я опишу рішення для потреб у сховищі даних моніторингу в робочих процесах Amazon Bedrock. Коли щодня виконується велика кількість викликів моделей на різних облікових записах, стає складно зрозуміти, що сталося після надсилання запиту. Виникають питання щодо того, який саме промпт було використано, відповідь моделі, використання токенів, обробка моделі та якість відповіді. Для ін...
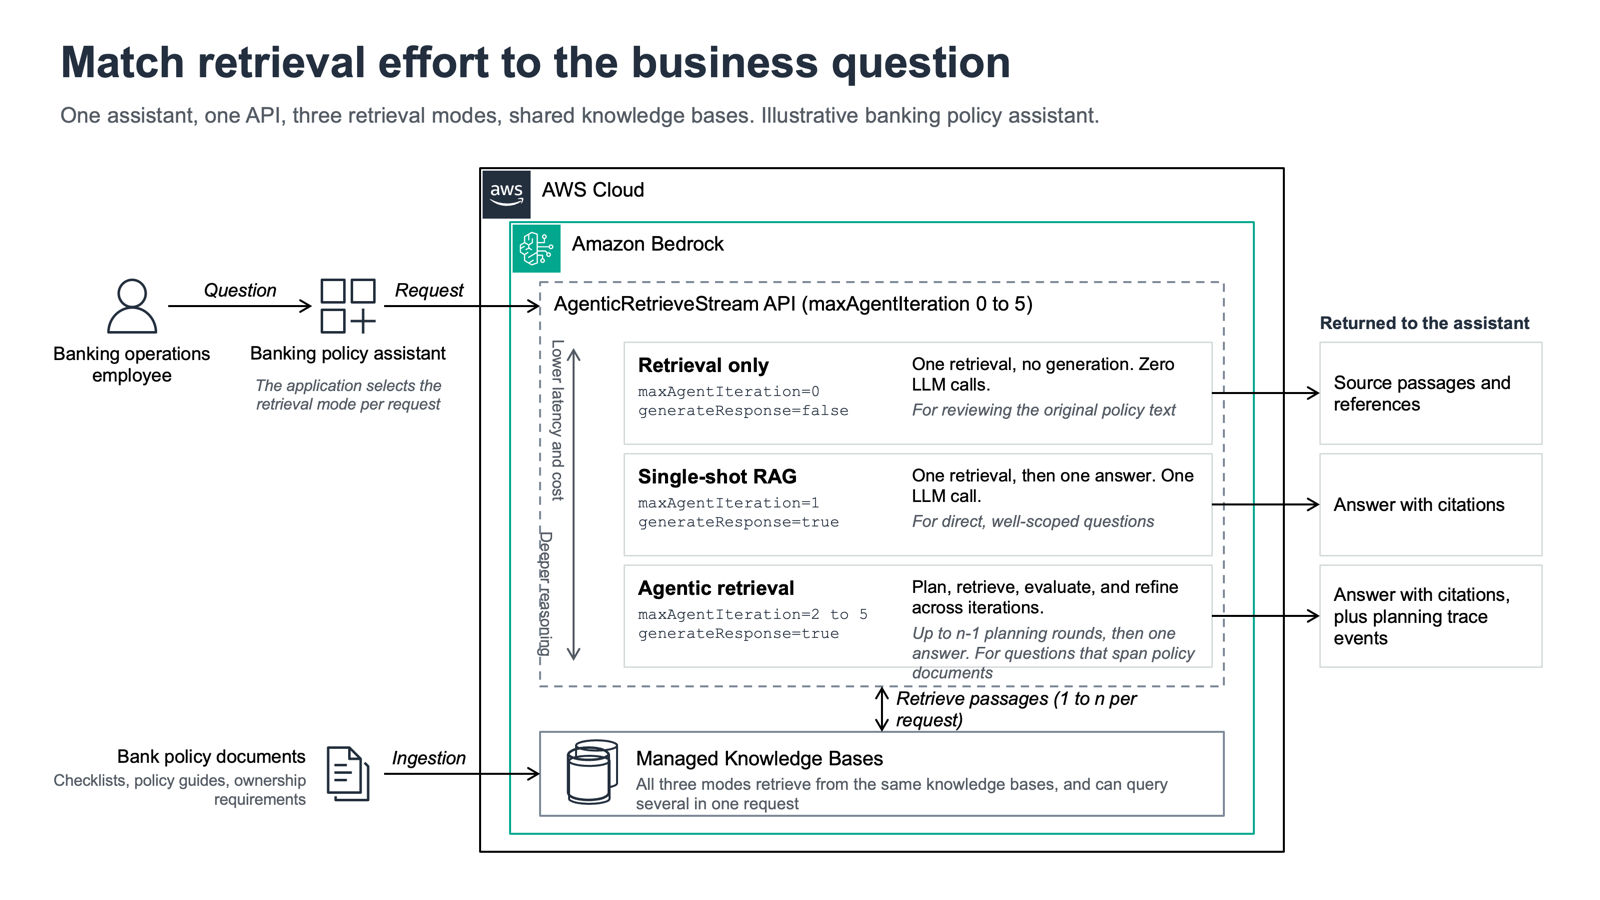
Внутрішній AI-асистент у контексті банківських операцій допомагає співробітнику з двома різними типами інформаційних запитів. Для перегляду контрольних списків асистент використовує технологію Retrieval Augmented Generation (RAG) від Amazon Bedrock Managed Knowledge Base, що дозволяє отримати швидку та однозначну відповідь. Для порівняння різних видів підприємств – індивідуальних підприємців, т...
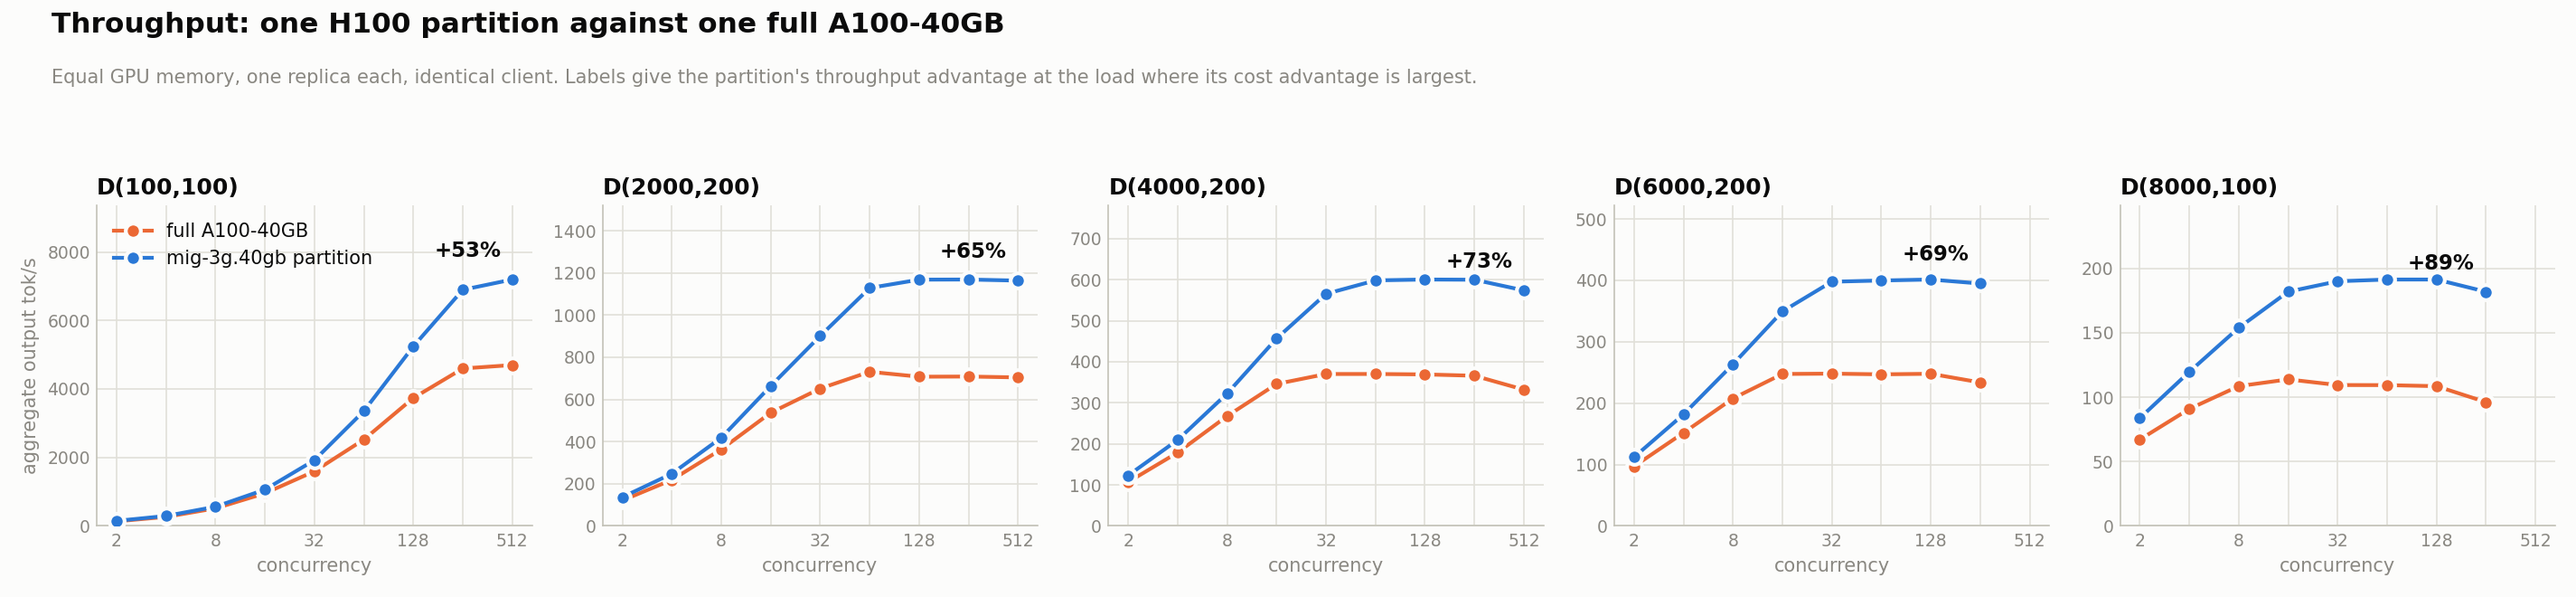
При розгортанні моделей машинного навчання на платформі Amazon SageMaker Inference з використанням графічних процесорів (GPU), найменша доступна одиниця – це цілий прискорювач. Це обмеження обмежує кількість моделей, які можна розмістити на одному сервері, і вимагає використання повного GPU на старому сервері для моделей з меншими вимогами до ресурсів, або нового сервера з надлишковою потужніст...
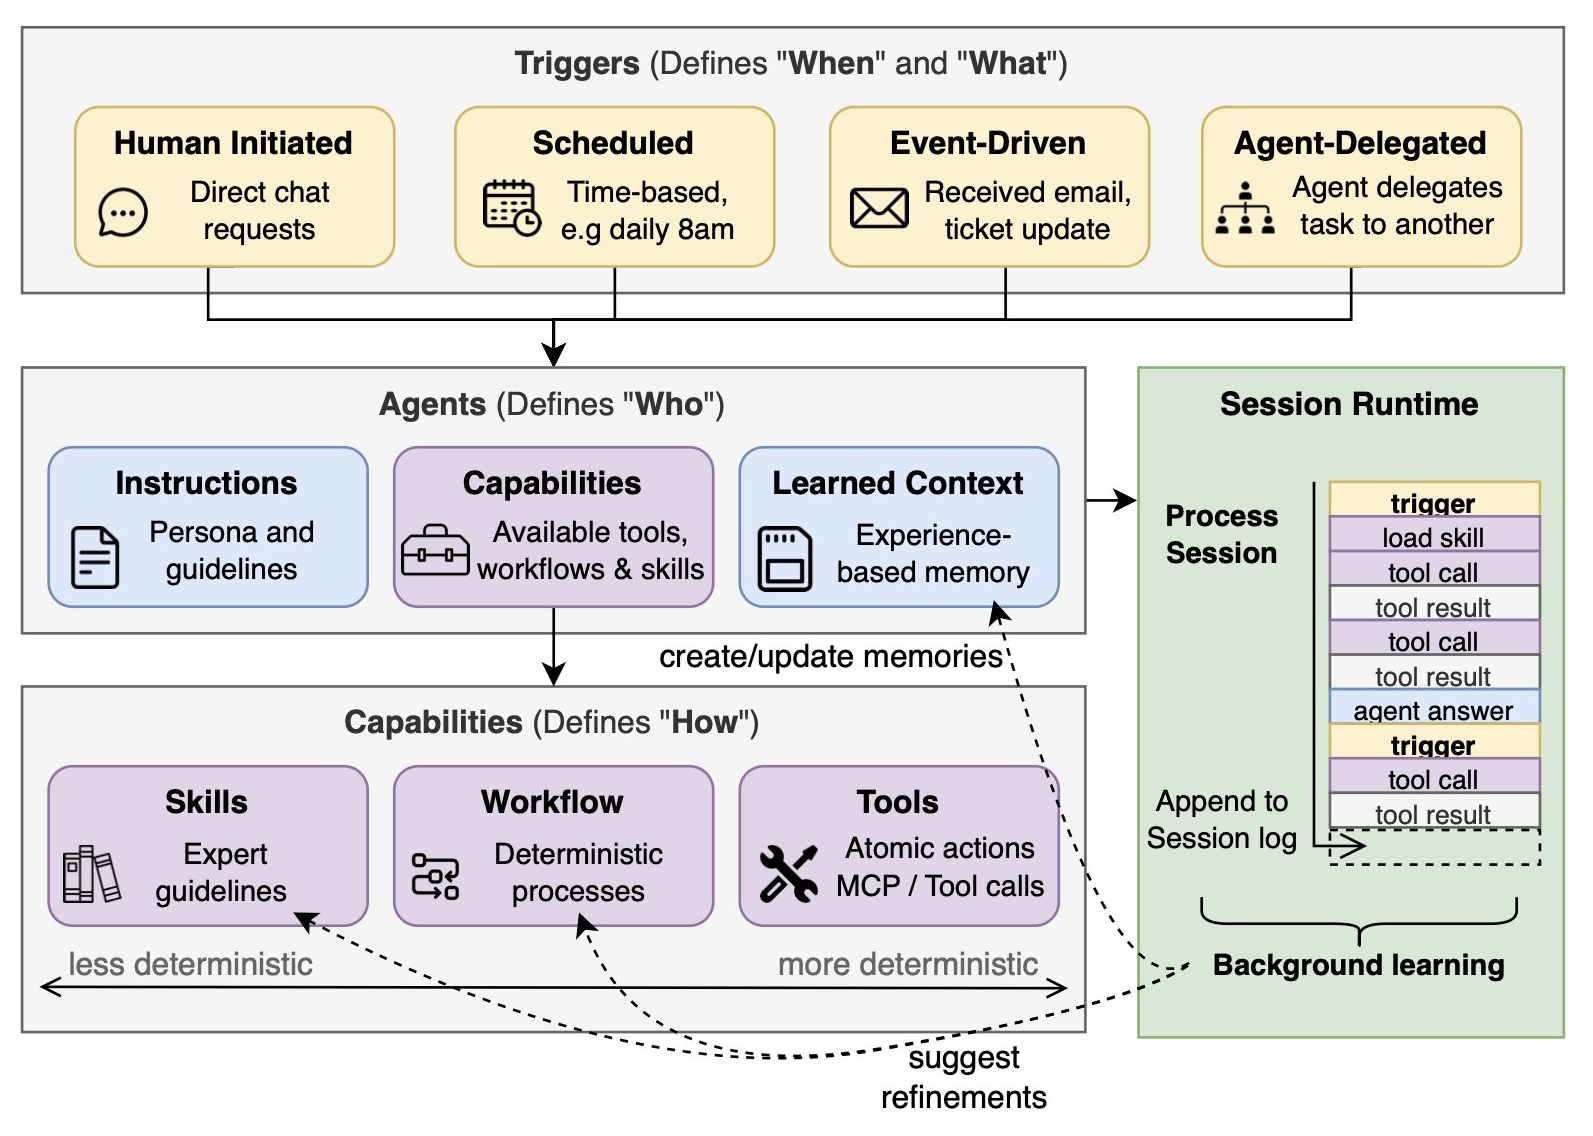
У цій статті автори розповідають про свій досвід створення AWS Quick – системи, яка еволюціонувала від простого відповідання на запитання до виконання дій. Вони також описують проблеми, з якими зіткнулися через відсутність загальної термінології для базових елементів у агентній роботі. Автори пропонують класифікацію агентної роботи, засновану на питаннях: Коли, Що, Хто та Як. Тригери, механізм ...