
Компанії, що займаються розробкою штучного інтелекту, прагнуть досягти великих звершень, але необхідна для цього енергія загрожує екологічним цілям. Чи вдасться вчасно вирішити енергетичну проблему штучного інтелекту? Про це розповідають Джилліан Амброуз та Алекс Херн з Guardian.
Системи рекомендацій зі штучним інтелектом чудово пропонують схожі продукти, але мають проблеми з взаємодоповнюючими. Фреймворк zeroCPR пропонує доступне рішення для виявлення взаємодоповнюючих продуктів за допомогою технології LLM.

Mixbook, сервіс фотокниг №1 у США, використав AWS для персоналізації фотокниг за допомогою генеративного ШІ. Mixbook Smart Captions творчо інтерпретує фотографії користувачів, покращуючи розповідь і створюючи спогади без особливих зусиль.

Проект VerifAI, що фінансується ЄС, створює унікальну генеративну пошукову систему для біомедичної галузі з використанням LLM. Фокус на виявленні галюцинацій відрізняє його від інших продуктів на основі RAG, вирішуючи проблему оманливого тексту.

Технічний директор Microsoft Кевін Скотт підкреслює потенціал законів масштабування великих мовних моделей у розвитку штучного інтелекту. Скотт зіграв вирішальну роль в угоді про обмін технологіями між Microsoft і OpenAI вартістю 13 мільярдів доларів, підкресливши вплив збільшення розміру моделі та навчальних даних на можливості ШІ.

Квантильне прогнозування передбачає екстремуми розподілу для кращого прийняття рішень у таких секторах, як фінанси та управління ланцюгами поставок. Tensorflow, NeuralForecast і Zero-shot LLM пропонують передові моделі для точних квантильних оцінок, що підвищують операційну ефективність.
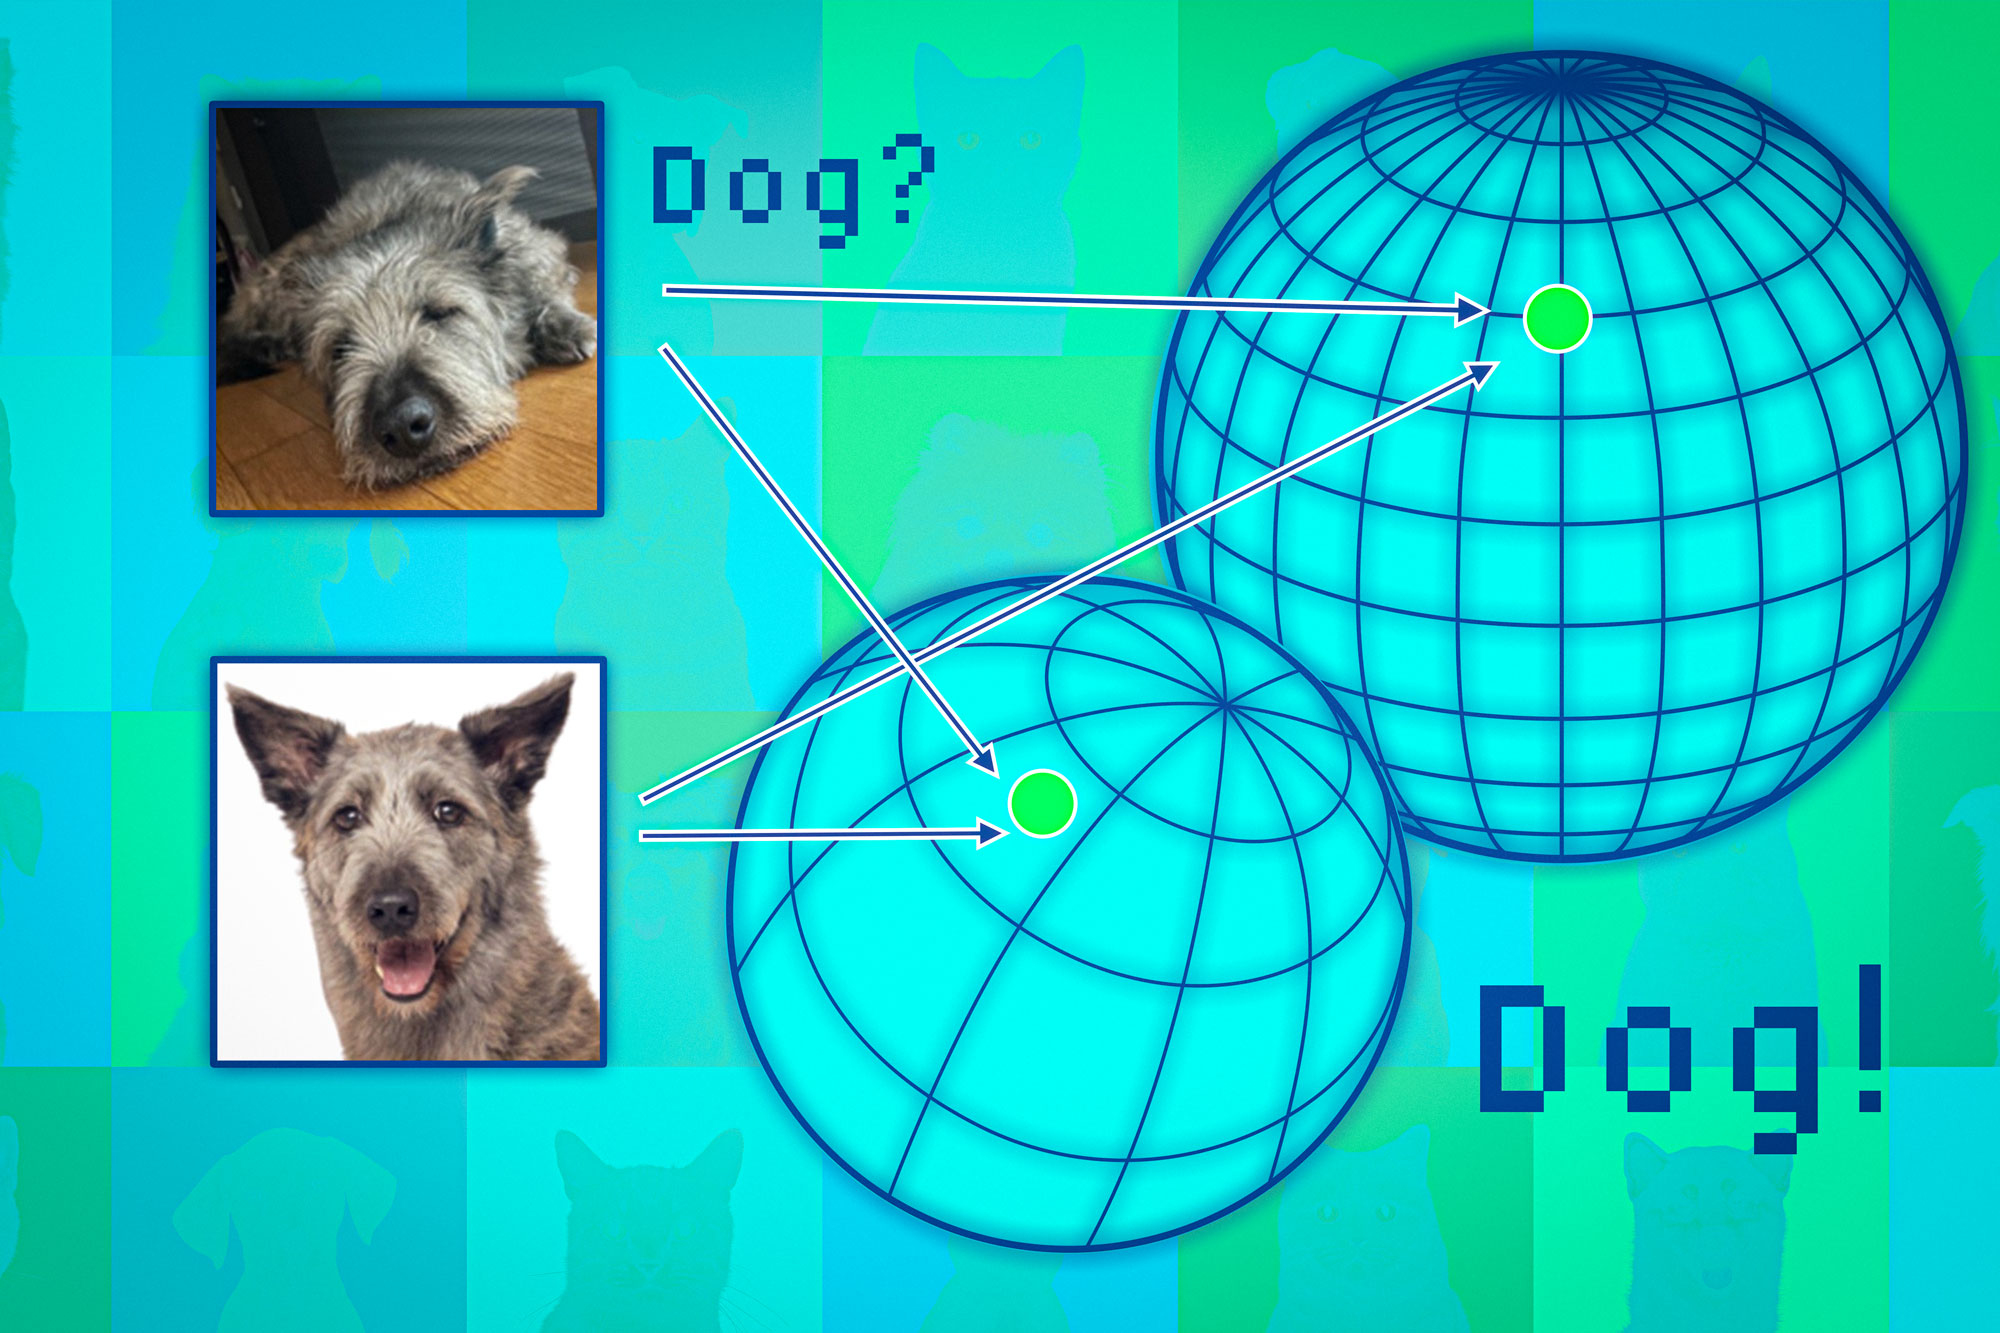
Дослідники з Массачусетського технологічного інституту та лабораторії штучного інтелекту MIT-IBM Watson AI Lab розробили методику оцінки надійності фундаментальних моделей, таких як ChatGPT і DALL-E, перед розгортанням. Навчивши набір дещо різних моделей і оцінивши їхню узгодженість, вони можуть ранжувати моделі на основі показників надійності для різних завдань.

Дубляж відео необхідний для подолання мовних бар'єрів в індустрії медіа та розваг. MagellanTV співпрацює з Mission Cloud, щоб революціонізувати автодублювання відео за допомогою Amazon Translate та Bedrock.

Проект, що використовує набір даних UCI Email Spam Dataset з 4,601 рядків і 57 стовпців значень предикторів. Утиліта збирає тестові дані для програм машинного навчання.

Викривачі OpenAI домагаються розслідування обмежувальних контрактів, які вимагають дозволу на контакт з регуляторними органами, що потенційно може придушити занепокоєння щодо компанії. Угоди про нерозголошення в OpenAI перебувають під пильною увагою на предмет потенційних наслідків для співробітників, які порушують питання перед федеральними органами влади.

Рене ДіРеста, колишня керівниця Стенфордської інтернет-обсерваторії, у своїй новій книзі заглиблюється в питання інтернет-пропаганди. Вона висвітлює еволюцію пропаганди та її вплив на суспільство, наголошуючи на необхідності більш точного діагнозу цієї проблеми.

Динамічне програмування та алгоритми Монте-Карло зливаються в навчанні з підкріпленням. Алгоритми часових різниць поєднують переваги обох алгоритмів, оновлюючи стани через n часових кроків.

Пілотна схема базового доходу в Ірландії забезпечує художниці Елінор О'Донован гарантовану зарплату, що дозволяє їй повністю зосередитися на мистецтві. Гарантований дохід набуває популярності як рішення проблеми впливу штучного інтелекту, заохочуючи до більш корисної роботи.

Зброя зі штучним інтелектом набуває все більшого поширення у військовому застосуванні, а такі компанії, як Elbit Systems, лідирують у розробці смертоносних автономних дронів. Галузь процвітає, оскільки оборонні компанії демонструють свої досягнення в галузі ШІ-технологій для бойових цілей.
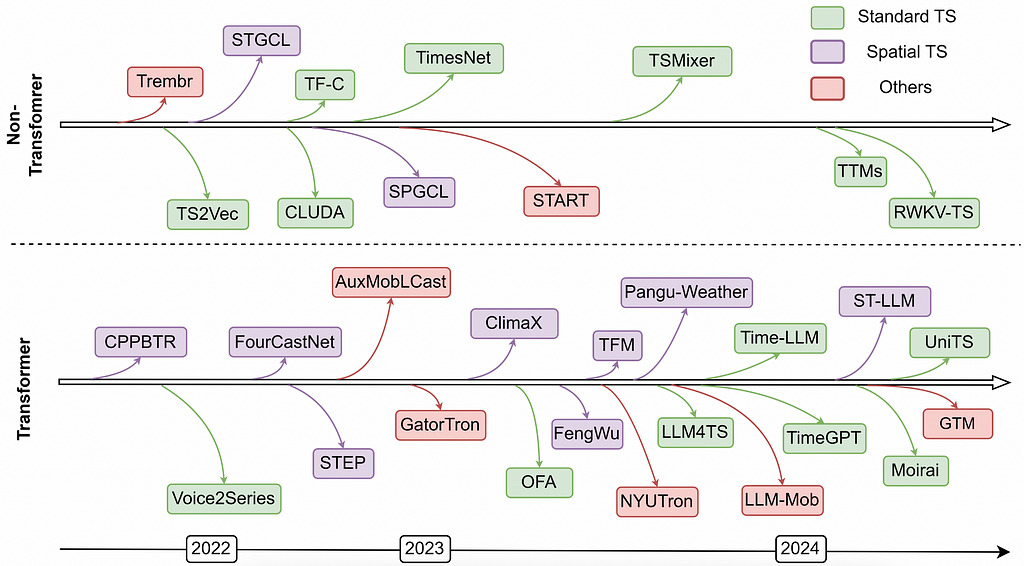
Фундаментальні моделі, такі як великі мовні моделі (LLM), адаптуються для моделювання часових рядів за допомогою великих фундаментальних моделей часових рядів (LTSM). Використовуючи подібність послідовних даних, LTSM має на меті навчатися на різноманітних даних часових рядів для таких завдань, як виявлення та класифікація викидів, спираючись на успіх LLM в обчислювальній лінгвістиці.