
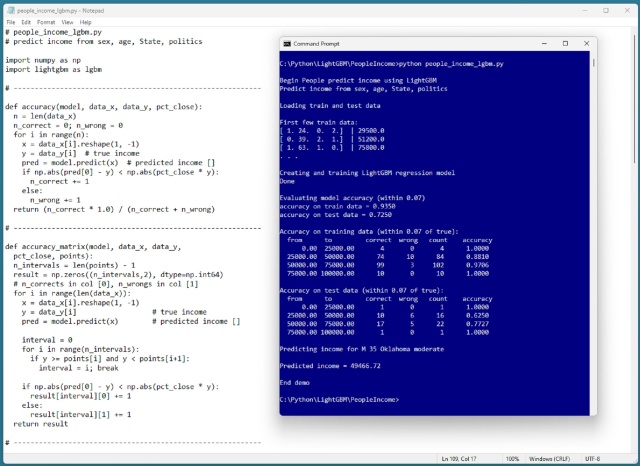
Регресійна модель LightGBM прогнозує дохід з точністю до інтервалу, демонструючи ефективність моделі на синтетичних даних. Модель демонструє точність для різних діапазонів доходу, підкреслюючи важливість визначення близькості цільового значення для правильного прогнозування.
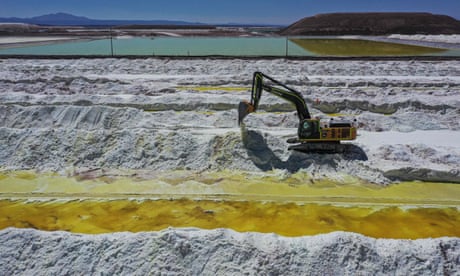
Центри обробки даних великих технологій є основними джерелами глобальних викидів парникових газів, затьмарюючи комерційні рейси. Маріана Маццукато закликає ретельно вивчити вплив технологій на навколишнє середовище, звертаючи увагу на енергоємні технології, такі як ChatGPT.

Основні висновки для науковців та менеджерів з даних: 1. Розкажіть історію, використовуючи дані, адаптовані до вашої аудиторії. 2. Ділова хватка відрізняє хороших аналітиків даних від чудових, забезпечуючи максимальний вплив на стейкхолдерів.
Найбільші технологічні компанії, такі як Google, Microsoft і Meta, об'єдналися в групу UALink, щоб розробити новий стандарт з'єднання чіпів для прискорювачів ШІ, кинувши виклик домінуванню NVLink від Nvidia. UALink має на меті створити відкритий стандарт для вдосконалення апаратного забезпечення ШІ, уможливити співпрацю та звільнитися від пропрієтарних екосистем, подібних до екосистеми Nvidia.
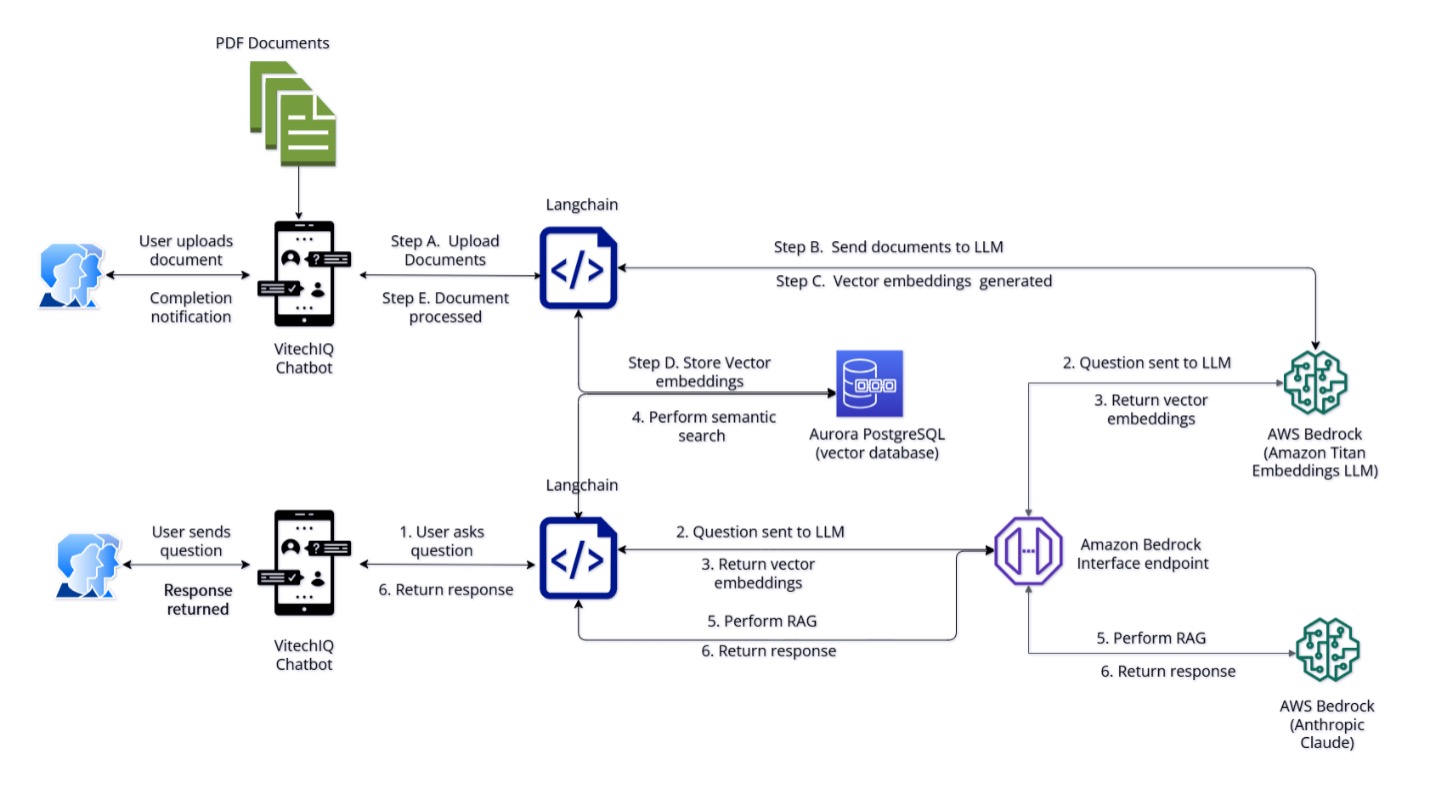
Vitech співпрацює з Amazon Bedrock для створення VitechIQ, чат-бота на основі штучного інтелекту для пошуку внутрішньої документації. Amazon Bedrock пропонує повністю керовані бази знань для таких чат-ботів, як VitechIQ.

Безперервна інтеграція (CI) та безперервна доставка (CD) трансформують розробку машинного навчання (ML), сприяючи співпраці, якості коду та ранньому виявленню проблем. Автоматизовані процеси в MLOps забезпечують стабільну роботу моделі та швидші ітерації для ефективної розробки моделей машинного навчання.
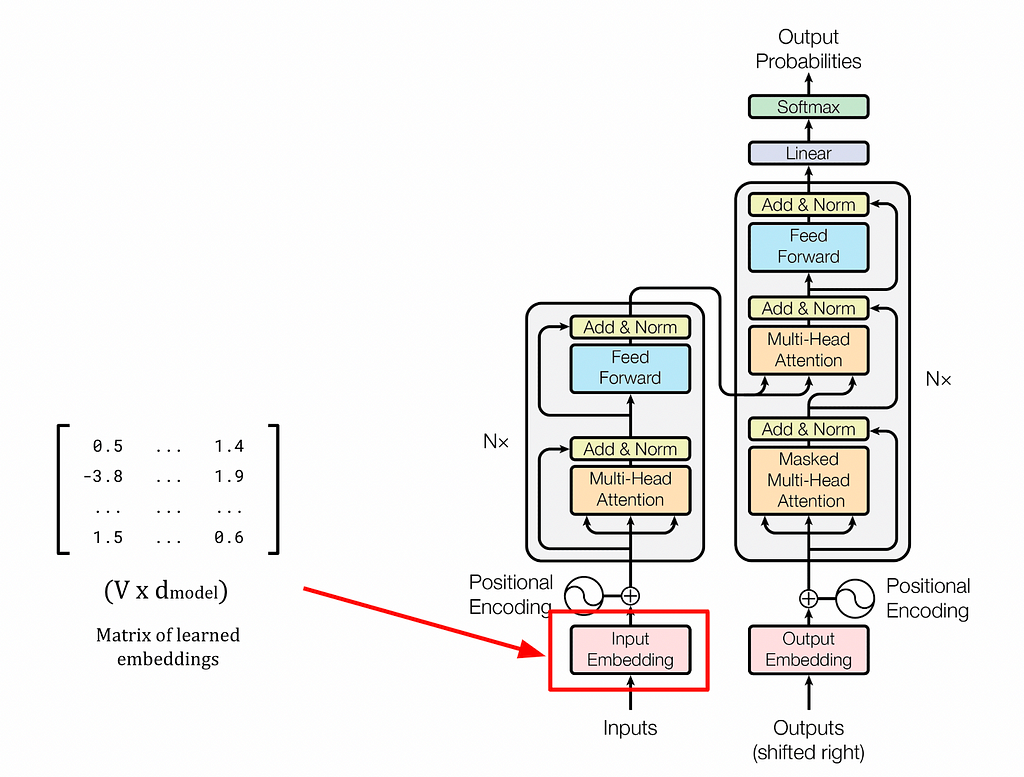
Великі мовні моделі, такі як GPT та BERT, покладаються на архітектуру трансформатора та механізм самоуваги для створення контекстуально багатих вбудовувань, що революціонізувало НЛП. Статичні вставки, такі як word2vec, не здатні вловити контекстну інформацію, що підкреслює важливість динамічних вставок у мовних моделях.

Мультимодальні моделі, такі як Claude3 і GPT-4V, інтегрують текст і зображення для кращого розуміння. Точне налаштування LLaVA на конкретних даних підвищує продуктивність у різних галузях.

Агенти ШІ, такі як ChatGPT, доводять, що ШІ може працювати на рівні людини. Agent Engineering Framework спрямований на розробку ефективних ШІ-агентів.

OpenAI зіткнувся з негативною реакцією Скарлетт Йоханссон через новий чат-бот Sky, схожий на її героїню у фільмі «Вона». Глобальний саміт зі штучного інтелекту в Південній Кореї та звіт Інституту Алана Тьюринга про вплив АІ на вибори. Алекс Херн з Guardian обговорює останні розробки в галузі АІ з Мадлен Фінлі на BBC News.

Колишній член правління OpenAI висловлює здивування з приводу публічного релізу ChatGPT у Twitter, який змістив фокус компанії. Також обговорювалися звільнення та повернення на роботу генерального директора Сема Альтмана.
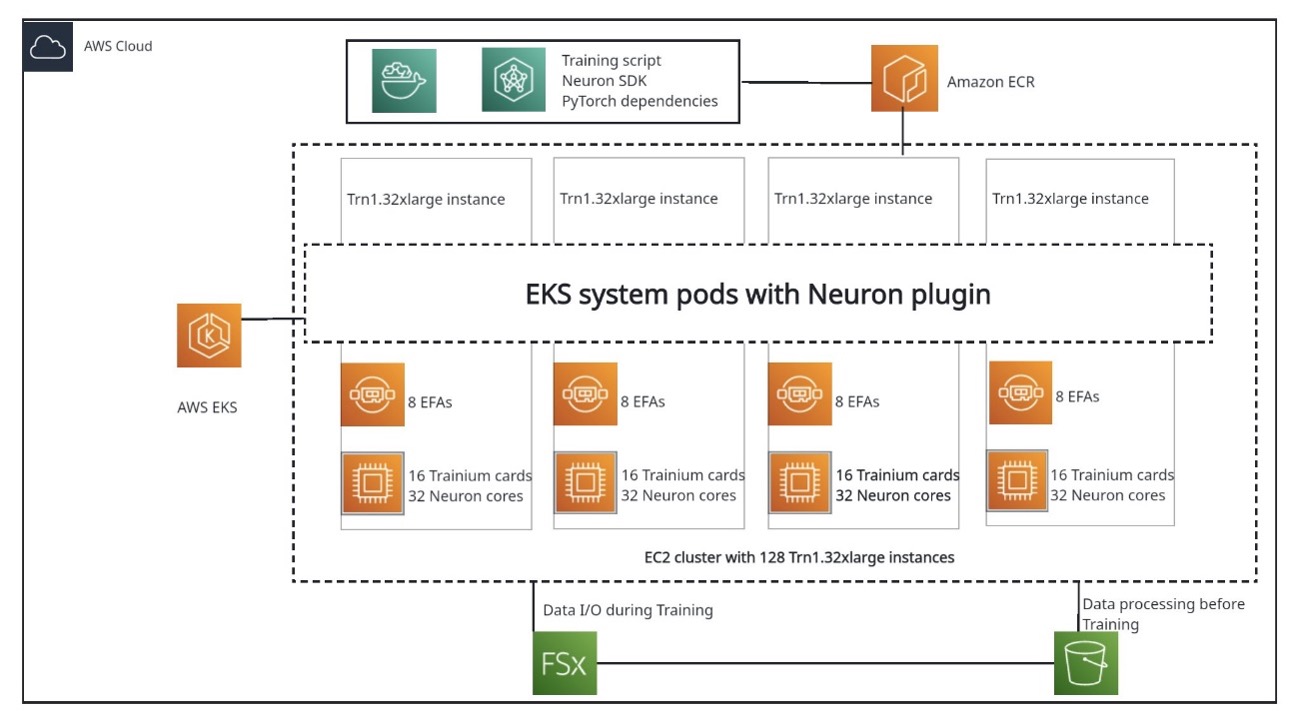
Llama, популярна велика мовна модель Meta AI, стикається з труднощами при навчанні, але може досягти порівнянної якості за допомогою належного масштабування та найкращих практик на AWS Trainium. Розподілене навчання на 100+ вузлах є складним завданням, але кластери Trainium пропонують економію коштів, ефективне відновлення та покращену стабільність для навчання LLM.

Президент Аргентини Хав'єр Мілей зустрінеться з технологічними гігантами в Кремнієвій долині на тлі гострої економічної кризи. Зустрічі Мілея з Пічаї, Альтманом, Цукербергом, Куком і Маском викликають подив.

OpenAI створює комітет з безпеки та захисту для прийняття важливих рішень. Розробляється нова модель ШІ для заміни системи ChatGPT.

Google використовує роздільну здатність сутностей для зіставлення продуктів на різних платформах, допомагаючи компаніям електронної комерції аналізувати конкурентів і порівнювати ціни. Фреймворк Entity Resolution (ER) допомагає виявляти дублікати оголошень і встановлювати конкурентні ціни в роздрібній торгівлі.