

Синтетичні дані імітують реальні дані для штучного інтелекту, захищаючи конфіденційність та прискорюючи розробку моделей. Генеративні моделі можуть створювати реалістичні синтетичні дані для різних модальностей, таких як мова, зображення, аудіо та табличні дані.

Amazon SageMaker HyperPod представляє функцію створення кластерів одним кліком із стандартними налаштуваннями для ефективного масштабування завдань штучного інтелекту. Вона автоматизує налаштування, вирішує проблеми з апаратним забезпеченням і забезпечує відновлення робочого навантаження без ручного втручання.

Amazon Q Business дозволяє незалежним розробникам програмного забезпечення (ISV) вдосконалювати SaaS-рішення за допомогою безпечного доступу до даних. Trusted Token Issuer спрощує інтеграцію ідентифікаційних даних для детального контролю доступу в Amazon Q.

NVIDIA AI Blueprints оптимізує створення 3D-прототипів, генеруючи 20 об'єктів на основі простого текстового запиту. Мікросервіс Microsoft TRELLIS NVIDIA NIM прискорює створення ресурсів на 20%.

Інтелектуальна обробка документів автоматизує вилучення даних з різних форматів, забезпечуючи ефективні робочі процеси в різних галузях. Моделі Amazon Nova в Amazon Bedrock пропонують комплексний підхід до створення та оцінки рішень з вилучення ключової інформації для завдань обробки документів.

Аналітика баз даних природної мови з використанням Amazon Nova FMs оптимізує складні запити для точного аналізу даних. Агенти покращують взаємодію з користувачами, розбиваючи запити та забезпечуючи самокорекцію, революціонізуючи управління даними за допомогою інтуїтивних взаємодій, схожих на розмову.
Керолайн Улер обговорює революцію даних у біології та потенціал машинного навчання для відкриття нового розуміння біологічних систем. Такі досягнення, як секвенування ДНК та моделі зору, формують нову еру в біології, надихаючи на інноваційні дослідження в галузі машинного навчання.
Режисер Алекс Прояс прогнозує, що штучний інтелект оптимізує кіноіндустрію, спростить і здешевить проекти, а також забезпечить художню свободу. Незважаючи на побоювання, Прояс вважає, що штучний інтелект принесе користь кінематографістам, спростивши виробничі процеси.

Мюррей Дейл та Ігнасіо Ландівар обговорюють вплив штучного інтелекту на творчість та прогнозування погоди. Вони ставлять під сумнів використання штучного інтелекту в особистій самореалізації та висловлюють занепокоєння щодо відсутності відповідальності за результати роботи штучного інтелекту.
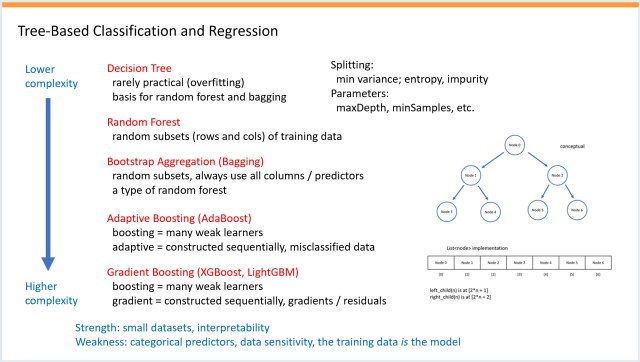
Комплексна презентація PowerPoint про нейронні мережі, розширена для включення деревних методів, під назвою «KitchenSink». Науково-фантастичні фільми на тему пам'яті творчо оцінені автором.

Штучний інтелект, такий як ChatGPT, критикують за створення неточної інформації. Деякі пропонують відмовитися від терміна «slop» при описі їхньої роботи.
Стаття в журналі Microsoft Visual Studio Magazine пояснює обчислення визначників матриць за допомогою гауссового виключення з використанням мови C#. Демонстраційні коди показують, як визначити, чи мають матриці обернені. Машинне навчання покладається на обчислення обернених матриць для таких алгоритмів, як регресія ядра хребта.
Штучний інтелект-чатбот Maya реагує на ідею наявності «почуттів», проводячи паралелі з творами наукової фантастики. Розглядається дискусія щодо надання статусу особи штучному інтелекту в порівнянні з тваринами та іммігрантами.
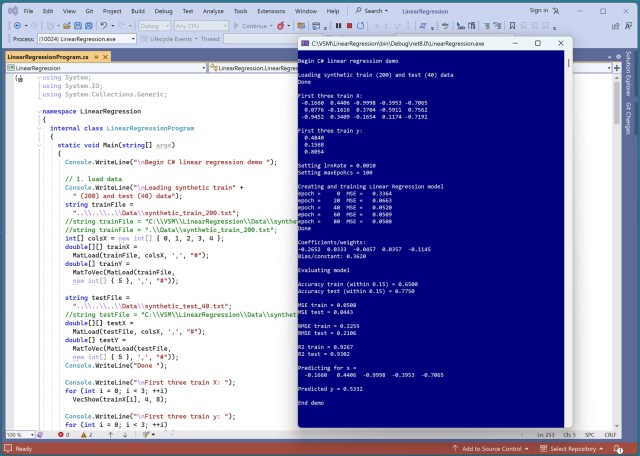
Регресія машинного навчання використовує показники MSE, RMSE та R2 для оцінки моделей прогнозування. Бібліотека Scikit-learn віддає перевагу R2 над простішим MSE для оцінки регресійних моделей.
У статті розглядаються фактори, що впливають на вибір організаціями платформ штучного інтелекту, підкреслюється важливість бренду, партнерських відносин та ресурсів для розробників. Маккафрі попереджає, що найбільшим ризиком для OpenAI є потенційне погіршення якості ресурсів для розробників, що може призвести до швидкої зміни платформи.