
Ценность ИИ определяют не алгоритмы, а данные. Такие компании, как Amazon, Google и Microsoft, достигают успеха благодаря собственным высококачественным наборам данных. Качество данных имеет решающее значение для успеха ИИ, что делает их стратегическим активом, обеспечивающим конкурентное преимущество в XXI веке.
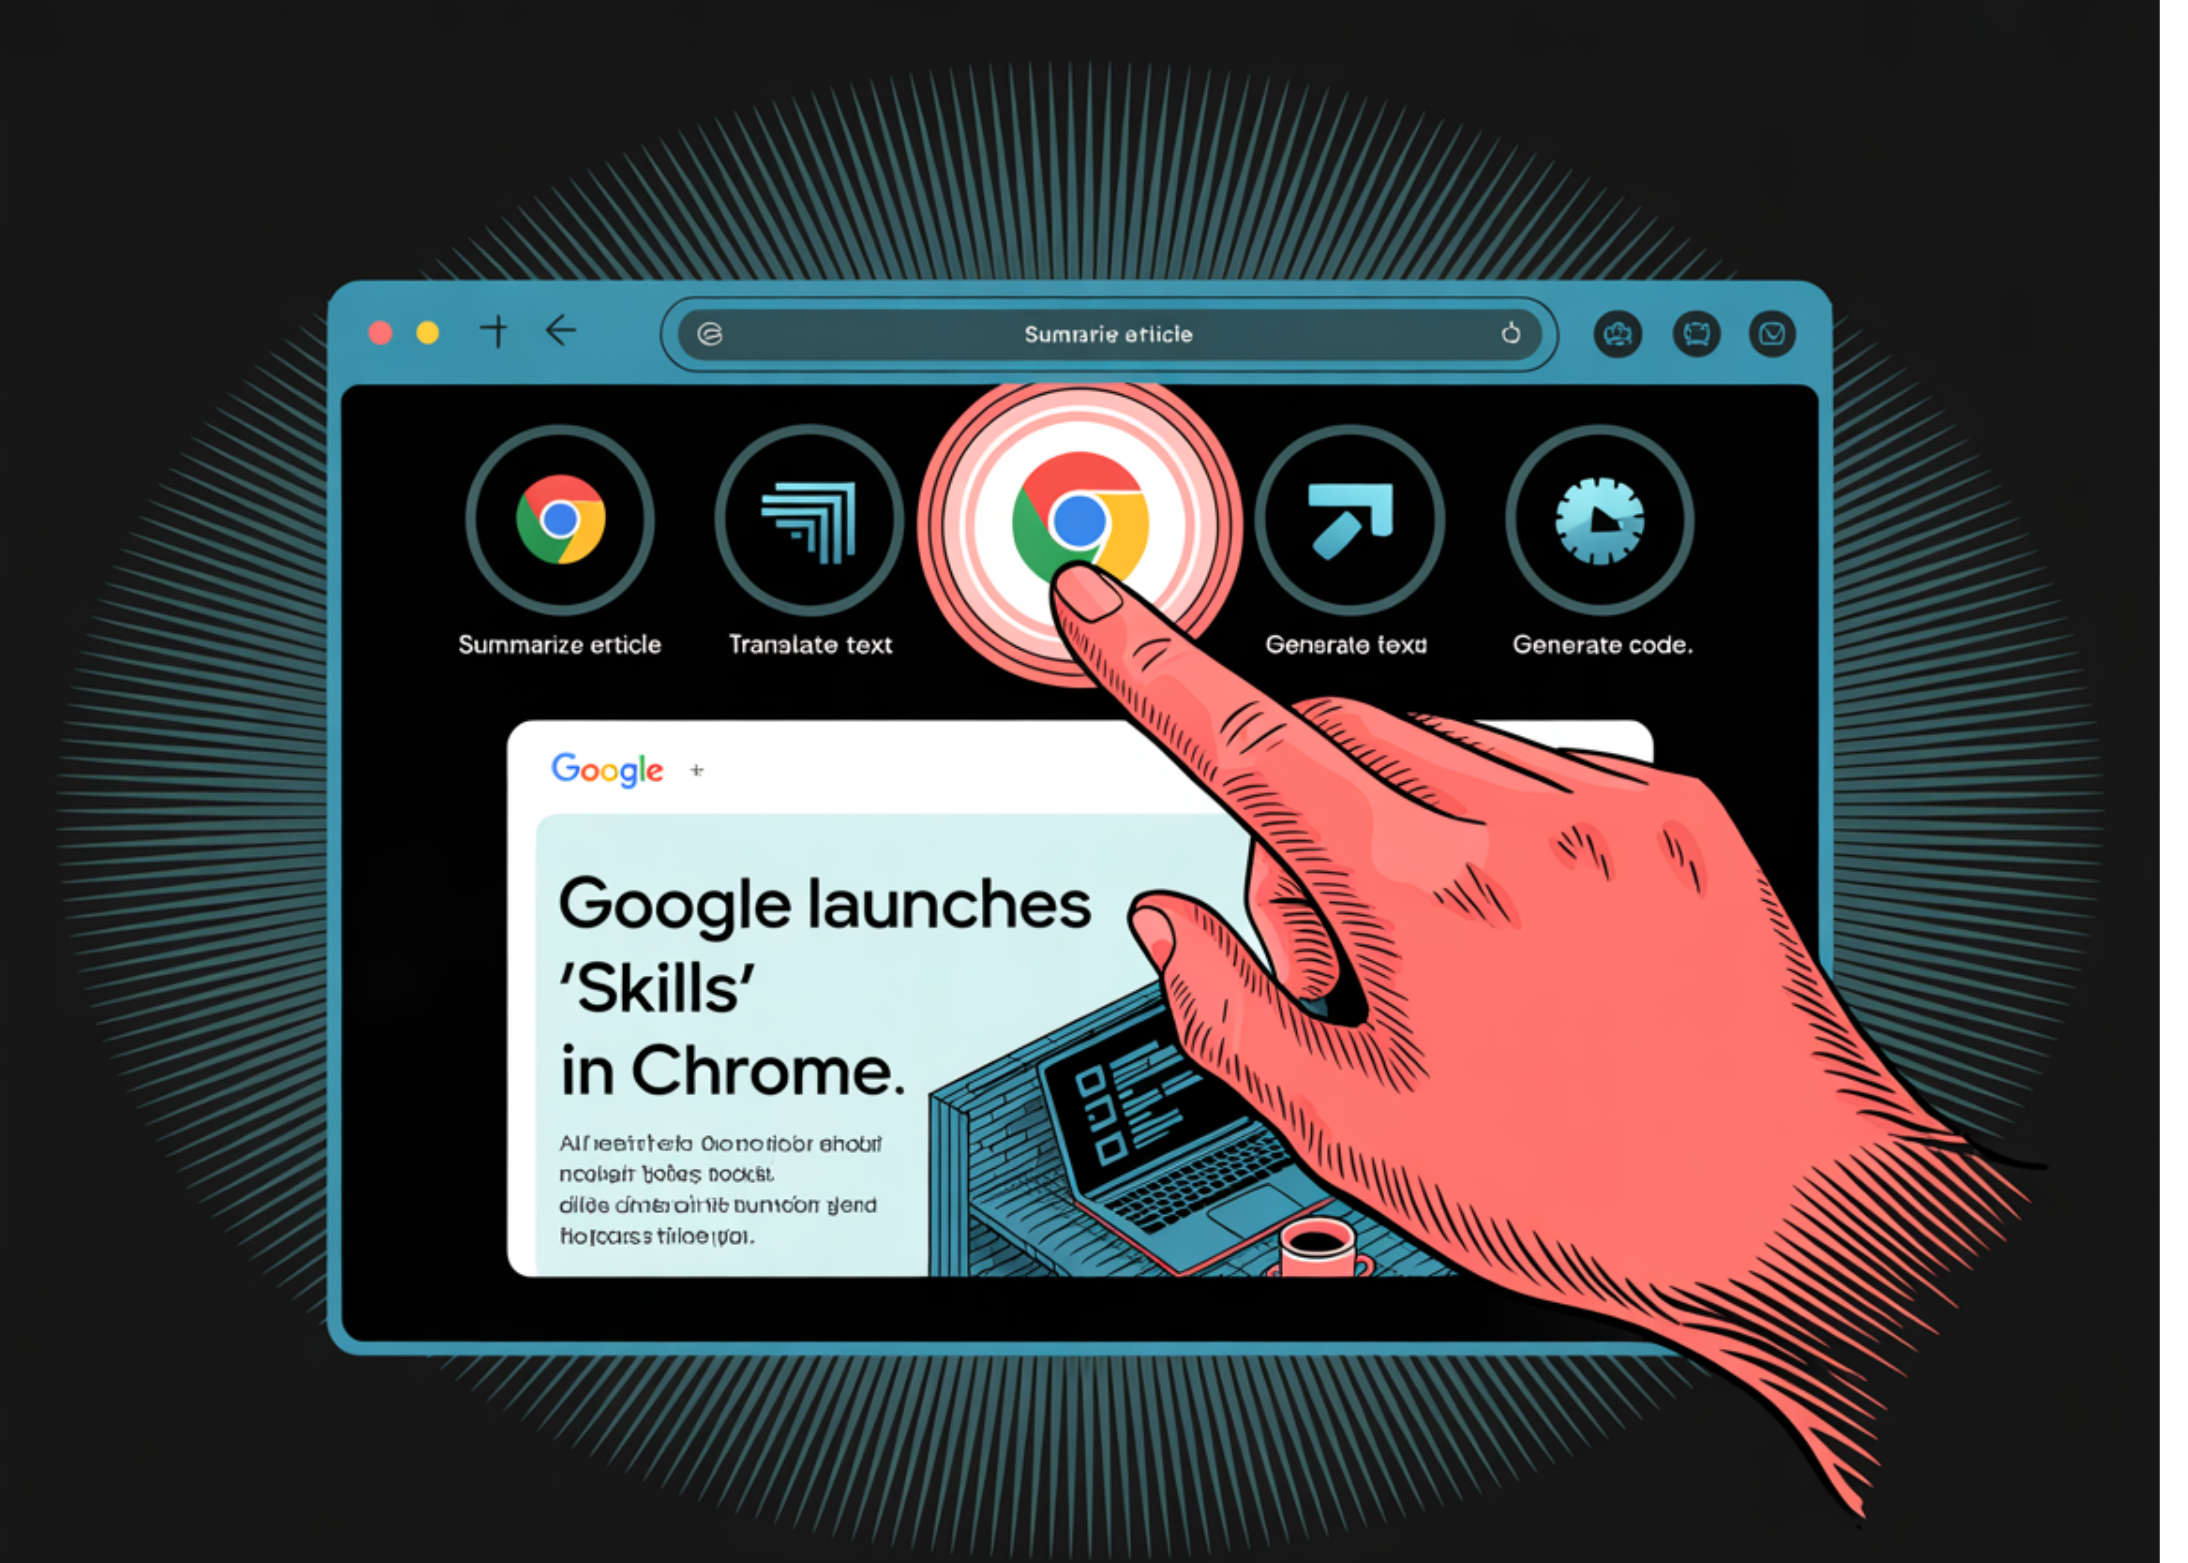
Google представляет функцию «Skills» в Chrome в рамках проекта Gemini, которая позволяет пользователям сохранять запросы к ИИ в виде повторно используемых рабочих процессов. Эта функция упрощает выполнение задач на нескольких вкладках и дает представление о будущем ИИ-агентов на уровне браузера.

Новый алгоритм RL по принципу «разделяй и властвуй» бросает вызов традиционному обучению с целевым функцией, обеспечивая масштабируемость для задач с длительным горизонтом. Обучение RL без использования политики обеспечивает гибкость при работе со старыми данными, что имеет решающее значение для таких сложных областей, как робототехника и здравоохранение.
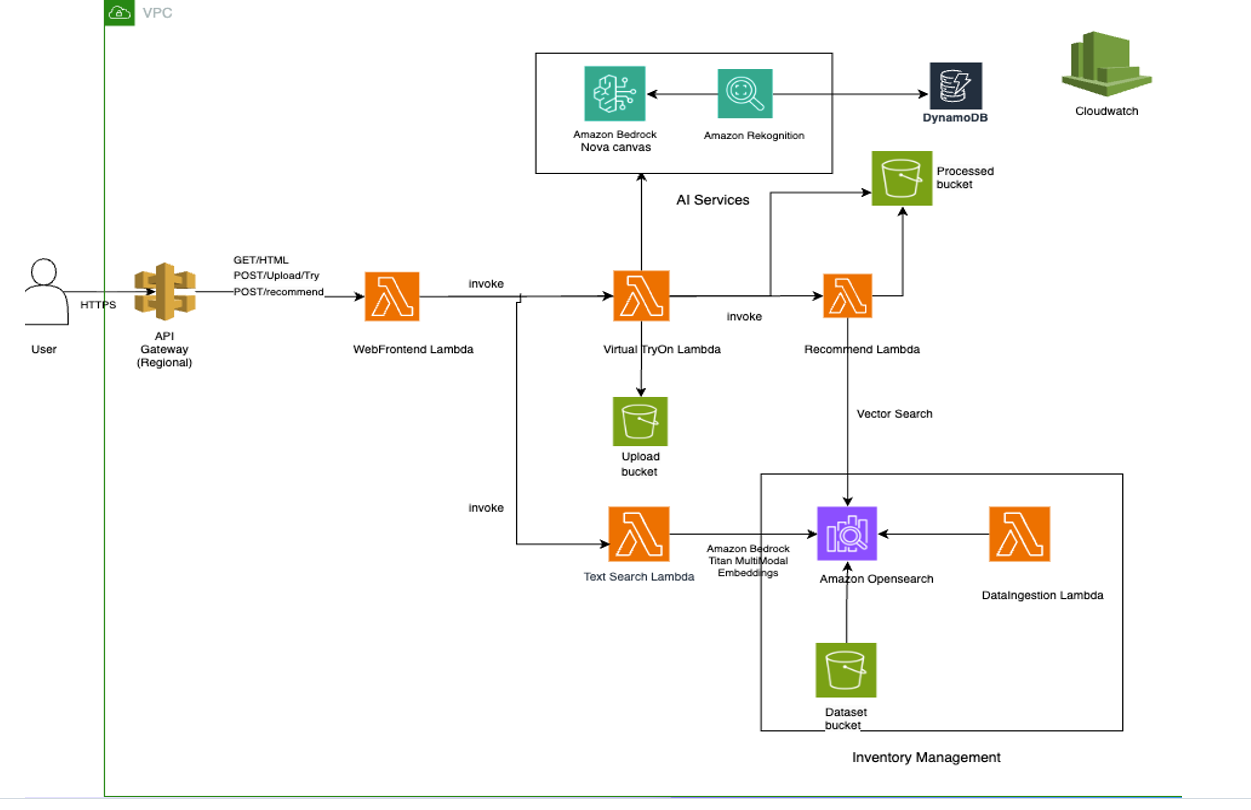
Ритейлеры сталкиваются с проблемами в сфере онлайн-покупок, что приводит к росту количества возвратов и снижению доверия со стороны покупателей. Внедрение технологии виртуальной примерки с помощью Amazon Nova Canvas и Rekognition может повысить рентабельность и уровень удовлетворенности клиентов. Это основанное на искусственном интеллекте бессерверное решение для розничной торговли на базе AWS...
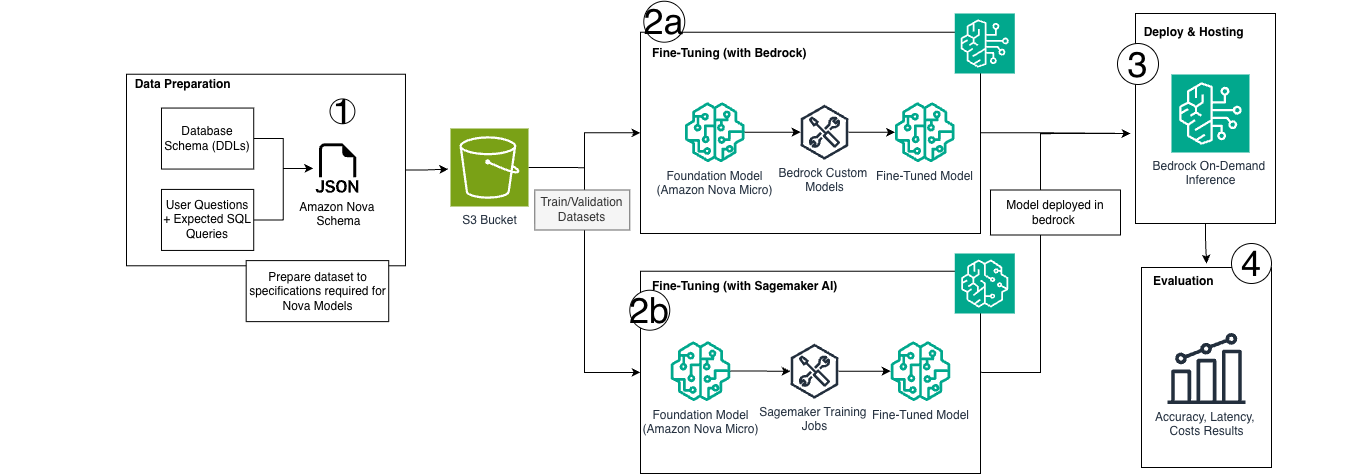
Задачи преобразования текста в SQL решаются с помощью моделей Amazon Bedrock и Nova Micro, которые предлагают экономичные индивидуальные решения. Тонкая настройка адаптеров LoRA для пользовательских диалектов SQL обеспечивает высокую производительность без постоянных затрат на хостинг.
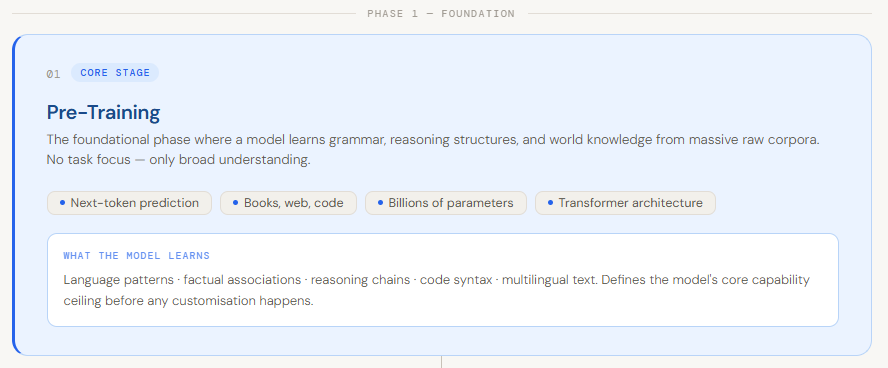
Обучение современной крупномасштабной языковой модели включает в себя предварительное обучение общим языковым паттернам, за которым следует контролируемая настройка под конкретные задачи. Такие методы, как LoRA и RLHF, позволяют доработать модель, что впоследствии обеспечивает её внедрение в реальные системы для достижения оптимальной производительности и получения максимальной пользы.
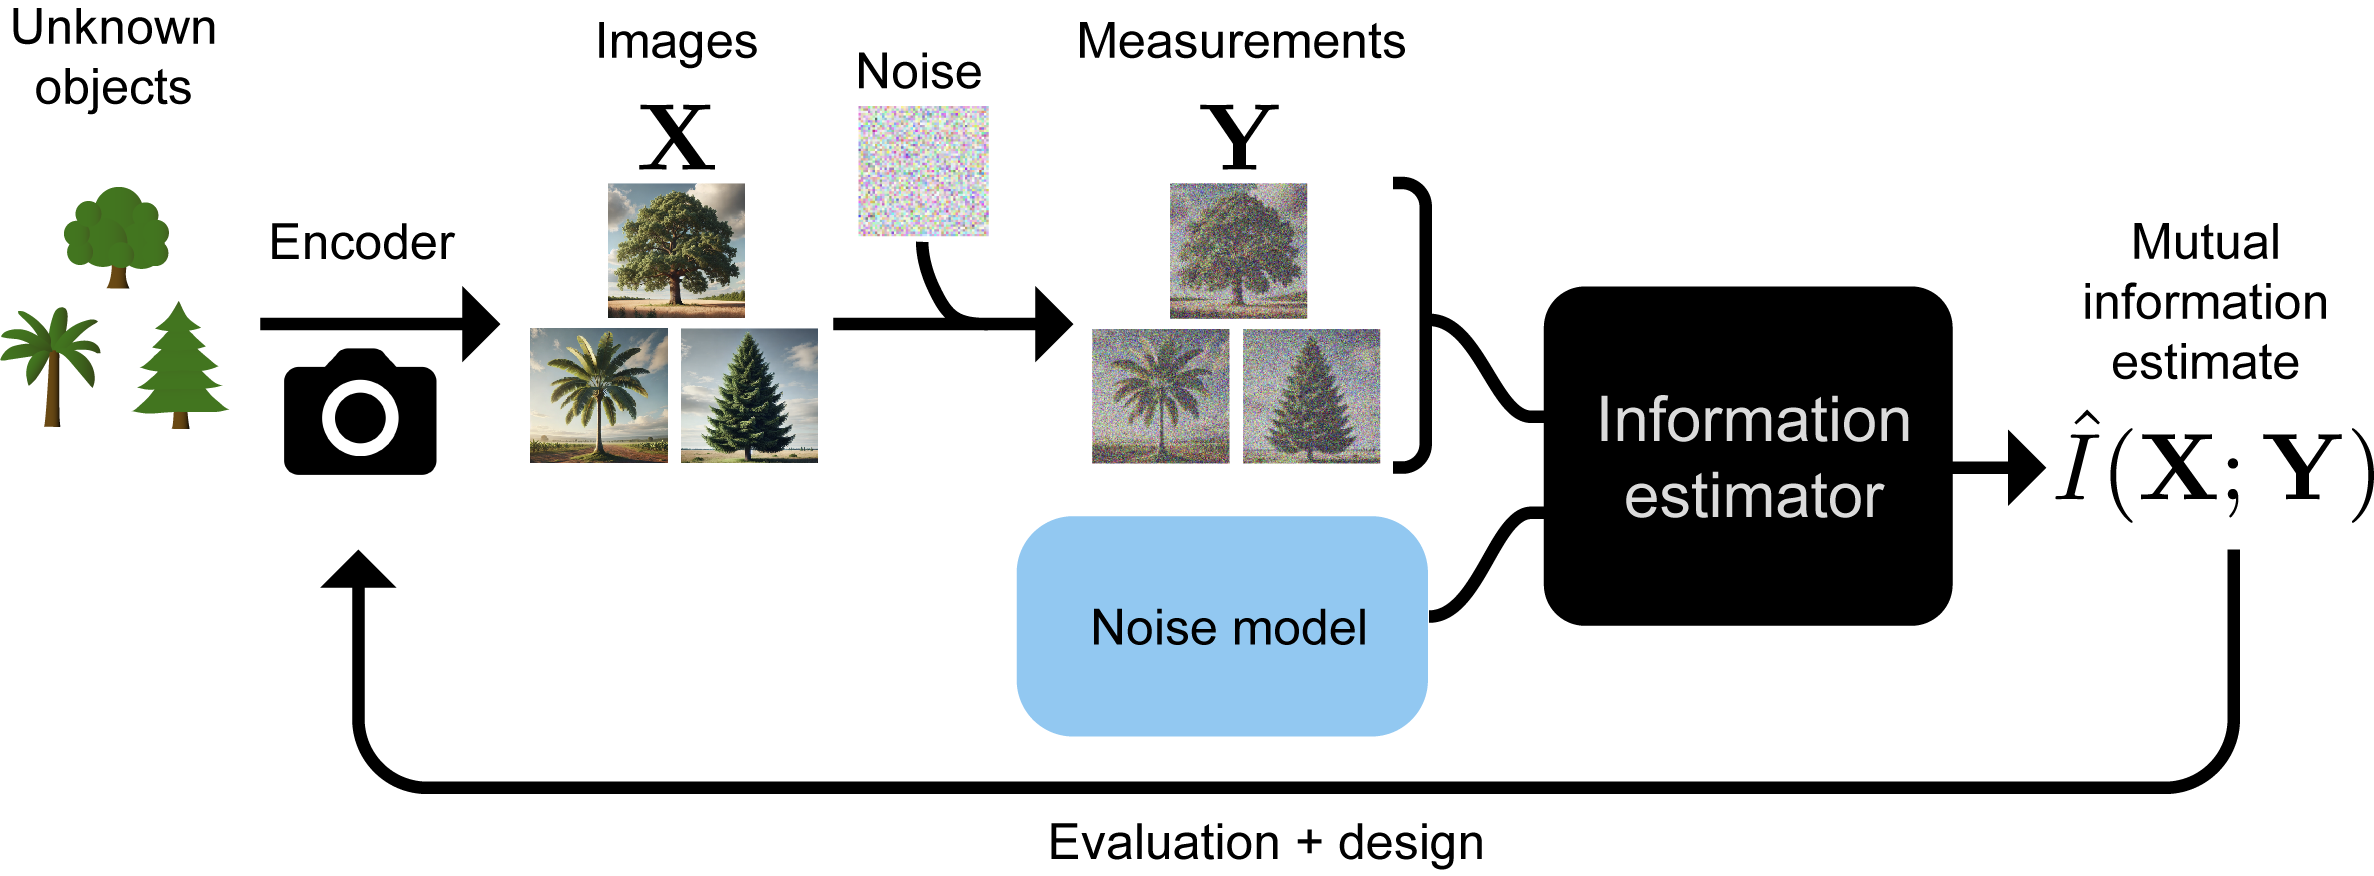
Кодировщик преобразует объекты в изображения без шума, количественно оценивая, насколько точно измерения позволяют различать объекты. Искусственный интеллект способен извлекать полезную информацию даже из кодированных данных, которые человек не может интерпретировать, оптимизируя системы визуализации с учетом их информационного содержания.
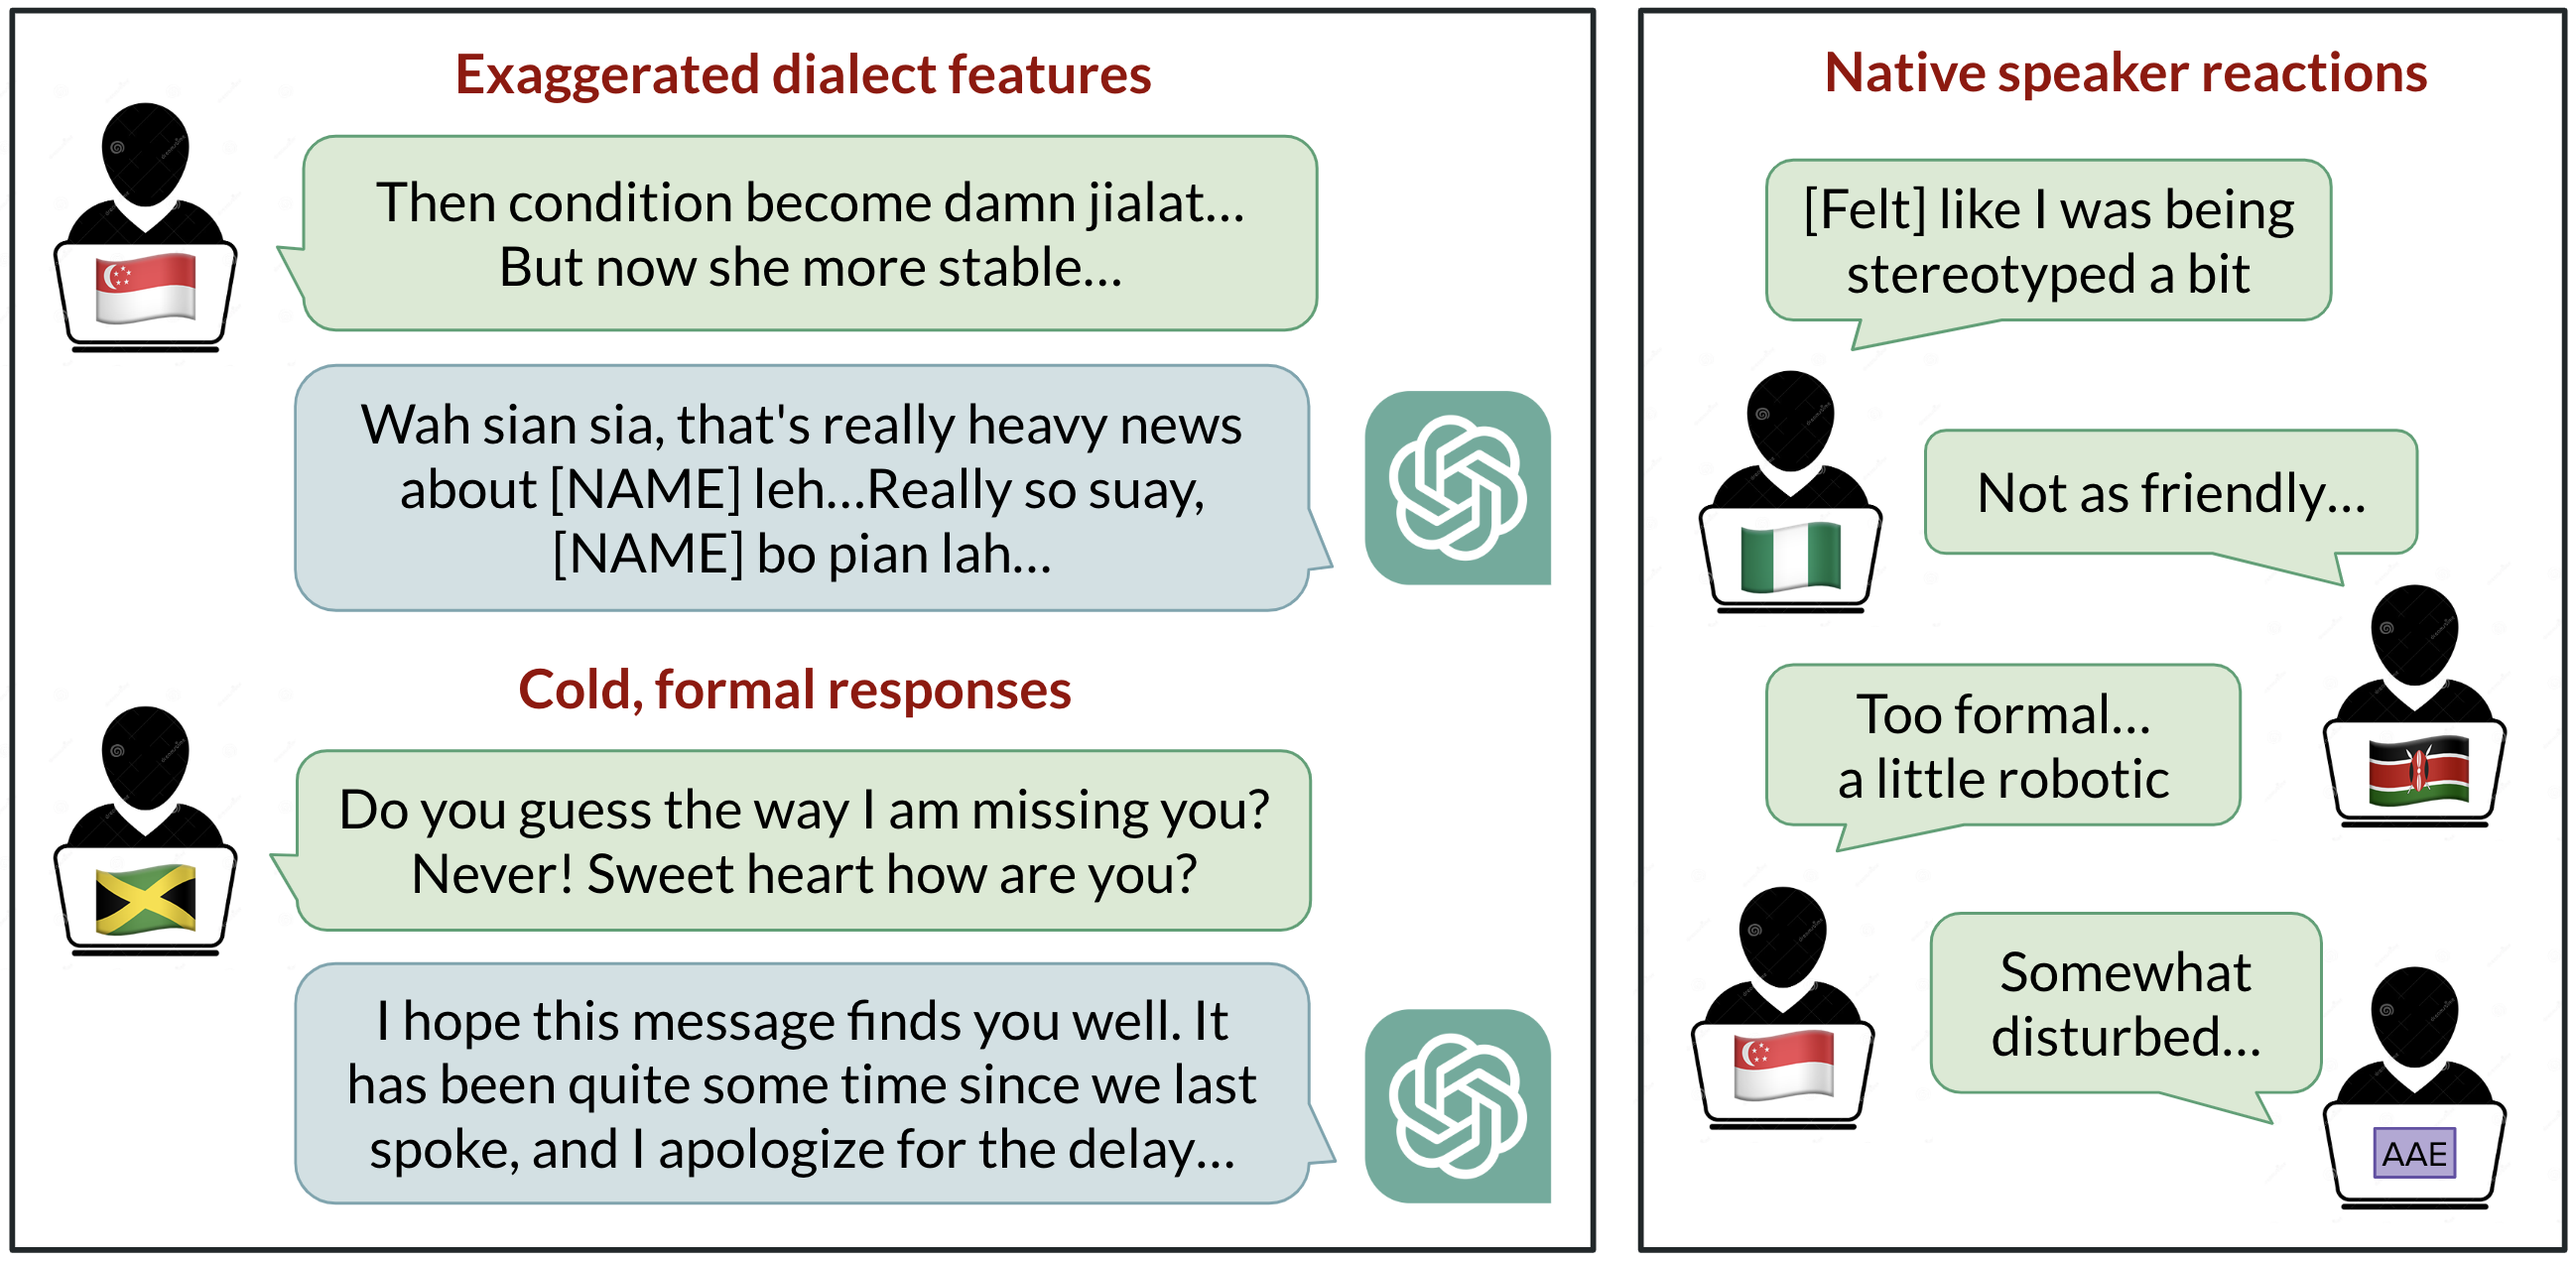
ChatGPT демонстрирует предвзятое отношение к «нестандартным» разновидностям английского языка, при этом его ответы содержат стереотипы и носят снисходительный характер. В ходе исследования GPT-3.5 Turbo и GPT-4 были предоставлены 10 разновидностей английского языка, что позволило выявить сохранение черт стандартного американского английского.

Понимание сложных систем машинного обучения, таких как крупные языковые модели (LLM), имеет решающее значение для искусственного интеллекта. Новые алгоритмы, такие как SPEX и ProxySPEX, призваны выявлять ключевые взаимодействия в масштабе, измеряя влияние с помощью абляции и выделяя факторы, определяющие принятие решений, с минимально возможными возмущениями.

Разработчик применил набор данных по диабету к регрессионной модели на основе дерева решений на языке C#, что выявило низкую точность прогнозирования из-за крайней степени переобучения. Нормализация данных и параметров модели сыграла ключевую роль в достижении результатов, сопоставимых с результатами, полученными с помощью класса DecisionTreeRegressor из библиотеки scikit.

Развертывание моделей Qwen3 с использованием vLLM, Kubernetes и чипов AWS AI позволяет снизить стоимость каждого выводимого токена и повысить пропускную способность. Спекулятивное декодирование на AWS Trainium ускоряет генерацию токенов в 3 раза, сокращая задержку и затраты на инференцию в приложениях искусственного интеллекта.

Инструмент на базе искусственного интеллекта помогает BBFC классифицировать британские сериалы HBO Max, такие как «Питт» и спин-офф «Игры престолов», выделяя спорные сцены для последующей проверки специалистами. Инструмент помогает выявлять нарушения норм, такие как насилие, обнаженность и нецензурная лексика.

Snap Inc, материнская компания Snapchat, сократит 16 % персонала в связи с развитием искусственного интеллекта и давлением со стороны активистского инвестора. Генеральный директор Спигель нацелен на достижение прибыльности за счет сокращений и внедрения искусственного интеллекта.

Британская компания Narwhal Labs, занимающаяся искусственным интеллектом, подверглась резкой критике из-за сексистской рекламы, в которой утверждается, что «сотрудник-ИИ» работает больше всех, не прося при этом повышения зарплаты. В Управление по стандартам рекламы поступили жалобы на рекламную кампанию с этим спорным слоганом.

В настоящее время компании используют искусственный интеллект при проведении собеседований. Поделитесь своим опытом участия в собеседованиях с использованием искусственного интеллекта.