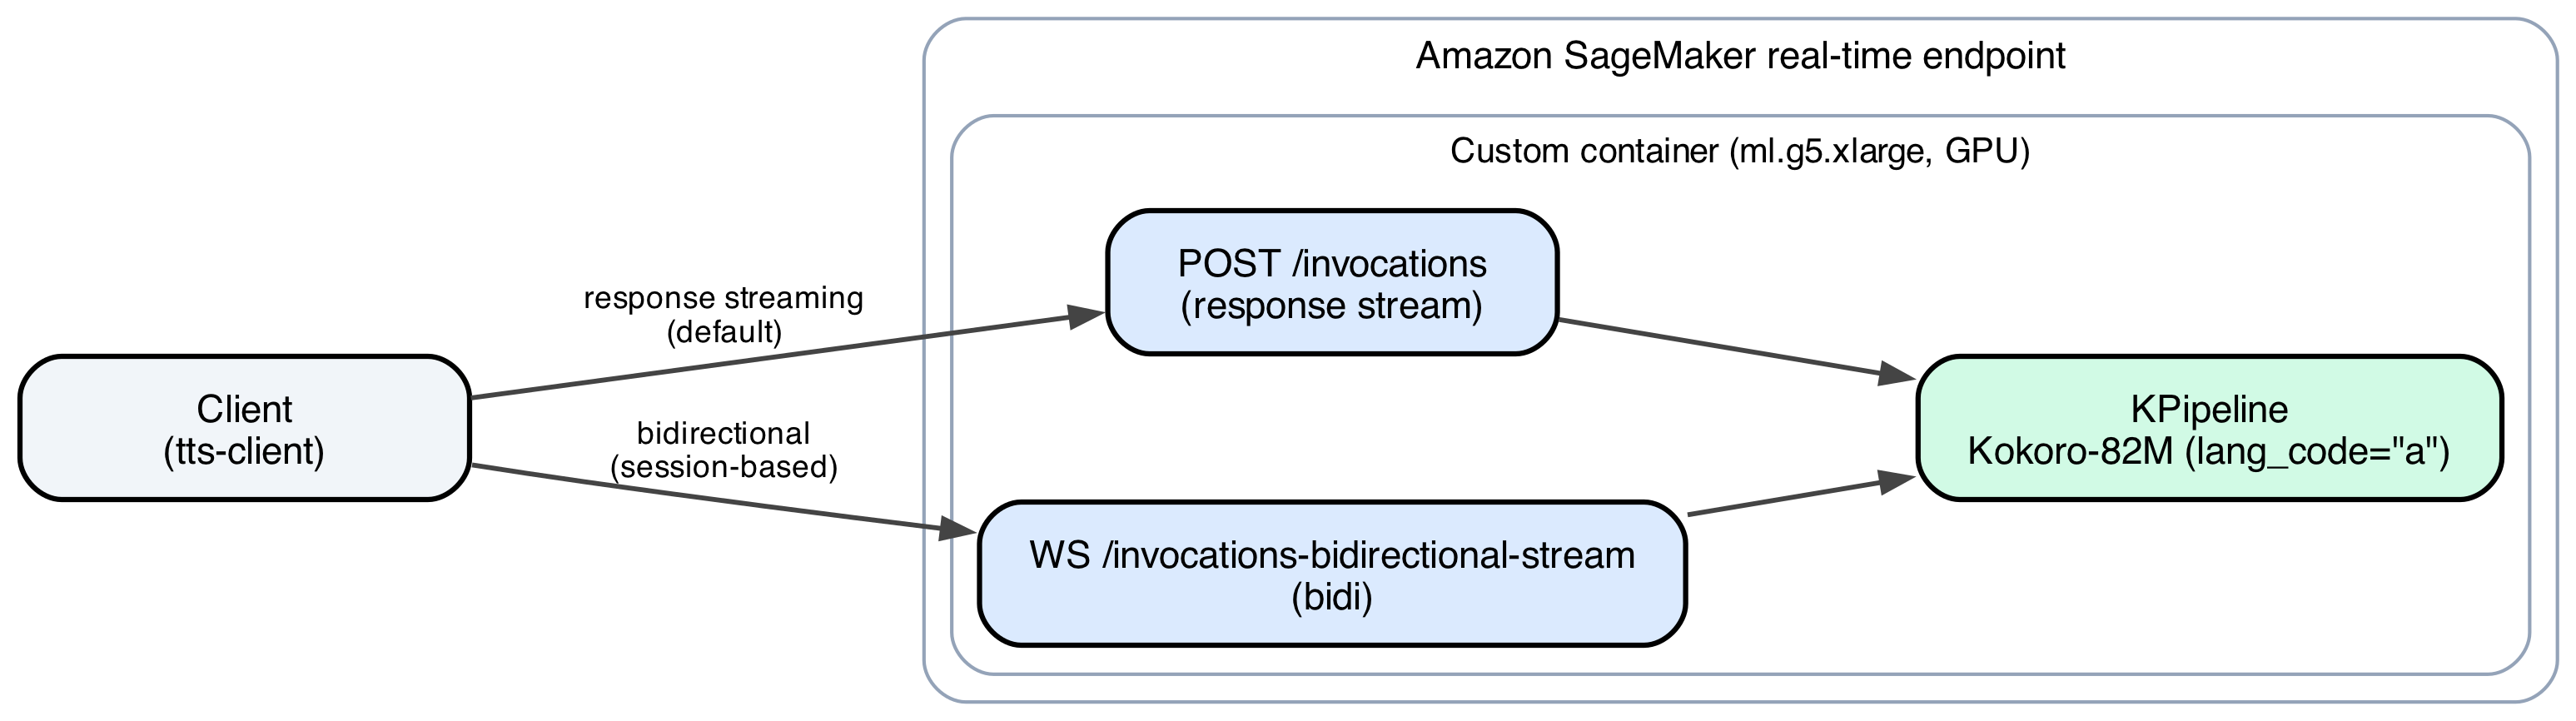
Всплеск трафика может перегрузить локальный сервер преобразования текста в речь (TTS), что приведет к проблемам с задержкой. Развертывание модели Kokoro-82M на платформе Amazon SageMaker AI с точной настройкой масштабирования позволяет предотвратить скрытые ошибки.
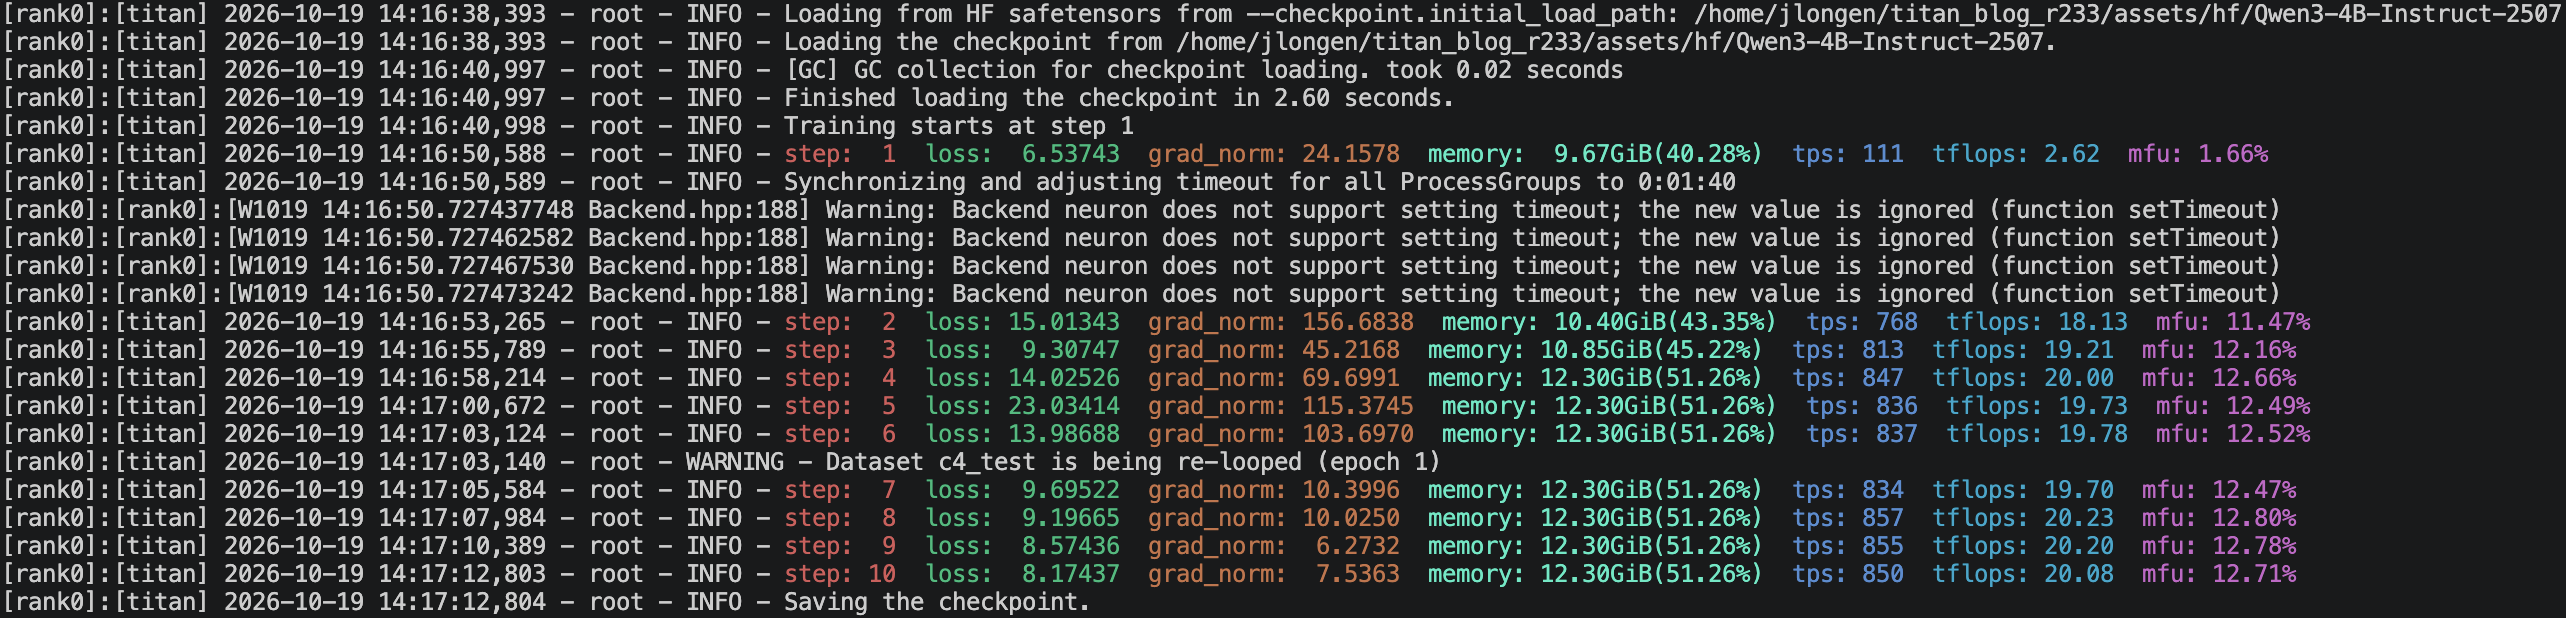
Обучите модель Qwen3 тремя способами на одном экземпляре trn2.48xlarge, используя технологию torchtitan на процессорах AWS Trainium. Настройте реализацию модели и ядра для вашей рабочей нагрузки с помощью интерфейса Neuron Kernel Interface (NKI) и ядер MoE.
Комплекс Tempodrom, расположенный недалеко от железнодорожного вокзала Anhalter Bahnhof с 2001 года, станет площадкой для проведения GTC Berlin, где генеральный директор NVIDIA Дженсен Хуанг выступит с докладом о европейских партнерствах в области искусственного интеллекта и инновациях в сфере создания AI-платформ. Компания NVIDIA представит DSX POD для быстрой развертывания AI-платформ, обещая...
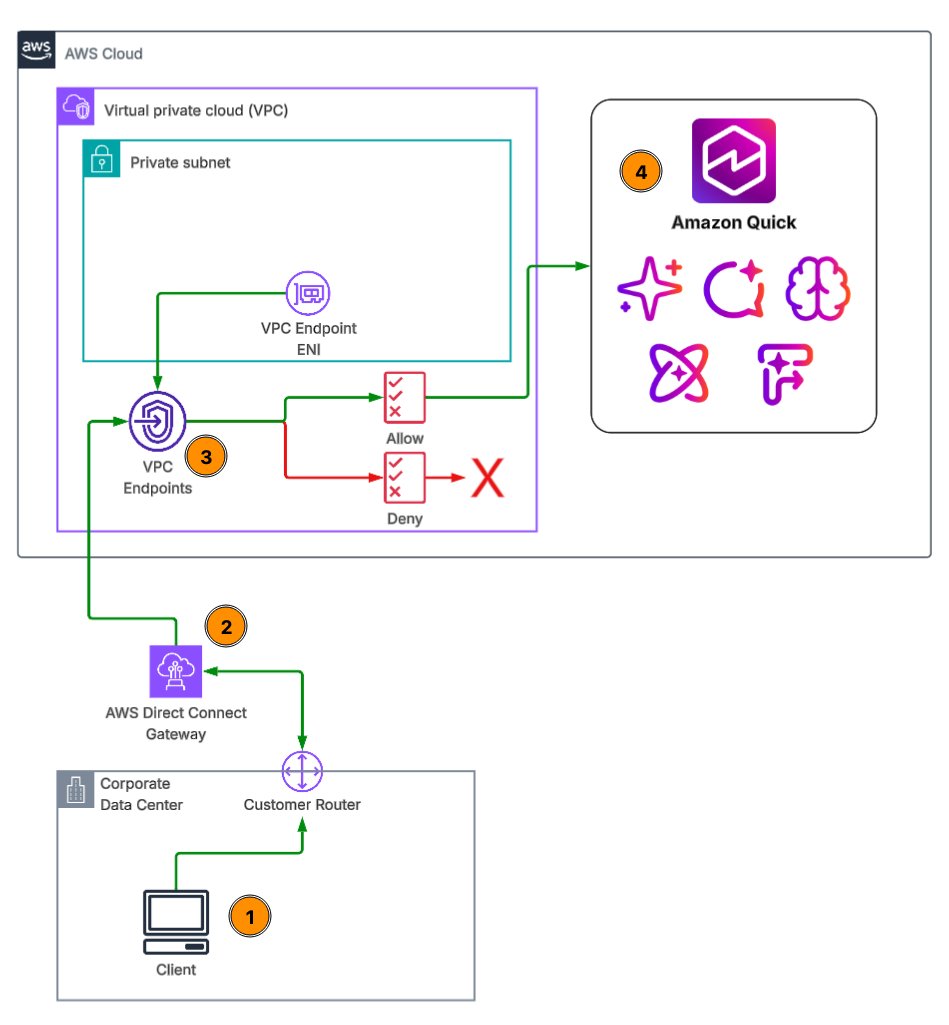
Подключите локальные данные к сервису Amazon Quick с помощью защищенного соединения через частную сеть, что снижает вероятность атак и обеспечивает соответствие требованиям безопасности. Amazon Quick предлагает возможности поиска, анализа и автоматизации на основе искусственного интеллекта в приватной и безопасной среде для обработки пользовательских запросов и получения данных.
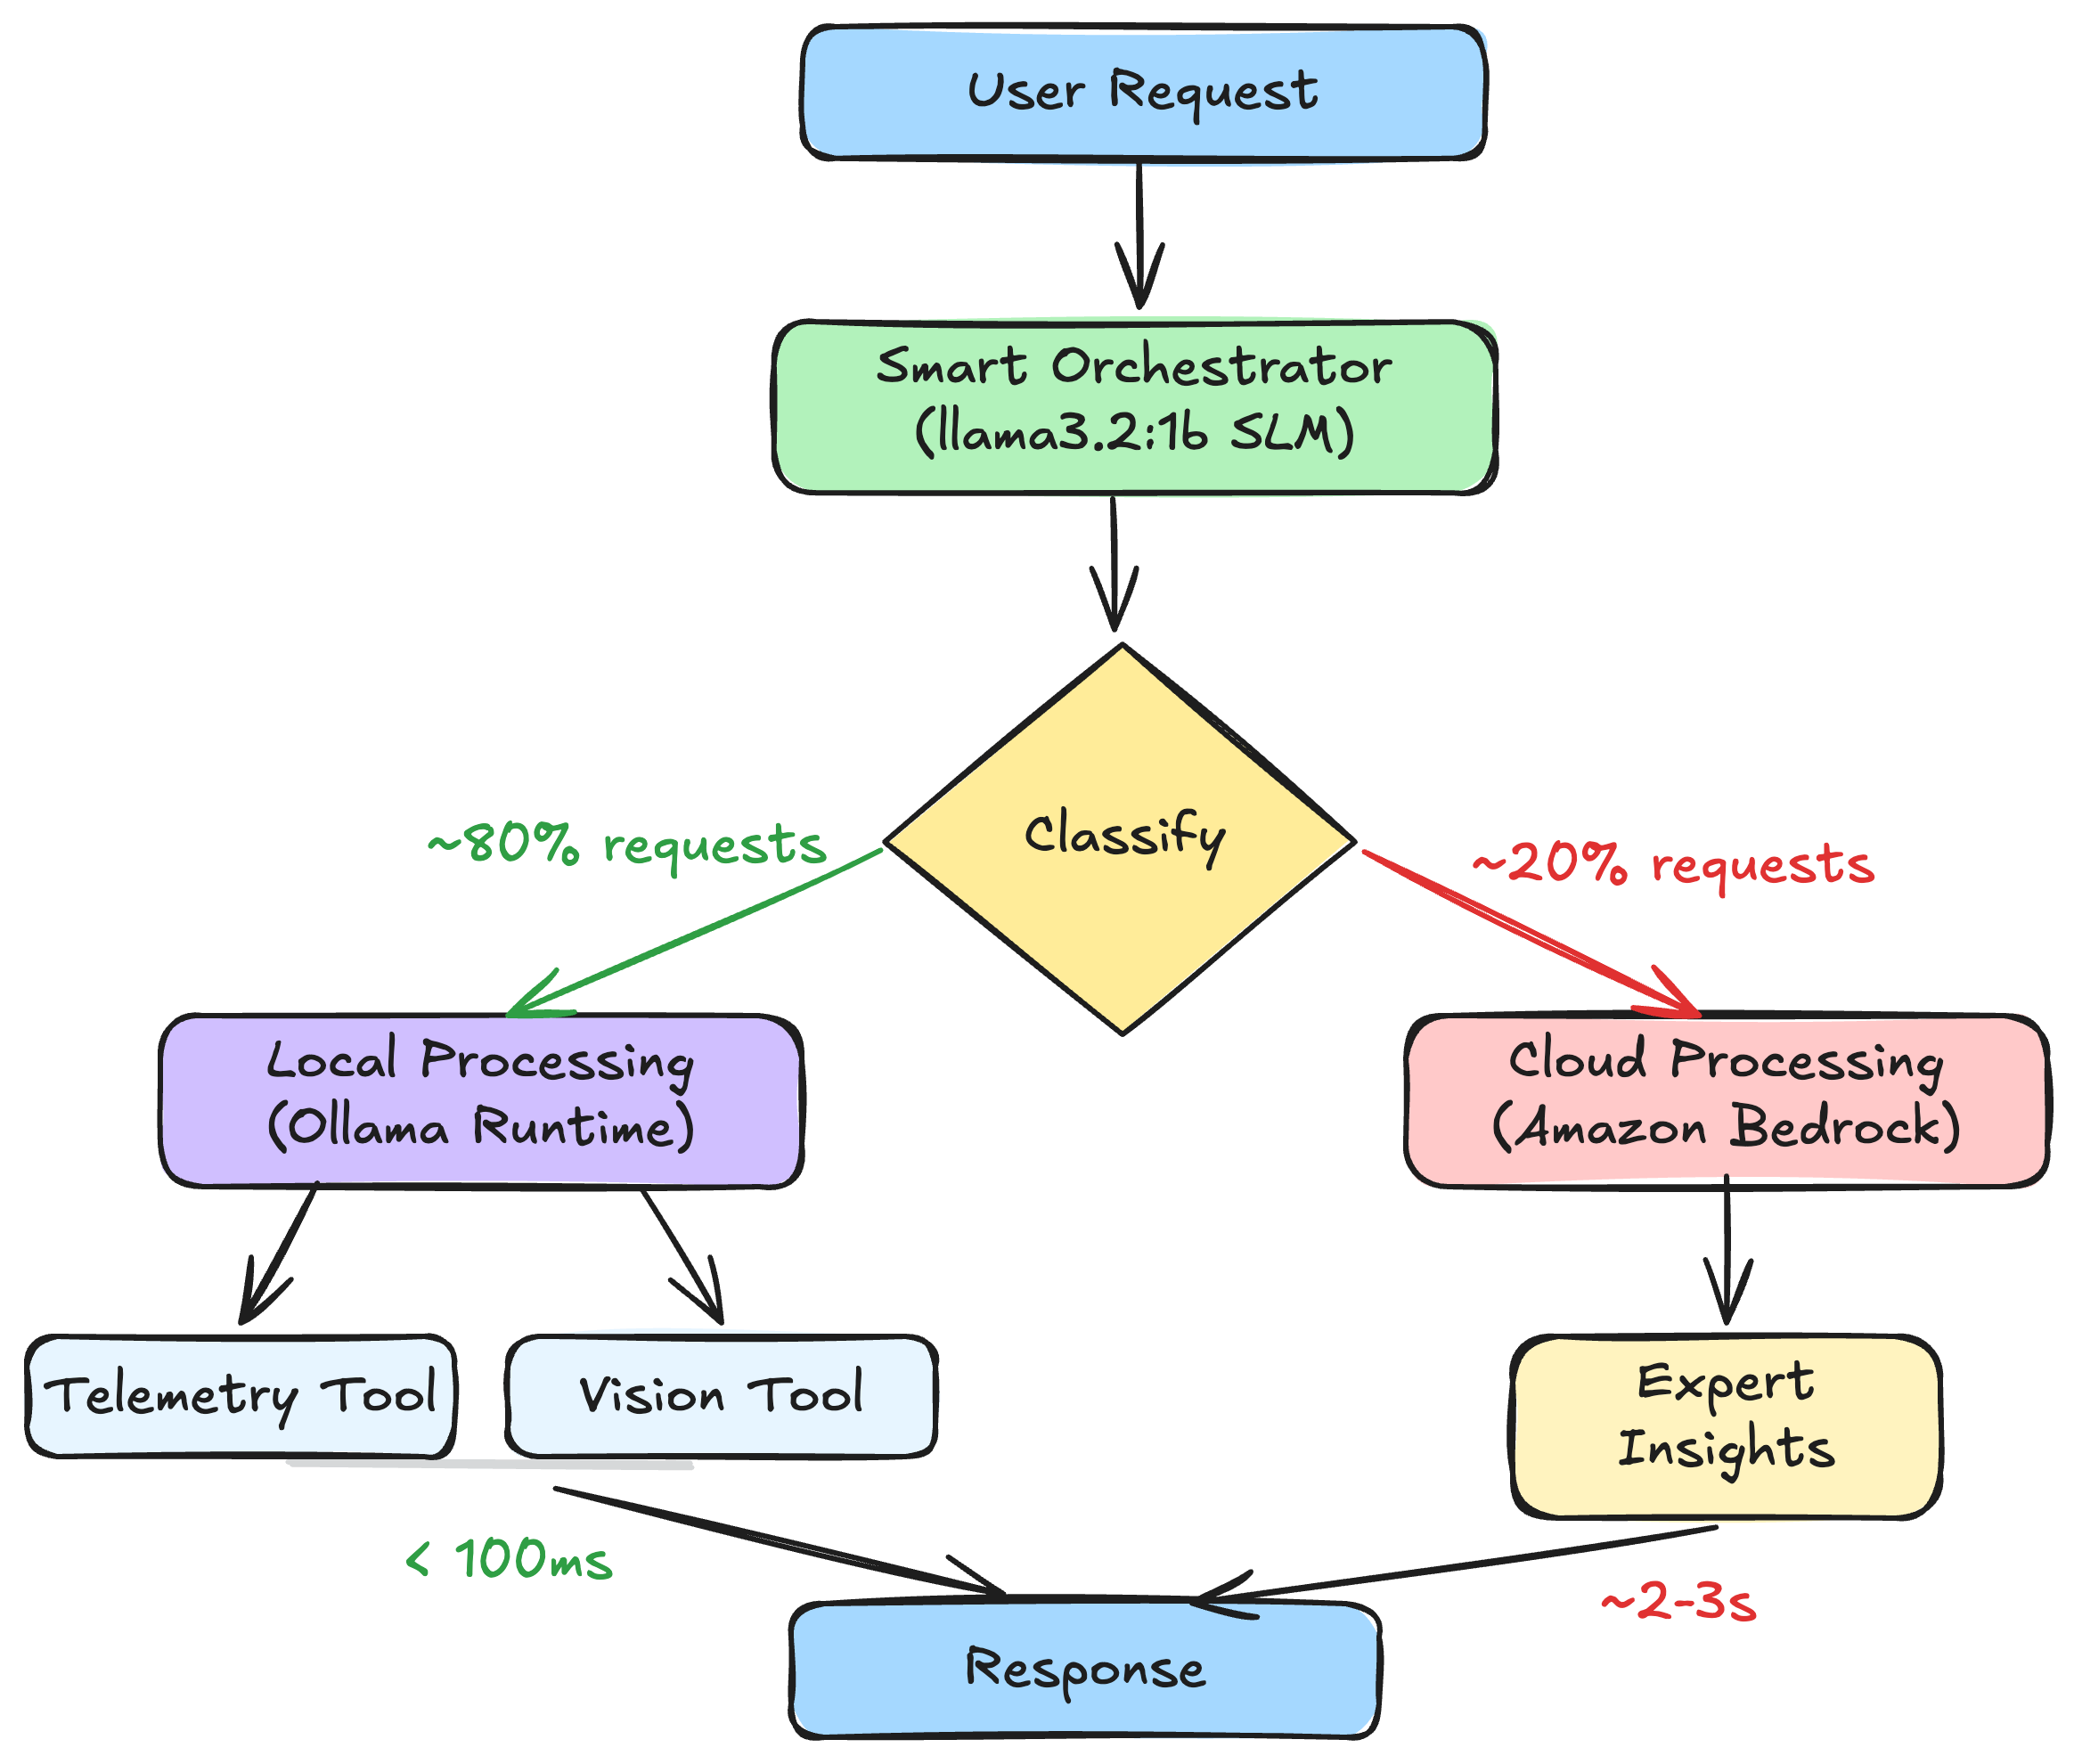
Фреймворк адаптивного агентного интеллекта (AAIF) использует небольшие языковые модели (SLM) для выполнения рутинных задач и облачные модели для обработки сложных запросов, что позволяет снизить затраты и задержки. Три уровня AAIF – интеллектуальная оркестровка, локальная обработка и облачная обработка – оптимизируют работу искусственного интеллекта для различных типов задач, демонстрируя гибки...
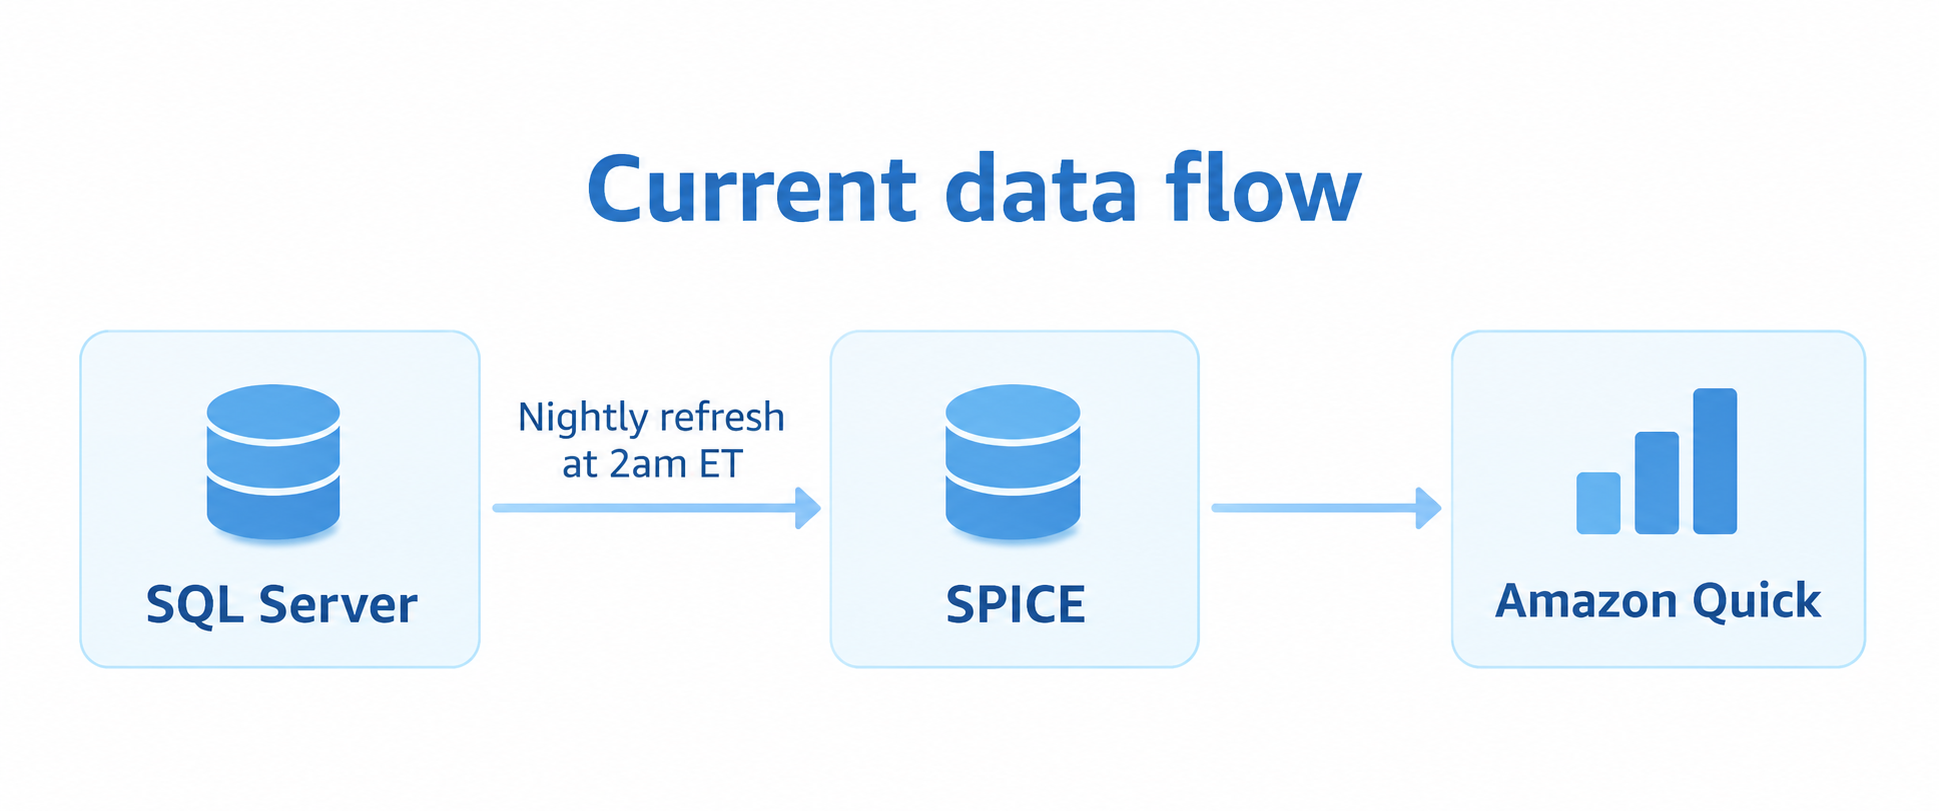
Миссия организации U.S. Hunger заключается не только в предоставлении еды, но и в понимании потребностей семей. Личная заинтересованность президента Рика Уиттеда способствует росту организации и ее инновационному использованию платформы Amazon Quick для анализа данных.
Моя реализация на C# для оценки кредитоспособности (GBR) соответствует результатам, полученным с использованием библиотеки scikit-learn, и позволяет точно прогнозировать доход на основе пола, возраста, города, роста и психологических характеристик. Эта реализация на C# обеспечивает подробные объяснения результатов прогнозирования, демонстрируя ее эффективность и прозрачность в задачах машинного...
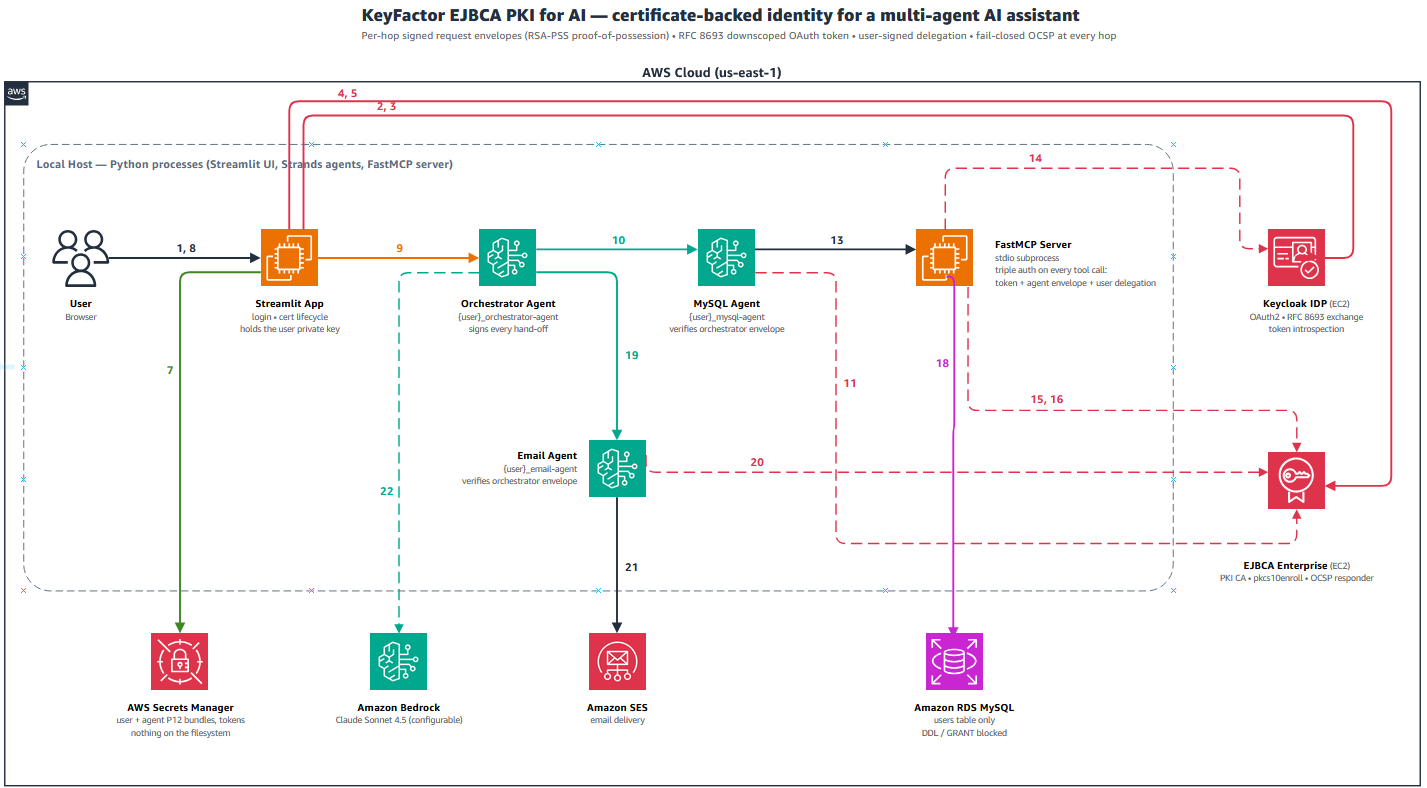
Установление криптографической идентификации с использованием инфраструктуры открытых ключей X.509 имеет решающее значение для агентов искусственного интеллекта, получающих доступ к конфиденциальным данным. Сервисы Keyfactor EJBCA и AWS обеспечивают безопасную аутентификацию для многоагентных систем искусственного интеллекта, предотвращая несанкционированный доступ и обеспечивая доверие к идент...
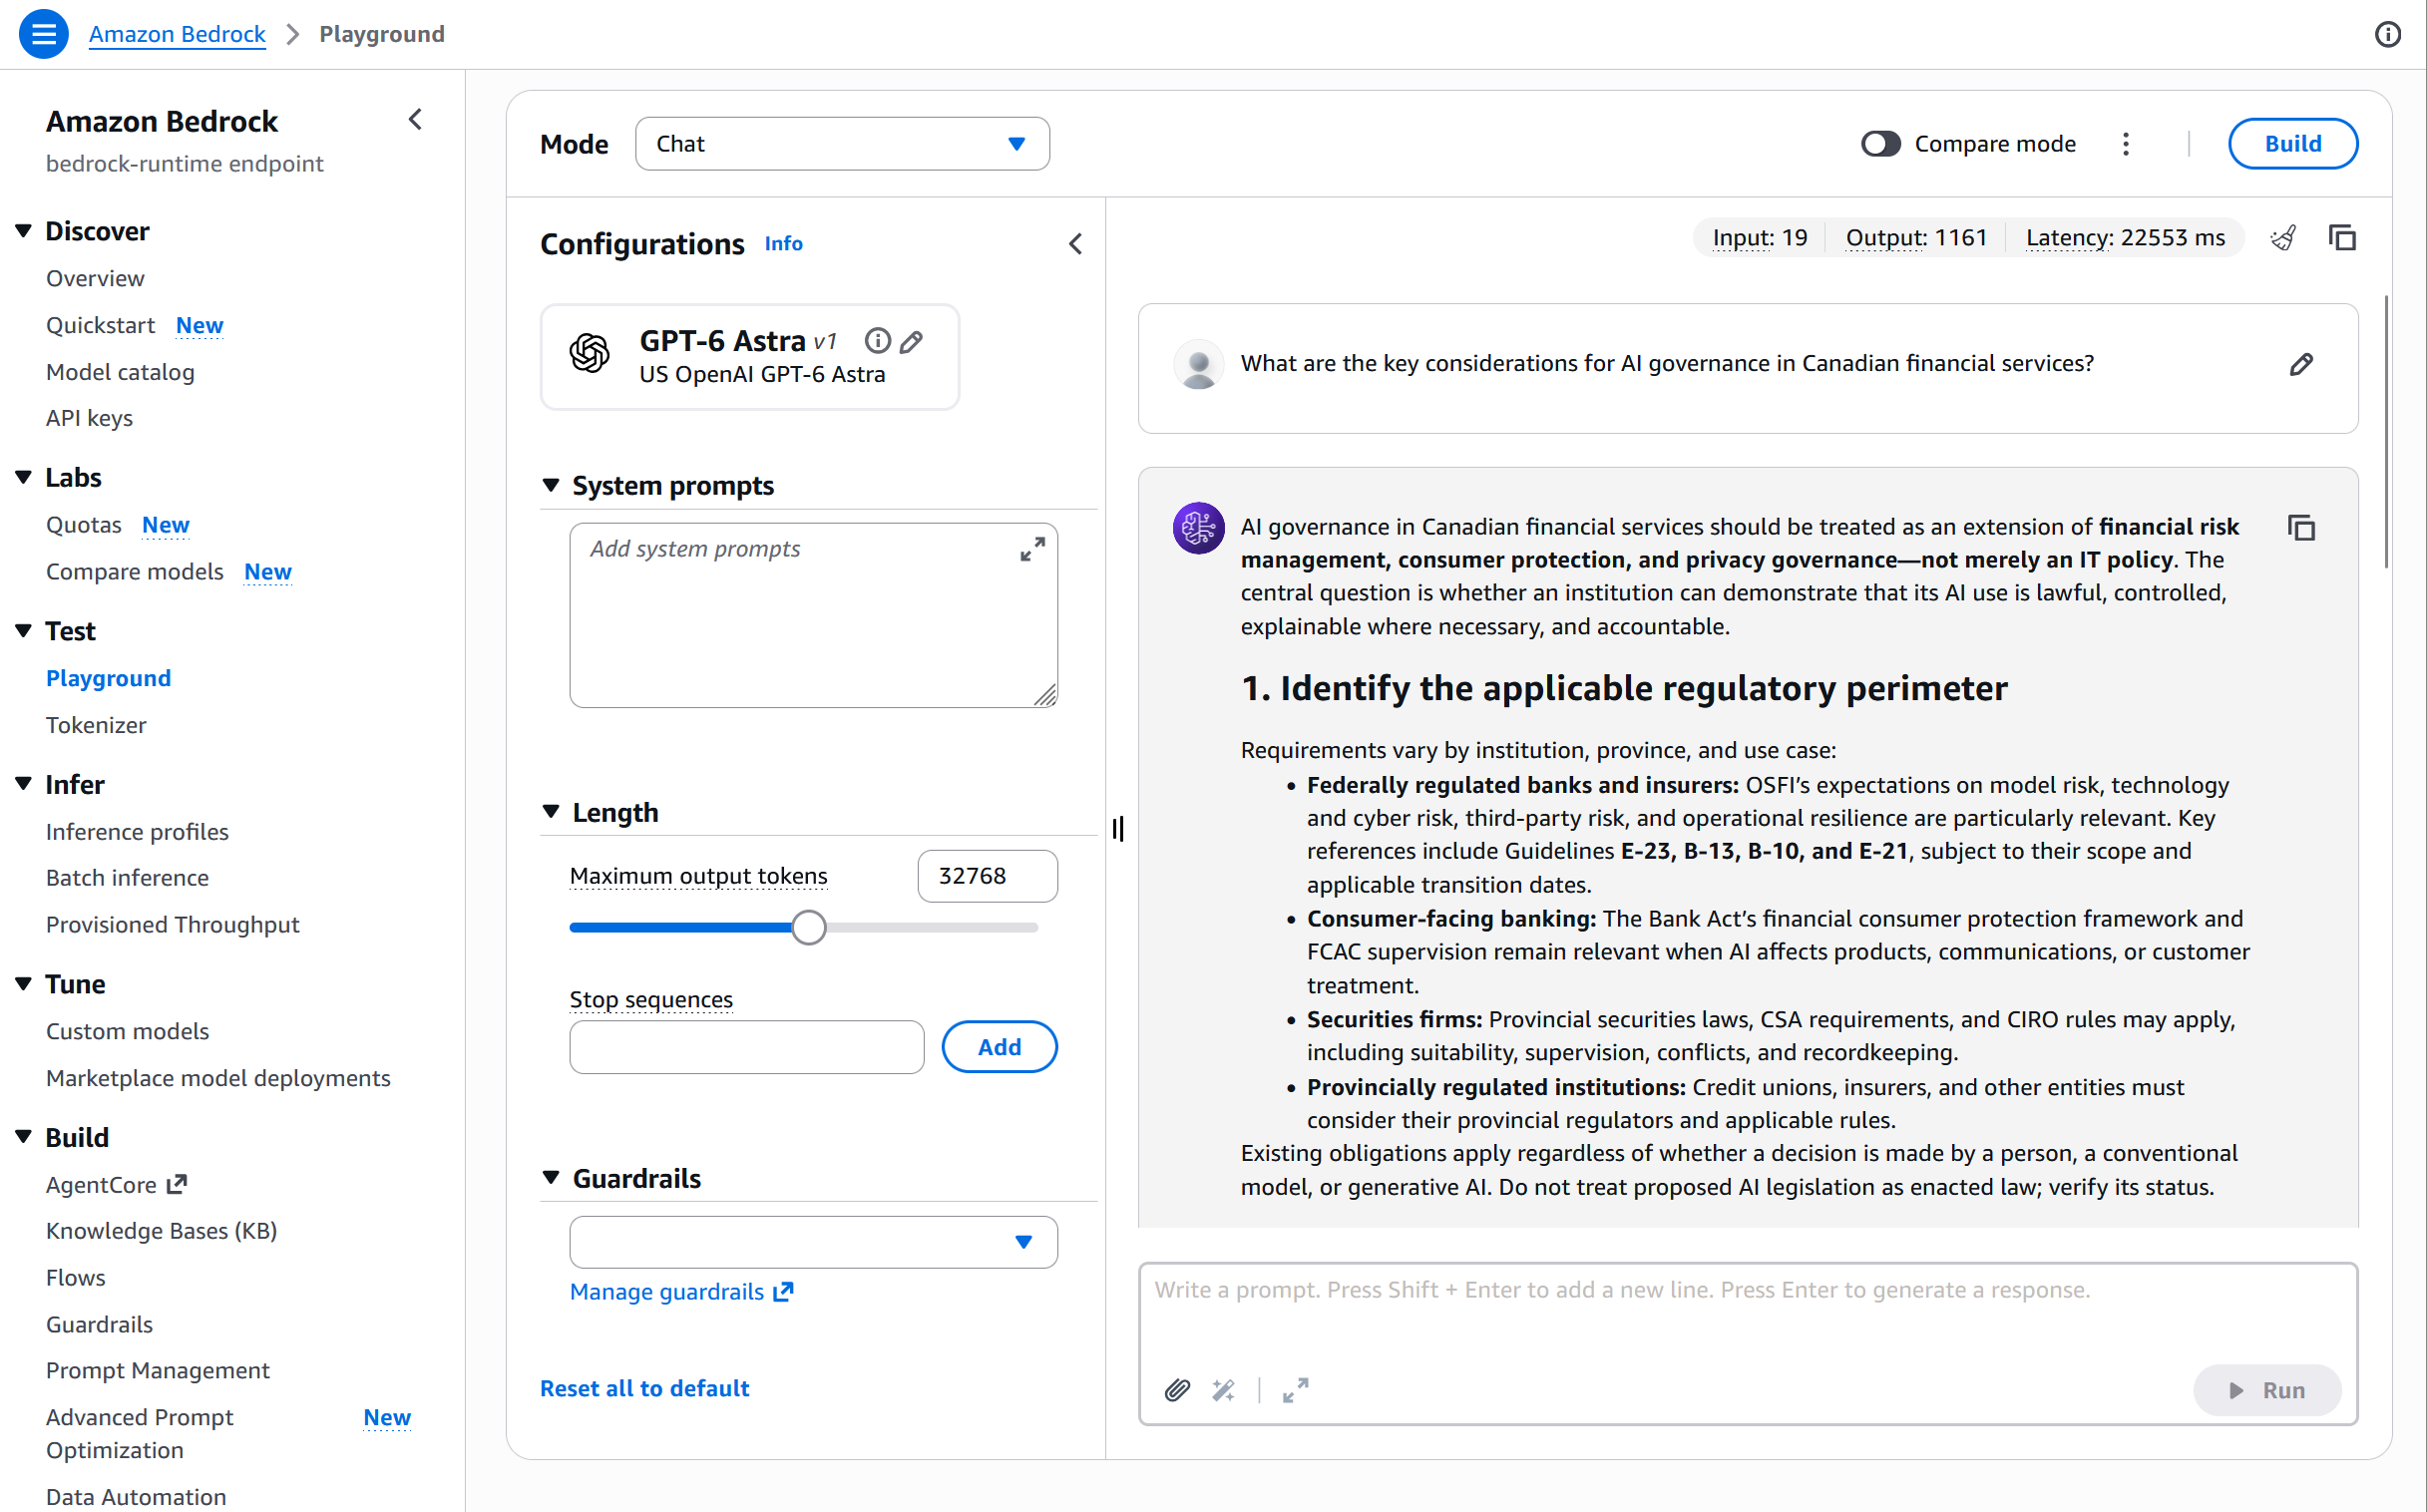
Канадские организации, использующие Amazon Bedrock, теперь могут получить доступ к новейшим моделям OpenAI, включая GPT-6, в канадских регионах AWS с возможностью использования ресурсов из других регионов. Доступные в Канаде модели предлагают широкий спектр возможностей, от сложных вычислений до быстрой и экономичной работы, поддерживая текстовые и графические входные данные с контекстным окном...
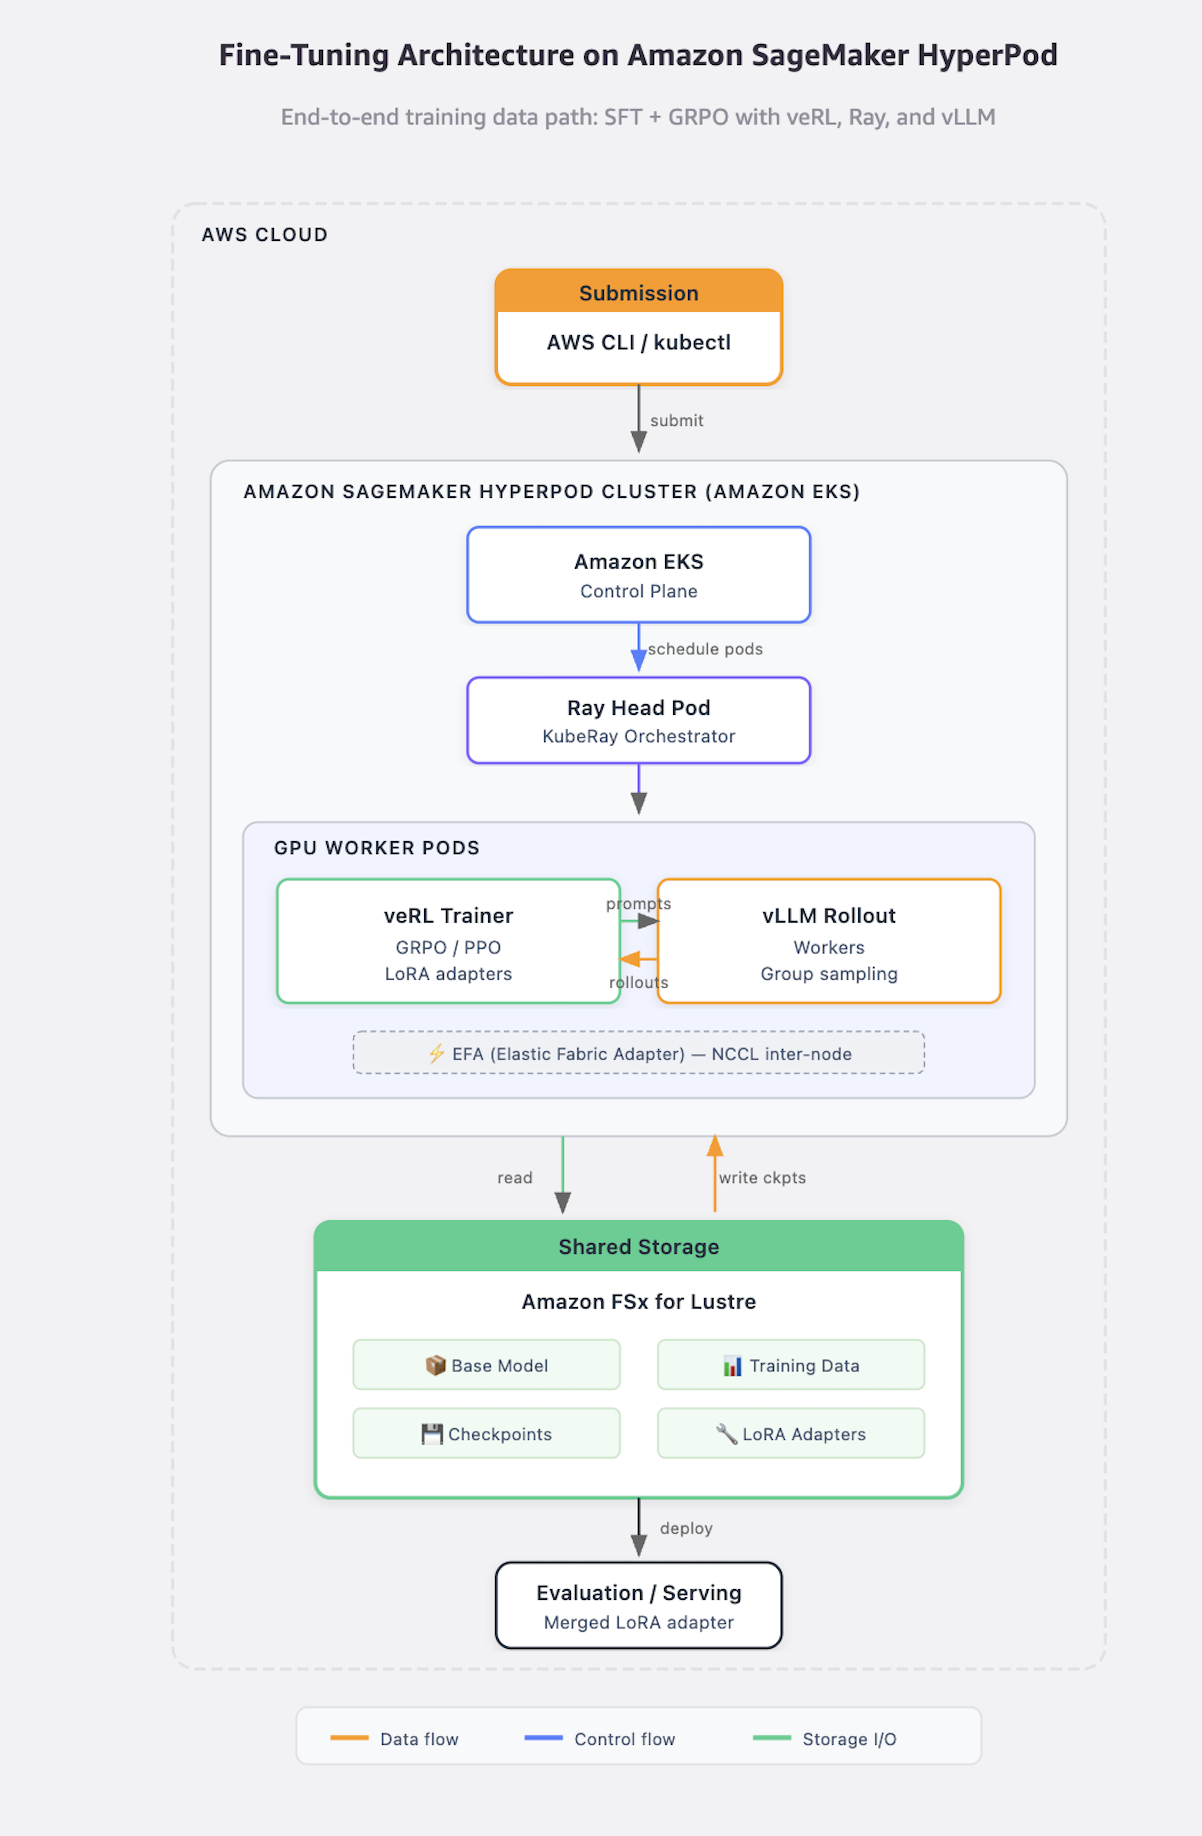
Модель GPT-OSS-20B испытывает трудности с многоязычным анализом и часто использует английский язык. Тонкая настройка модели с использованием методов SFT и GRPO на платформе Amazon SageMaker HyperPod повышает точность работы с разными языками.
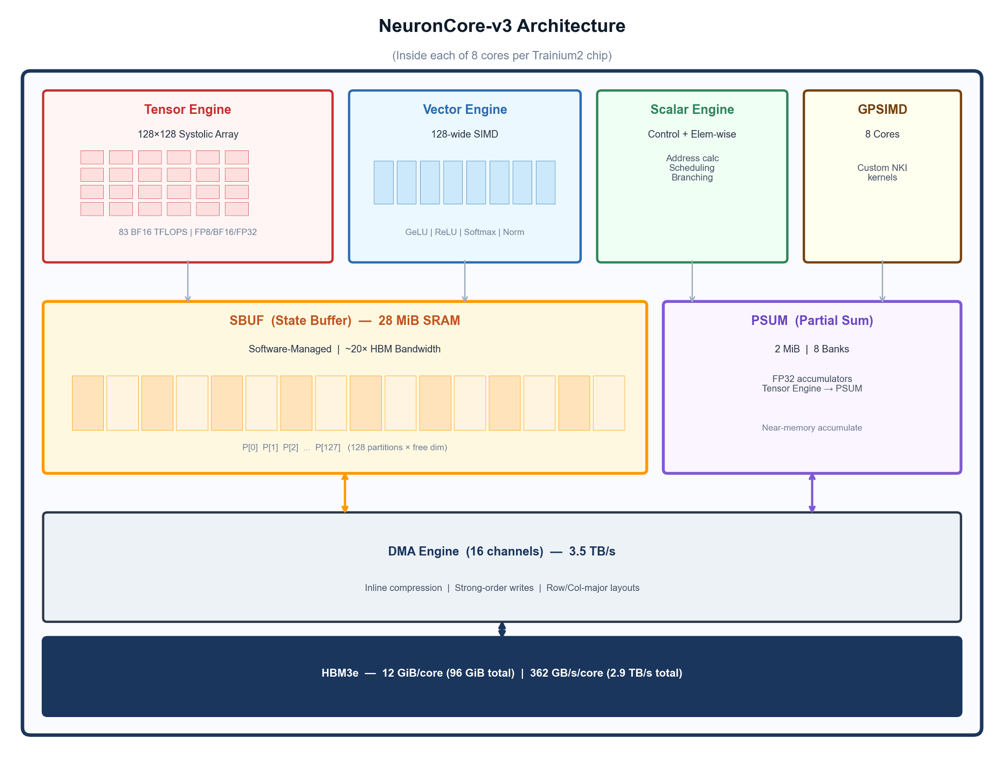
Компания i14 разработала модель Laplace 3B, основанную на механизме линейного внимания, чтобы решить проблемы масштабируемости традиционных больших языковых моделей. Сотрудничая с AWS, они оптимизировали эту модель для процессоров Trainium2, достигнув высокой скорости обучения и фиксированного объема памяти при выполнении вычислений.
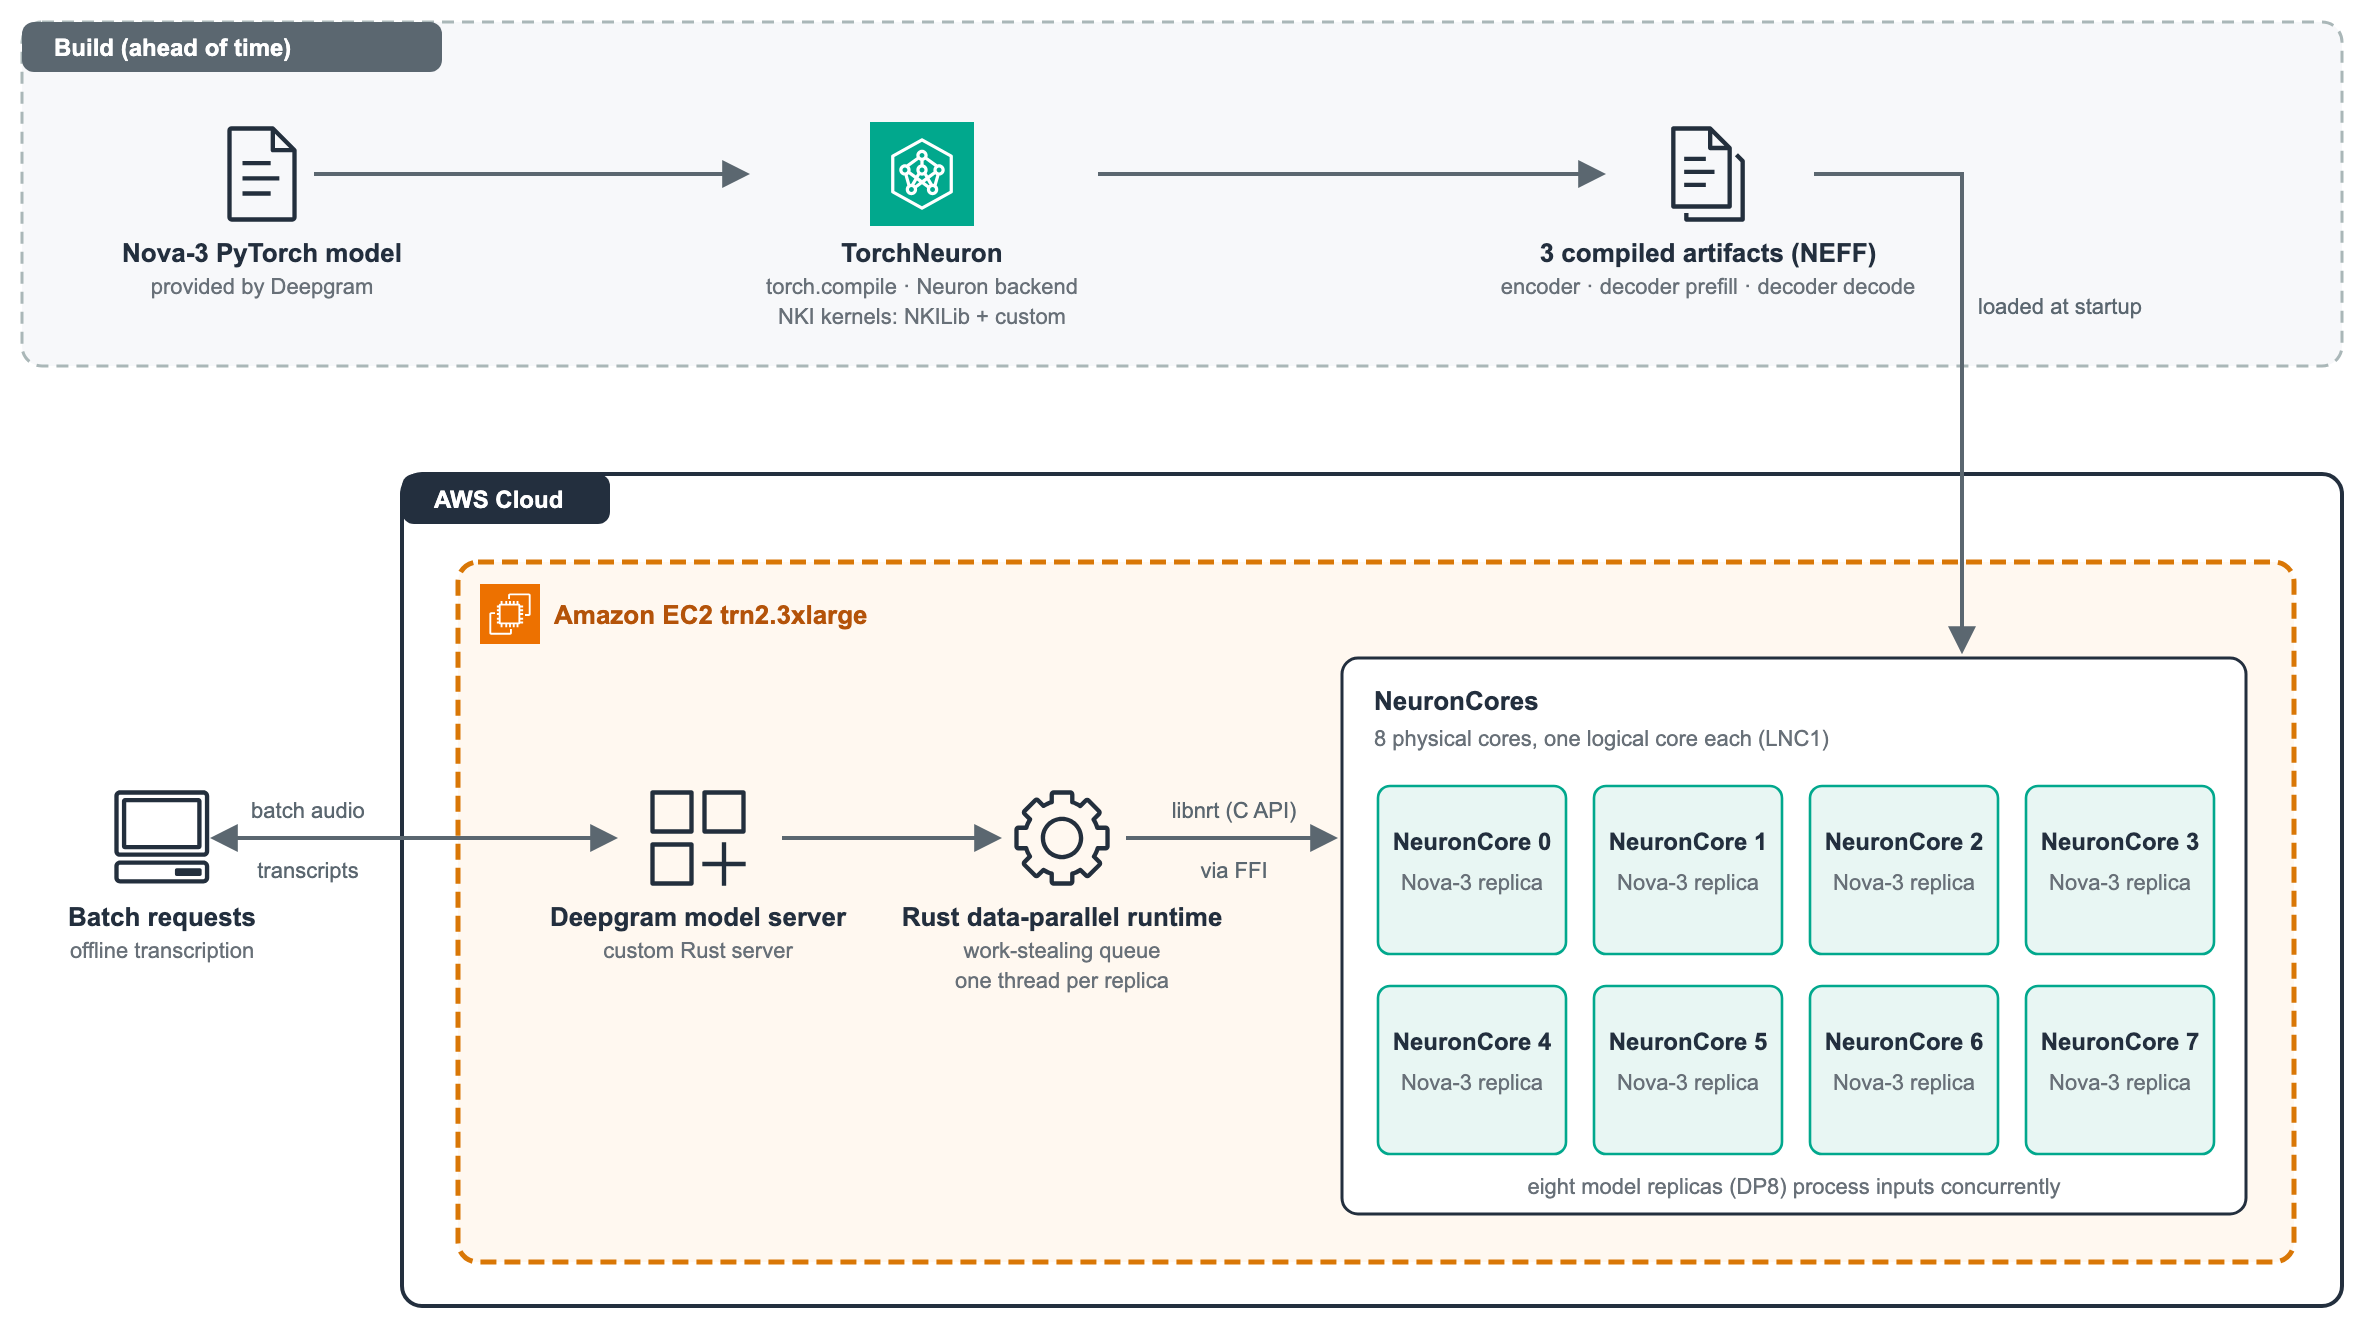
Компания Deepgram использует чипы искусственного интеллекта от AWS для повышения эффективности, позволяя клиентам обрабатывать на 11-70% больше аудиоданных за ту же цену. Deepgram и AWS сотрудничают для оптимизации Nova-3 на процессорах Trainium2, что улучшает работу моделей преобразования речи в текст.
Amazon SageMaker JumpStart предлагает тщательно подобранный каталог моделей искусственного интеллекта, шаблонов и блокнотов, что упрощает выбор и развертывание моделей машинного обучения. Ведущие поставщики, такие как Alibaba, NVIDIA и Google, предоставляют разнообразные модели для поиска, развертывания и настройки.
Германский канцлер Фридрих Мерц и генеральный директор компании NVIDIA Дженсен Хуанг обсудили стратегию развития искусственного интеллекта в Германии на предприятии Kraftwerk, подчеркнув применение ИИ в промышленности и автомобилестроении. Германия стремится объединить инженерные знания с технологиями искусственного интеллекта, сотрудничая с компанией NVIDIA для разработки промышленных моделей ...
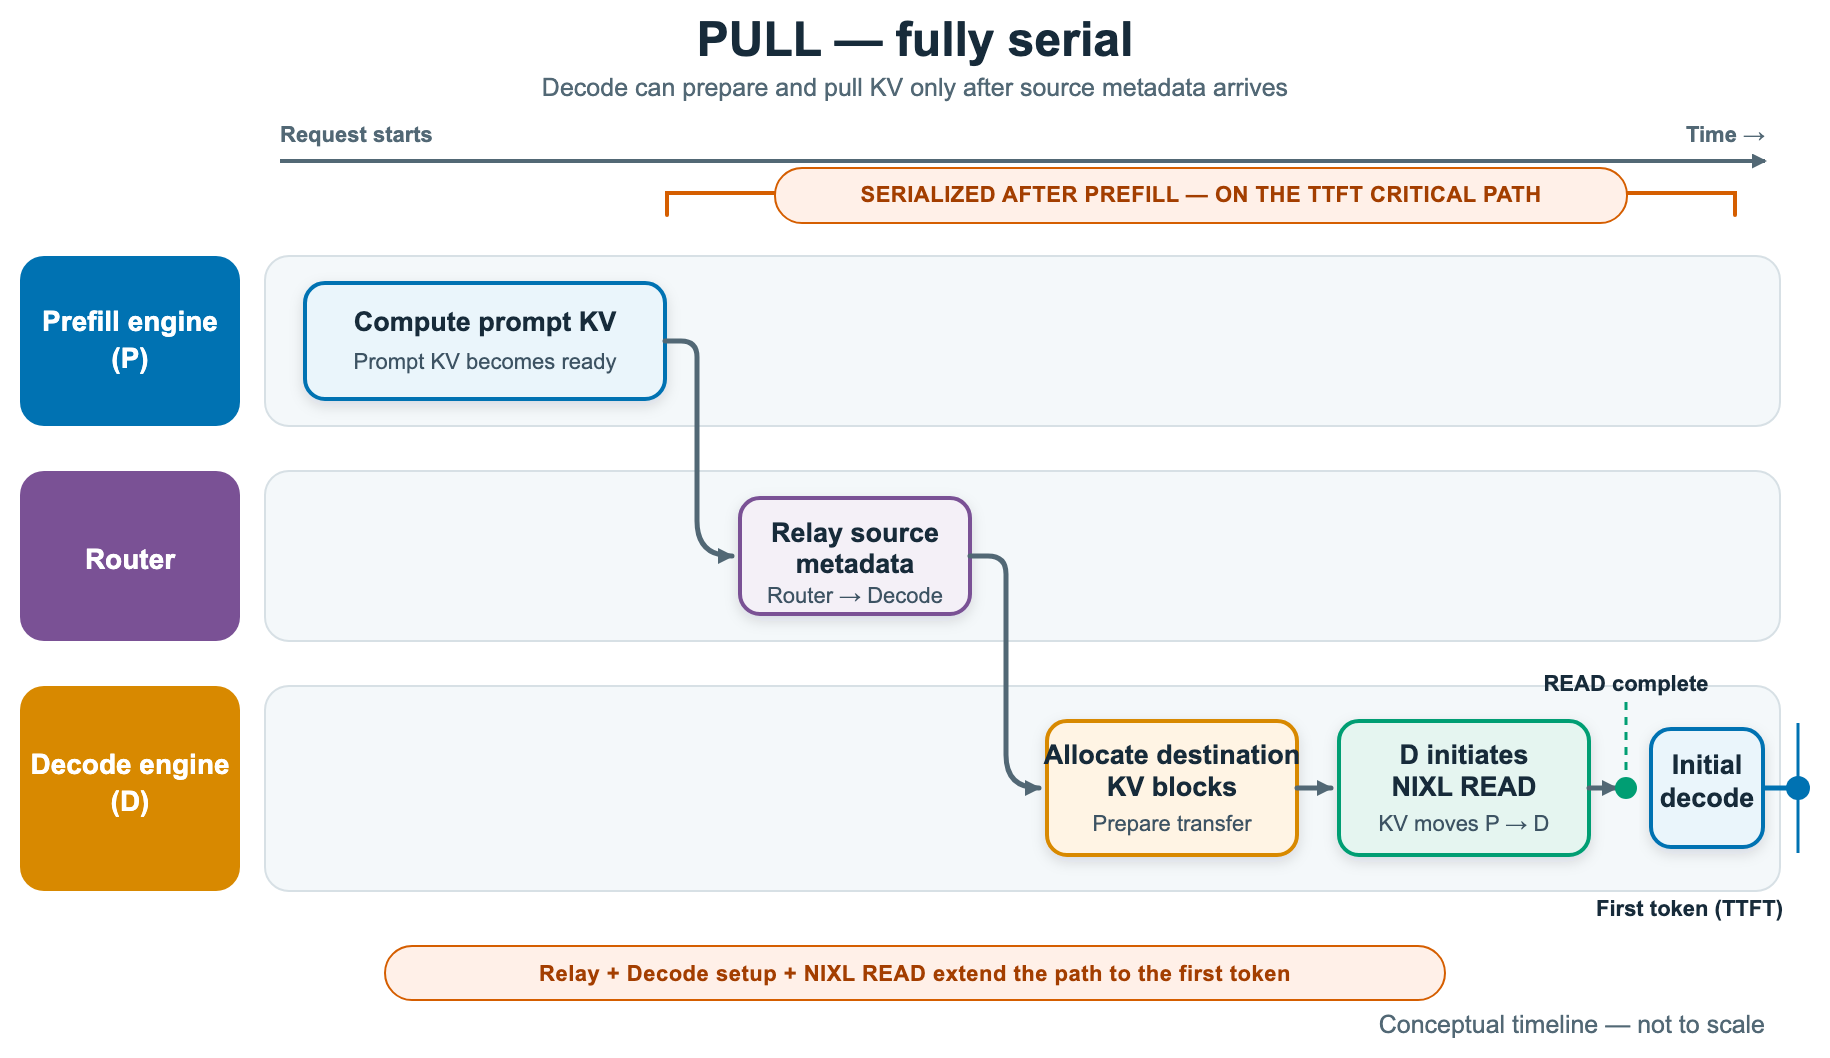
vLLM представляет собой коннектор NIXL, работающий по принципу "push", который обеспечивает эффективную передачу данных KV и сокращает время генерации первого токена. Тестирование показало, что в режиме "push" скорость генерации первого токена для модели Qwen3-32B на инстансах Amazon EC2 P5en с поддержкой EFA может быть в 3 раза выше по сравнению с режимом "pull".