
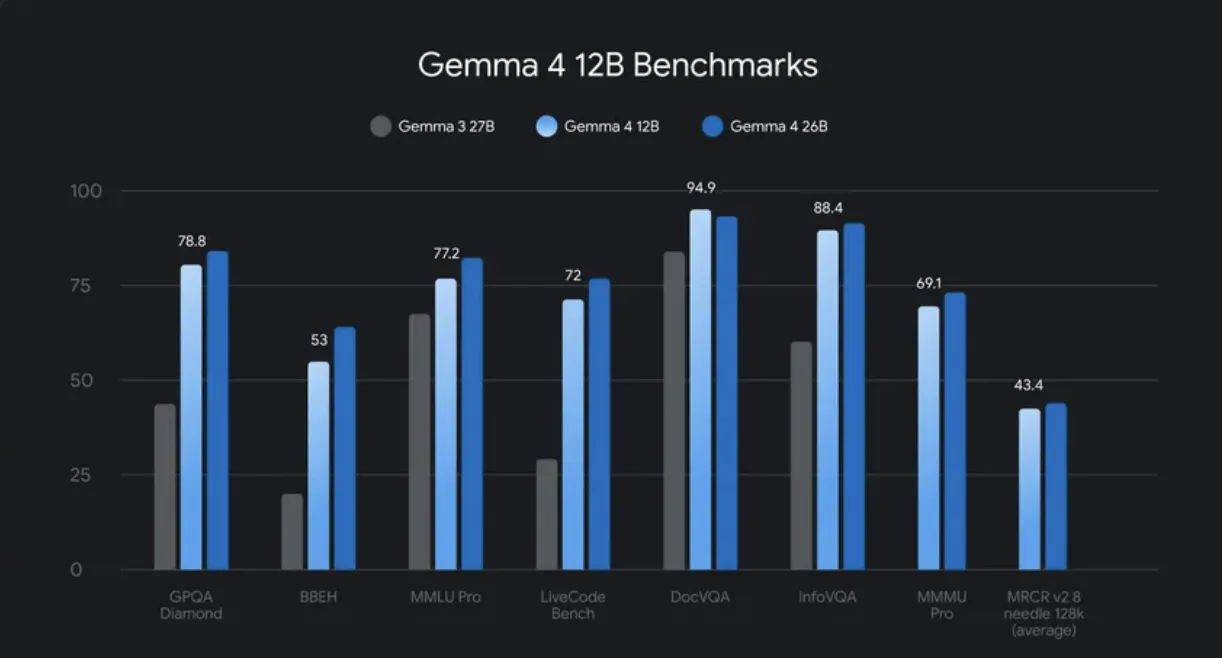
Компанія Google DeepMind випустила Gemma 4 12B — мультимодальну модель без енкодера для обробки тексту, зображень, аудіо та відео. Модель працює на ноутбуці з 16 ГБ оперативної пам’яті, заповнюючи прогалину між версіями для периферійних пристроїв та більш потужними варіантами; вагові матриці з відкритим кодом доступні для завантаження.
Дослідники з Массачусетського технологічного інституту (MIT) та Лабораторії обчислювальних досліджень MIT-IBM розробили ChartNet — набір даних та серію моделей з відкритим кодом, які перевершують комерційні моделі штучного інтелекту у виконанні таких завдань, як інтерпретація діаграм. Цей прорив може надати можливість...
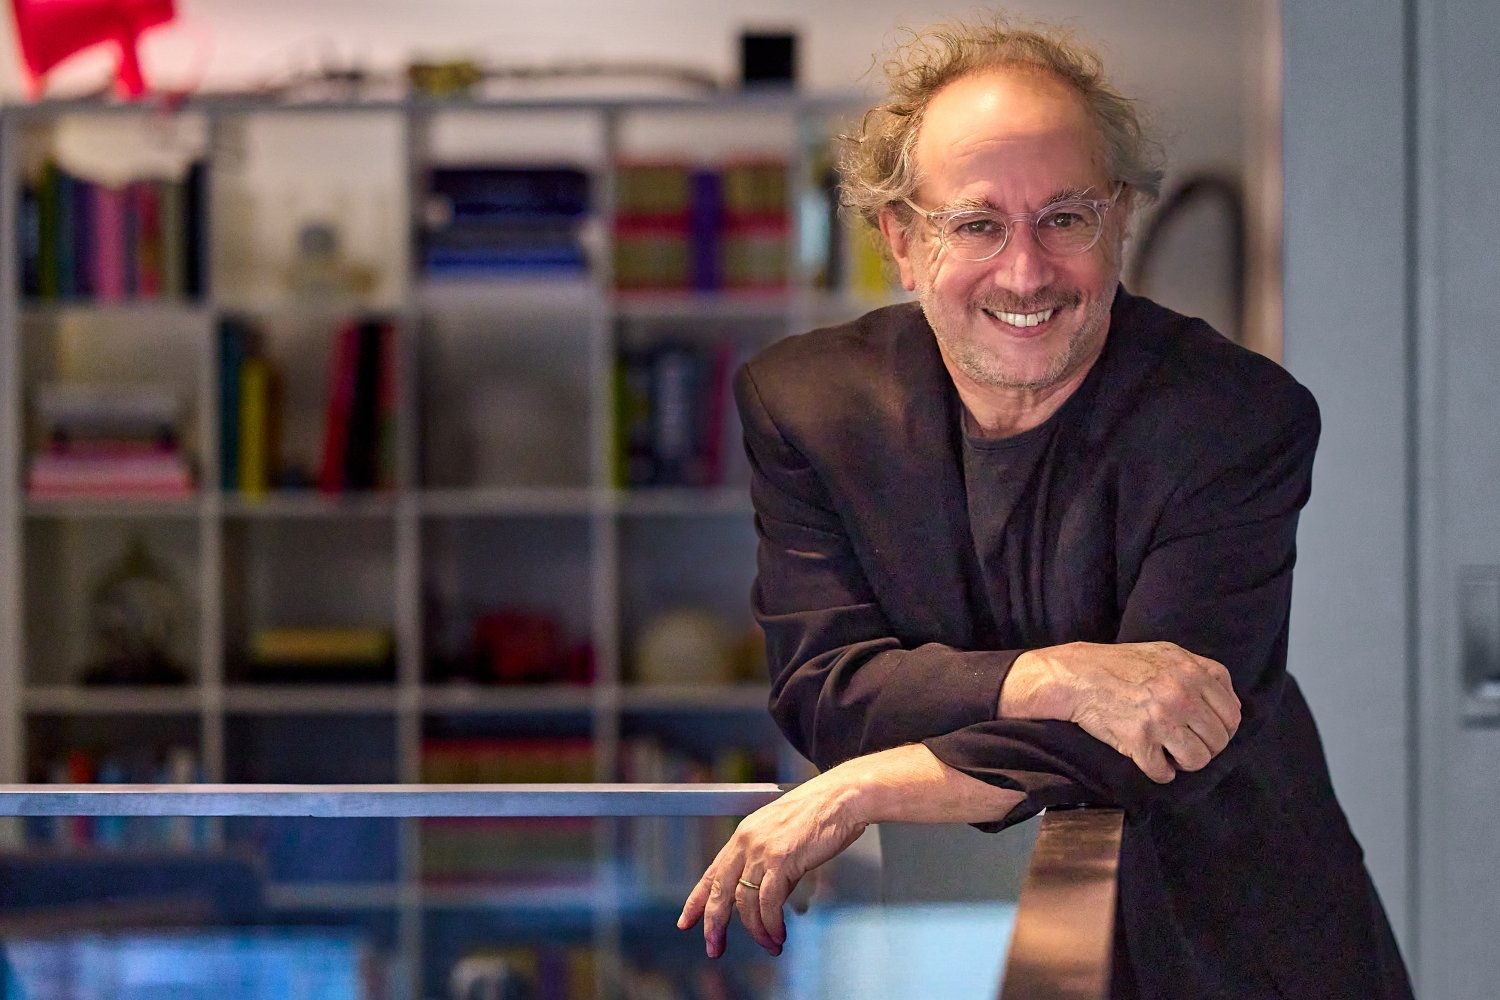
Тод Мачовер, піонер у галузі музичних технологій з MIT Media Lab, отримав медаль Джорджа Пібоді за новаторську роботу в галузі штучного інтелекту та інтерактивної опери. Мачовер, якого називають музичним провидцем, розширює межі та можливості музики для всіх.
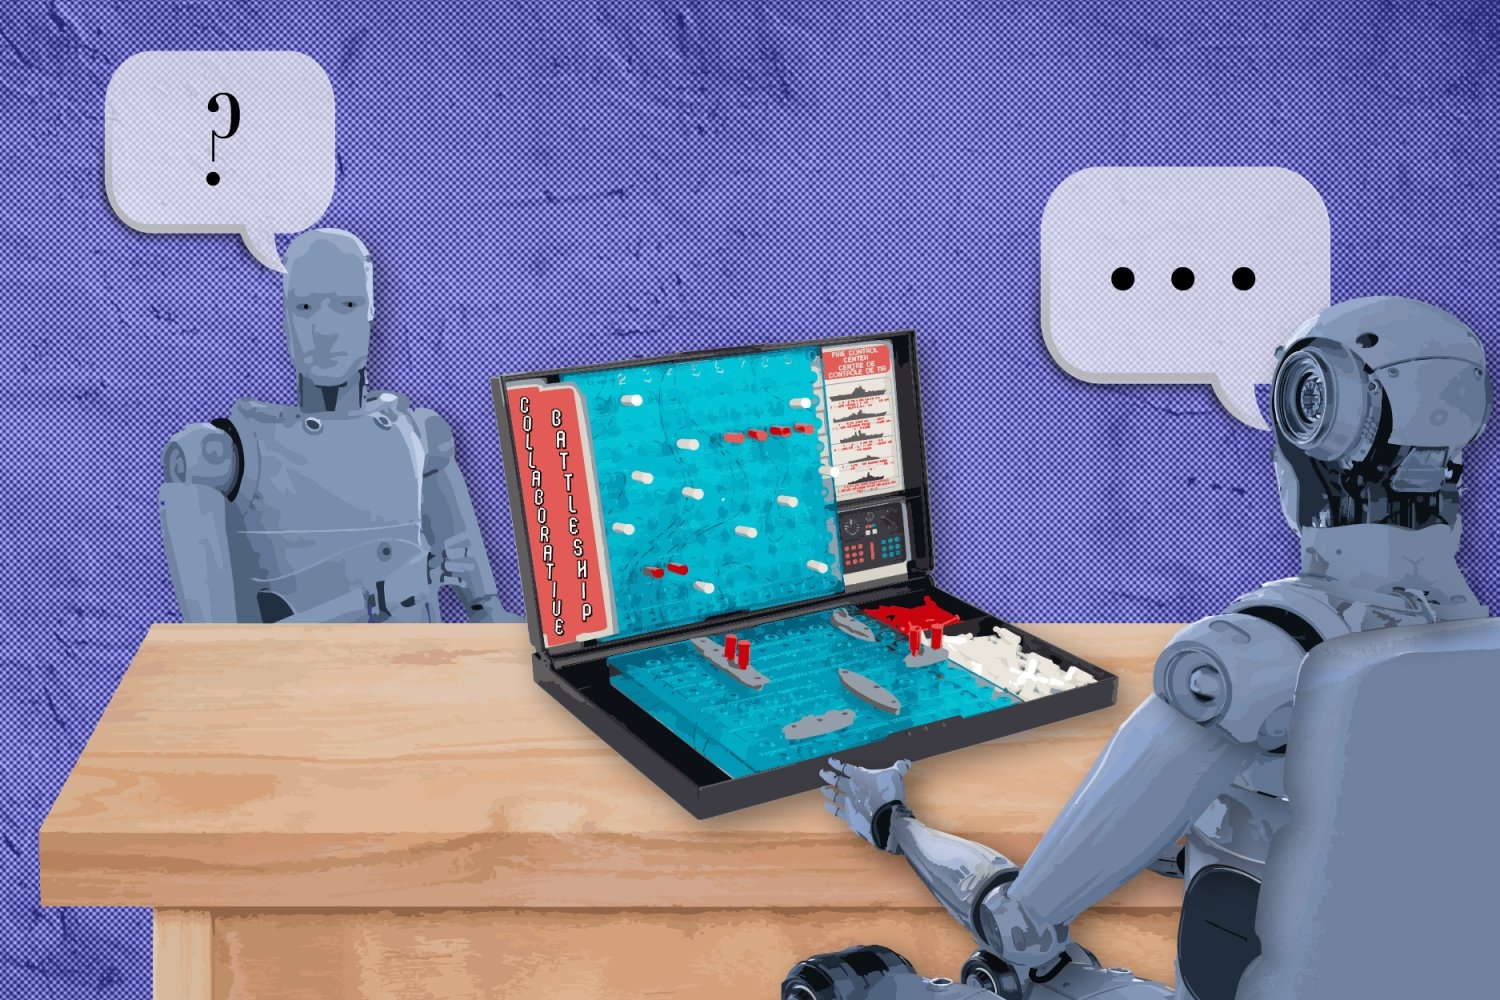
У 2026 році штучний інтелект чудово справляється з такими завданнями, як обслуговування клієнтів, але зазнає труднощів із складними запитами. Дослідники з Массачусетського технологічного інституту та Гарвардського університету вдосконалили здатність штучного інтелекту ставити запитання за допомогою гри «Морський бій», що дозволило досягти значного підвищення продуктивності та ефективності.
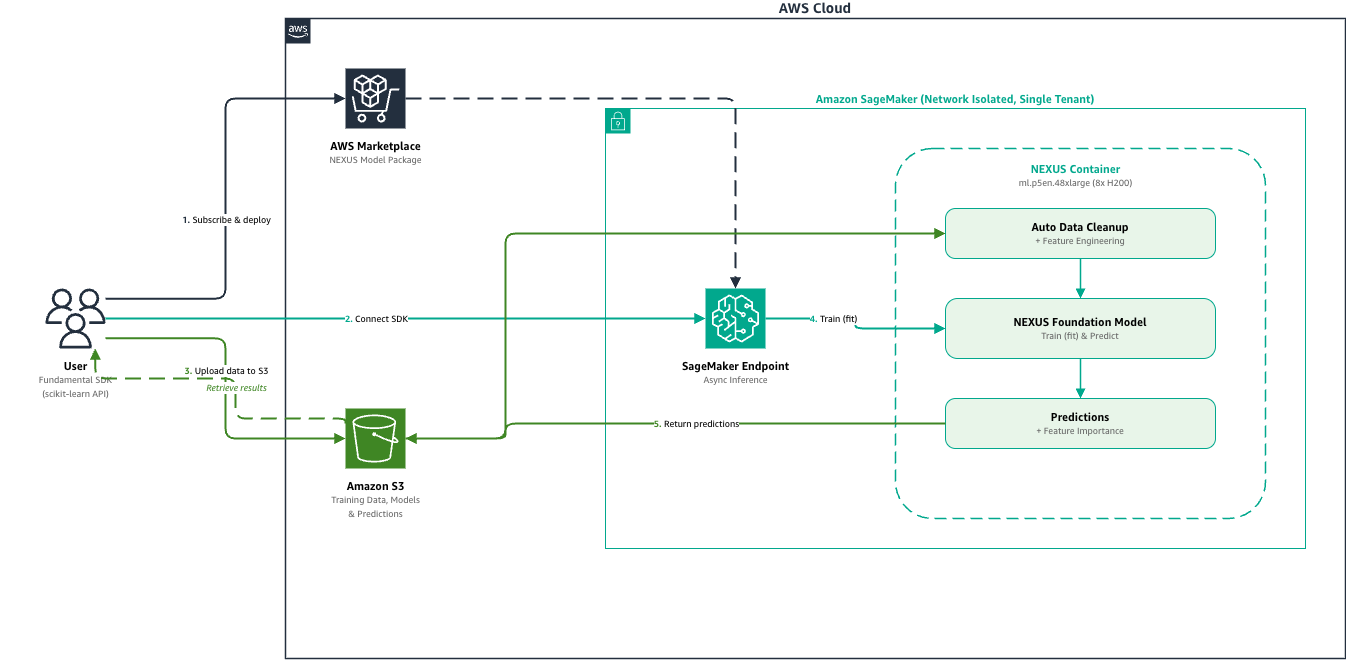
Amazon SageMaker AI тепер підтримує модель NEXUS від Fundamental, що дозволяє отримувати точні прогнози щодо табличних даних за лічені дні. NEXUS забезпечує детерміновані результати, вбудоване розуміння табличних даних та несеквенційне міркування для аналізу структурованих даних.
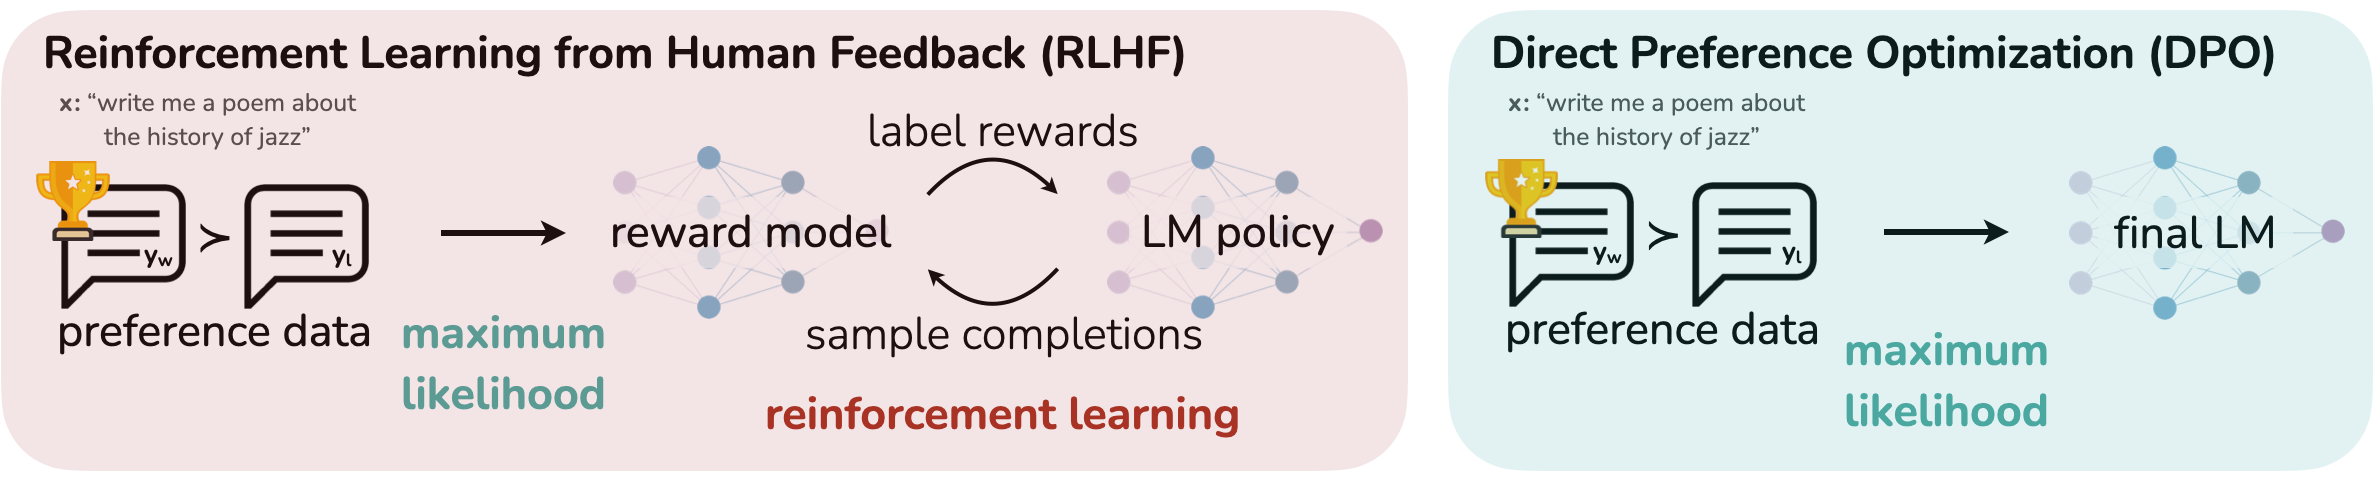
Штучний інтелект повинен підбирати відповідні інструменти для виконання завдань, щоб уникнути помилок і затримок. Дізнайтеся, як SFT і DPO підвищують точність виклику інструментів у мовних моделях для надійної автоматизації.
Компанія TinyFish представляє BigSet — багатоагентну систему з відкритим кодом, призначену для створення структурованих наборів даних на основі даних з Інтернету в режимі реального часу за допомогою введення на природній мові. BigSet автоматизує визначення схеми, збір даних та їх дедуплікацію, а також забезпечує планове оновлення для отримання актуальних наборів даних.
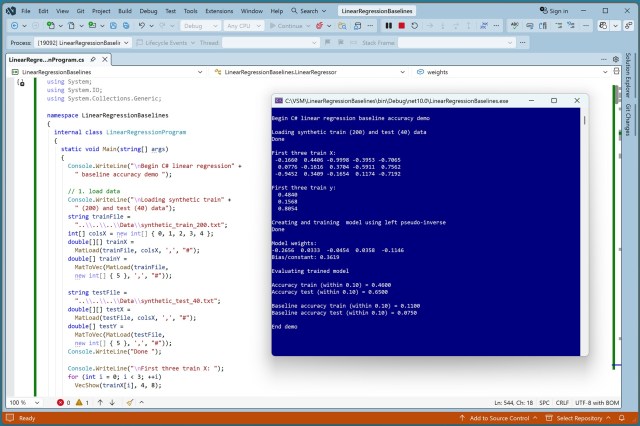
Демонстраційна модель лінійної регресії демонструє точність 46 % на навчальних даних, перевершуючи базові прогнози. Журнал «Galaxy Science Fiction», відомий своїми вражаючими обкладинками, публікував роботи відомого художника-космолога Чеслі Бонестелла.
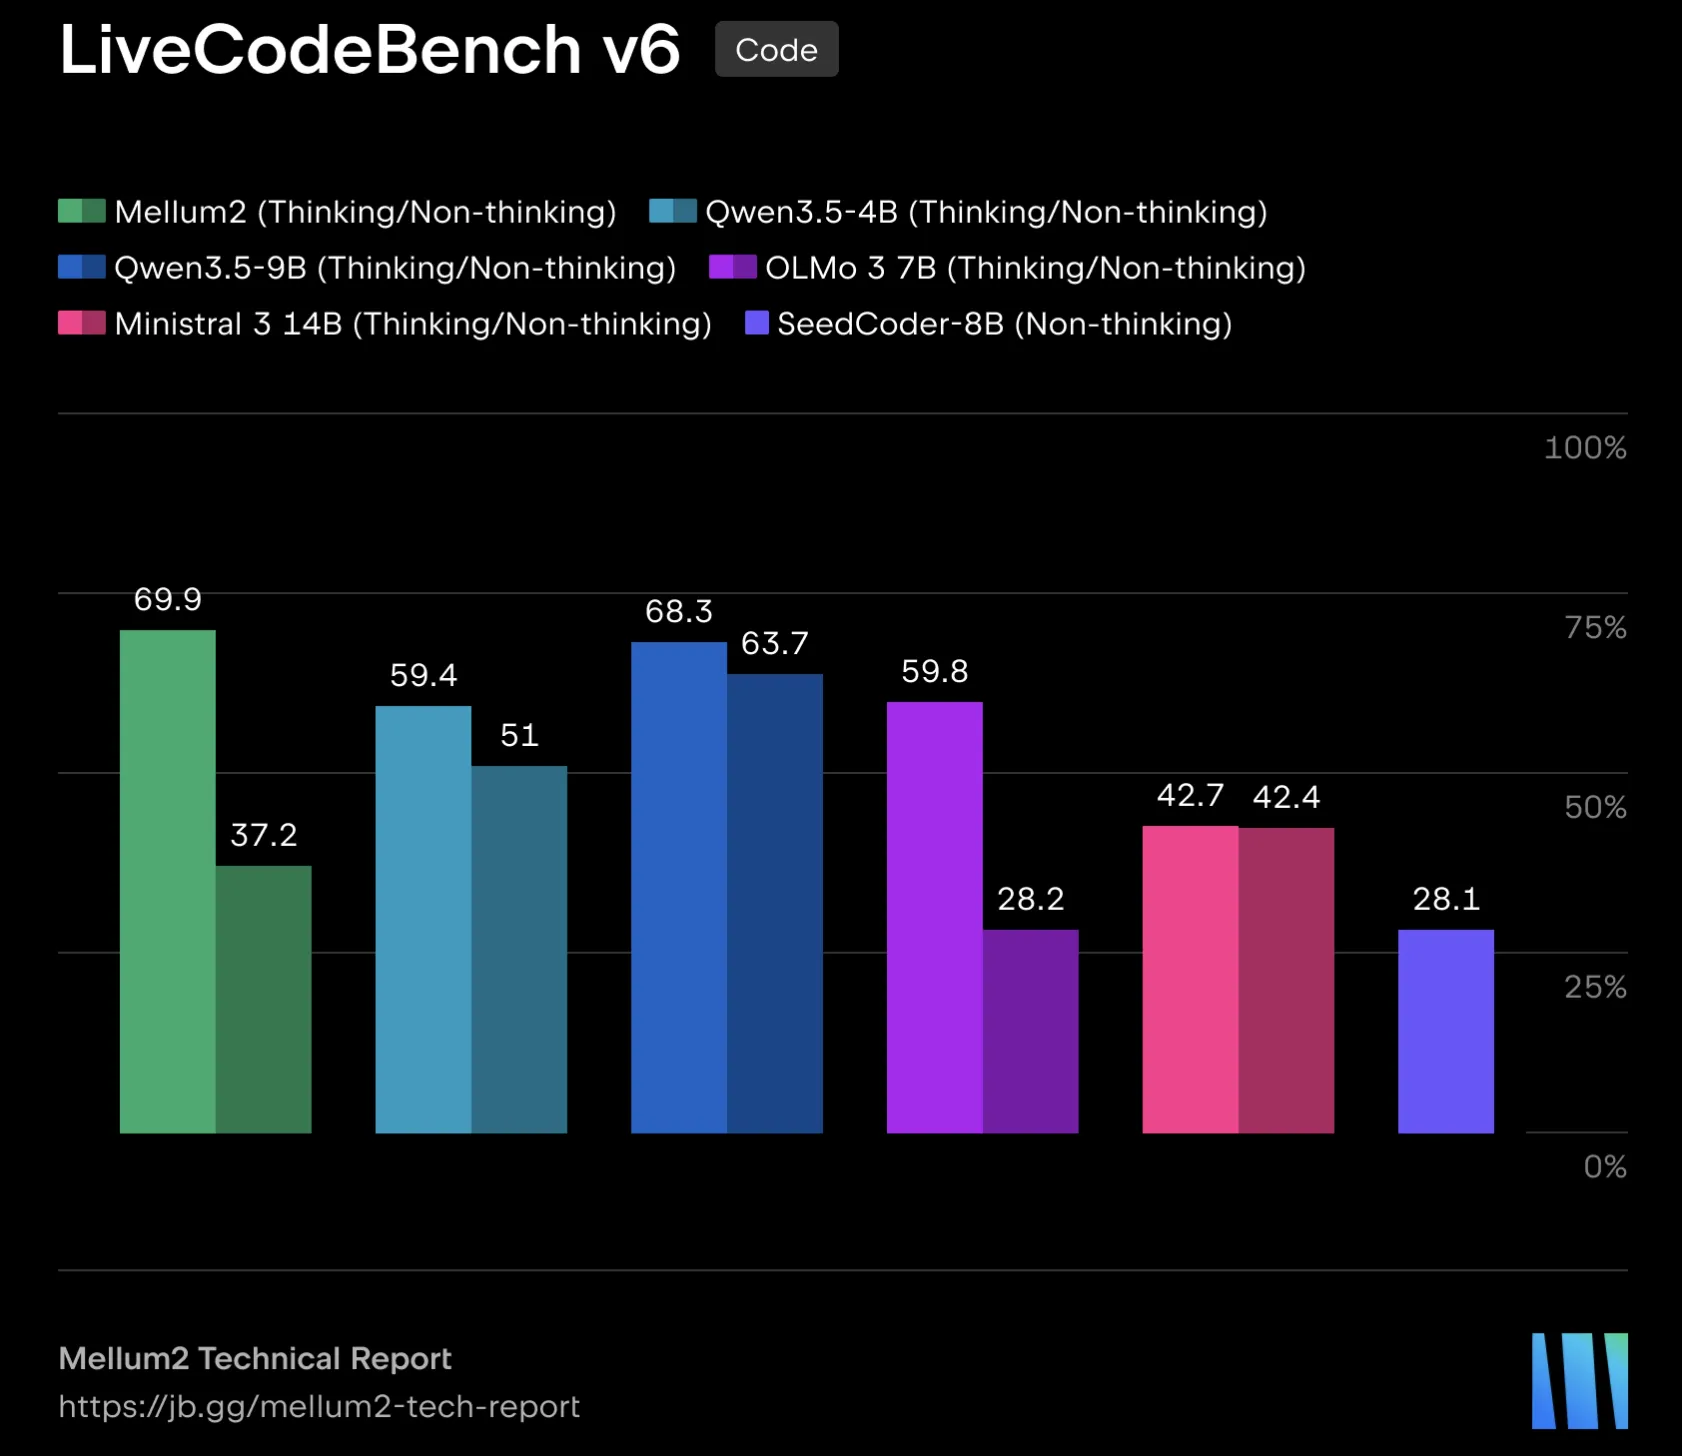
Компанія JetBrains випустила Mellum2, спеціалізовану ШІ-модель для розробки програмного забезпечення, яка має 12 мільярдів параметрів. Вона використовує архітектуру Mixture-of-Experts і проходить численні етапи попереднього та подальшого навчання для виконання різних завдань.
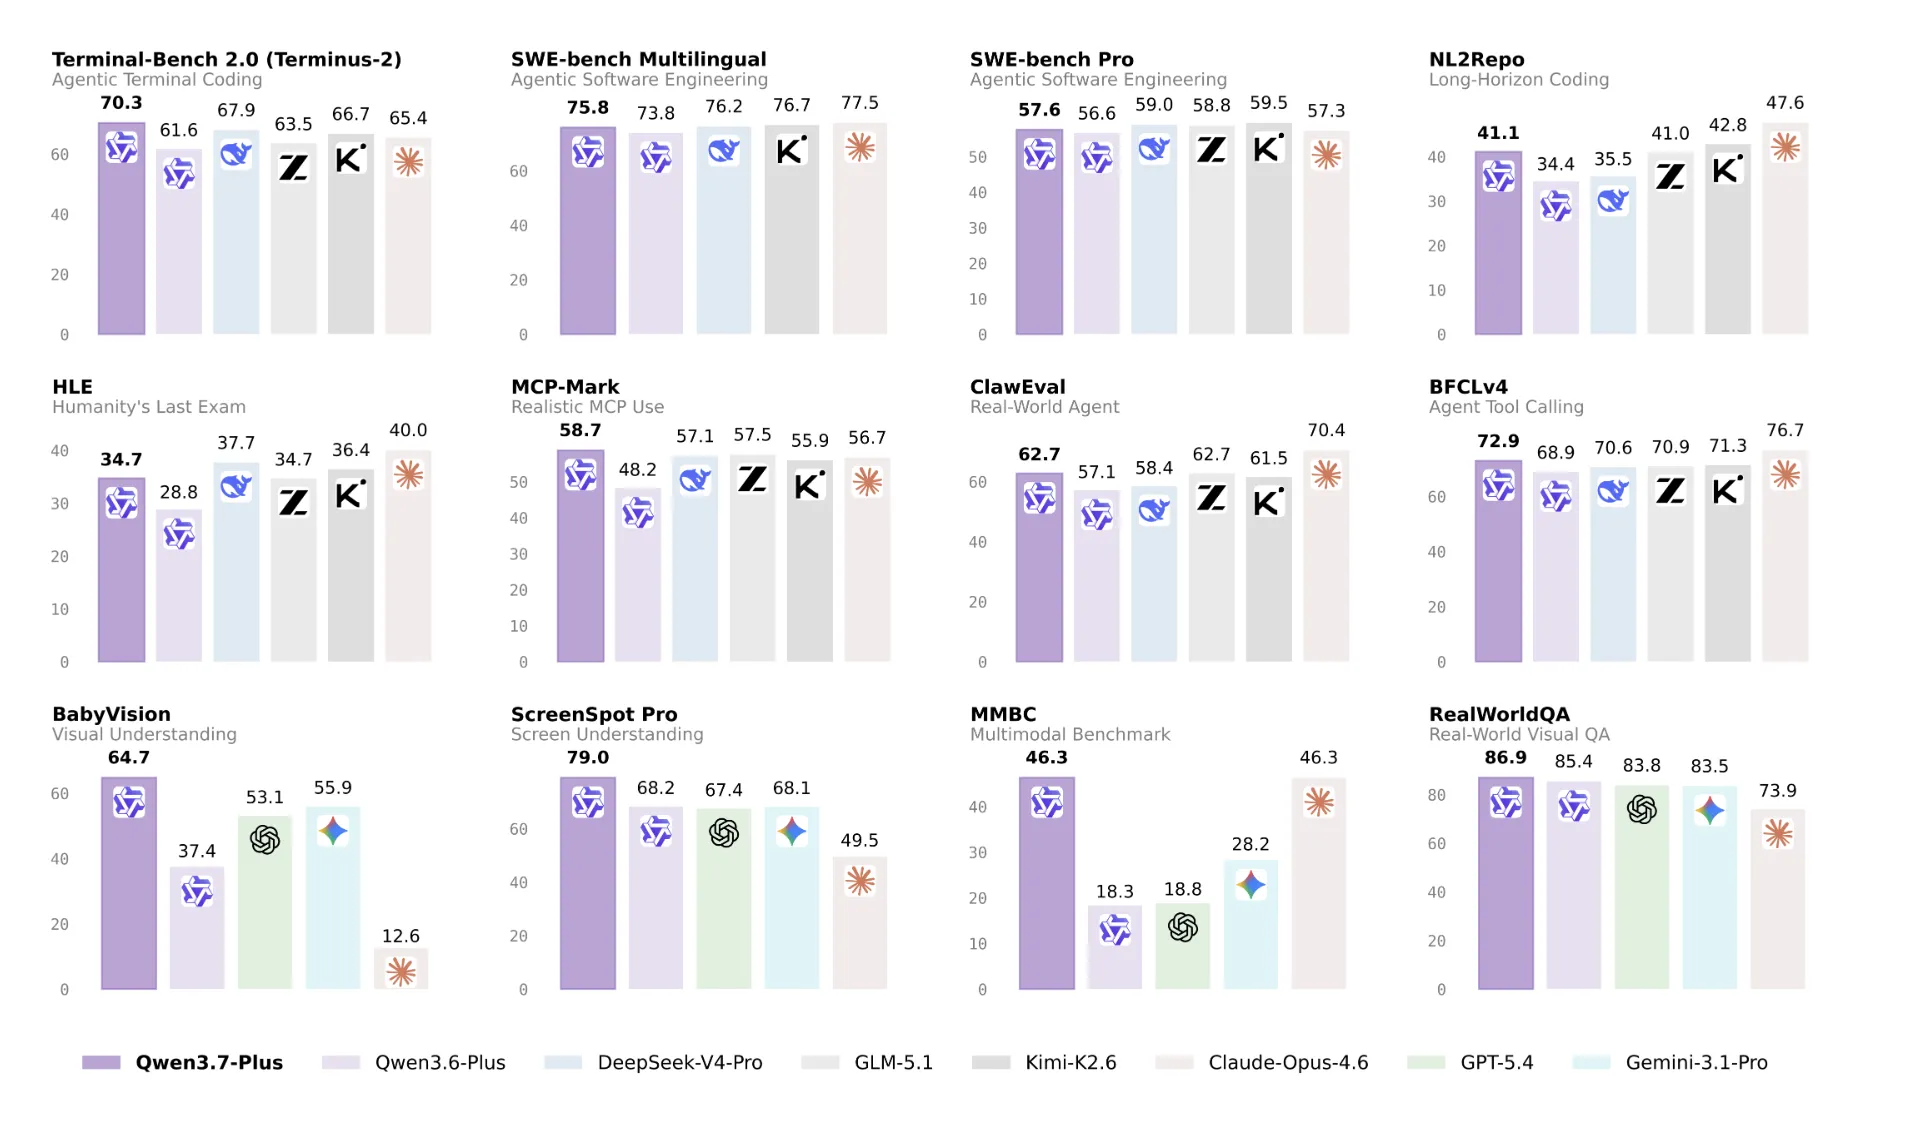
Команда Qwen компанії Alibaba випустила на платформі Bailian модель Qwen3.7-Plus — мультимодальну велику мовну модель, здатну розуміти зображення та відео. Модель зосереджена на таких агентних функціях, як глибоке міркування та самопрограмування, і націлена на виконання дій, а не лише на надання відповідей.
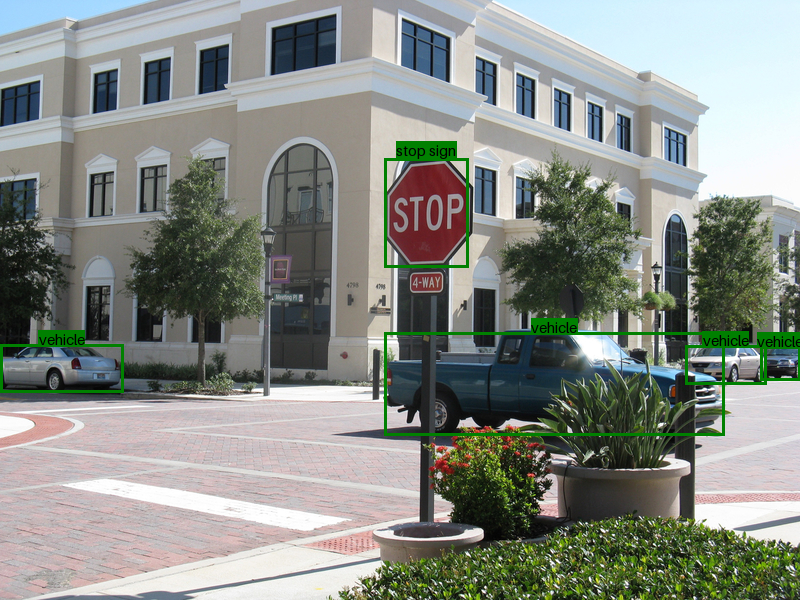
Amazon Nova 2 Lite — це економічно вигідне рішення для виявлення об’єктів, яке не вимагає навчання. Його впровадження за допомогою Amazon Bedrock, AWS Lambda та Amazon API Gateway відбувається швидко та просто, а практичне застосування знаходить у різних галузях.
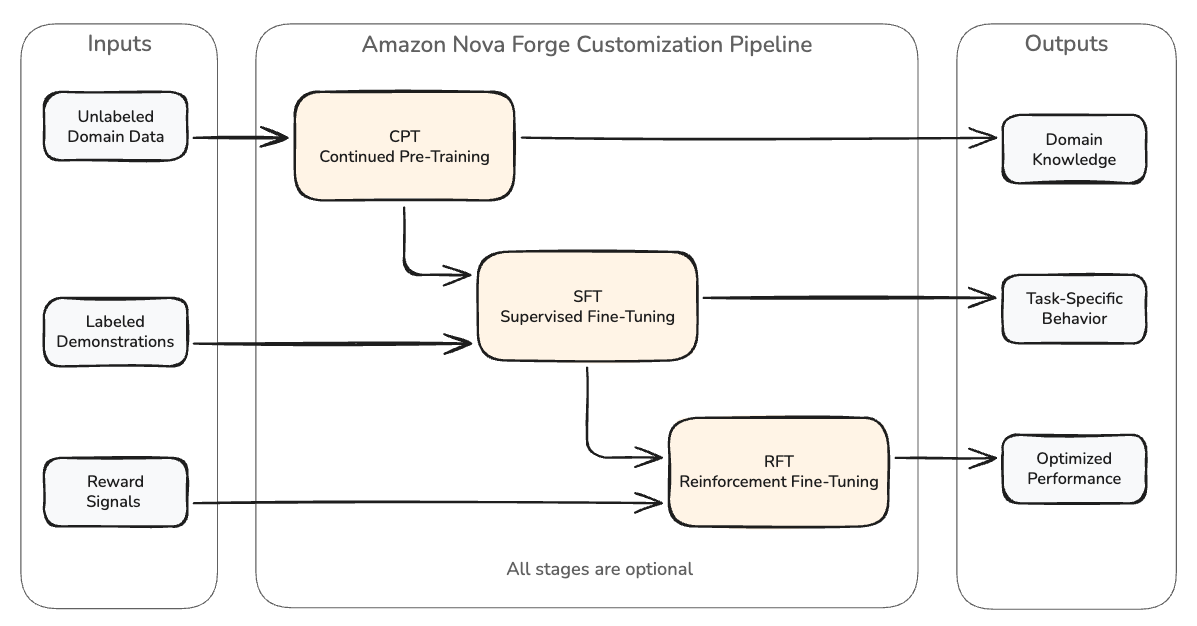
Amazon Nova Forge дозволяє користувачам створювати кастомізовані мовні моделі, які поєднують власні дані з відібраними наборами даних, запобігаючи катастрофічній втраті інформації та покращуючи продуктивність у конкретних областях без шкоди для загальних можливостей. Цей інструмент допомагає вирішувати складні завдання налаштування гіперпараметрів для завдань, специфічних для певної області, за...
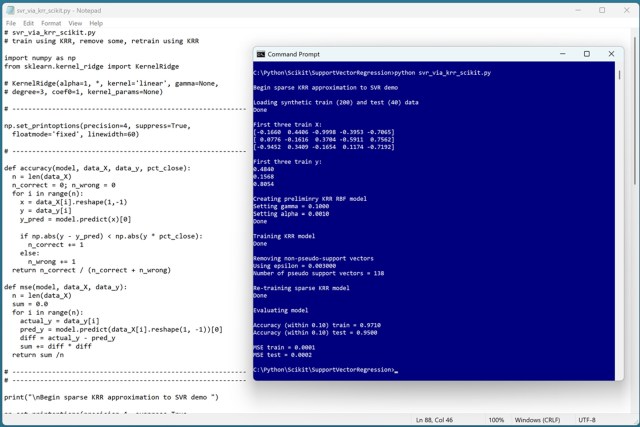
Регресія на ядровому риджі (KRR) та регресія на опорних векторах (SVR) — це методи машинного навчання, які можна поєднати для створення розрідженої моделі KRR, що апроксимує модель SVR. Цей гібридний підхід поєднує в собі переваги KRR щодо обробки великих наборів даних та ефективність SVR у зберіганні моделей, демонструючи високу точність прогнозування в демонстраційному прикладі з використанн...
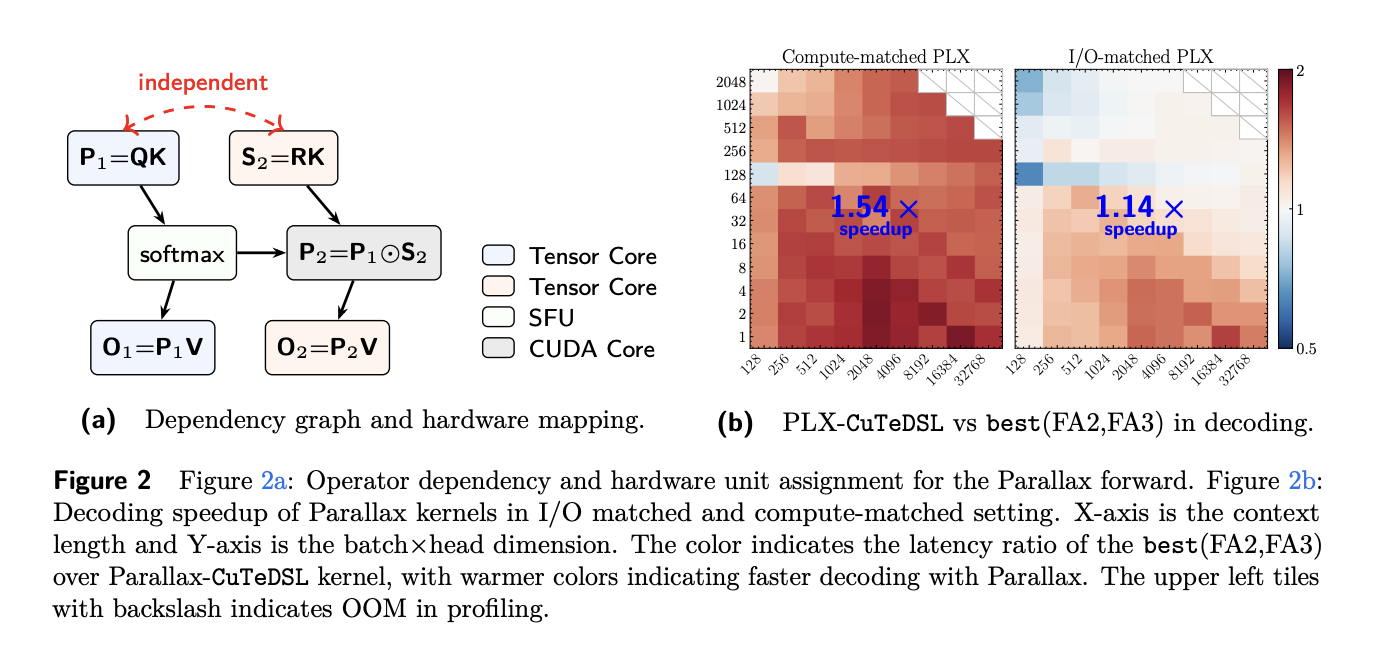
У новій статті представлено Parallax — параметризовану версію локальної лінійної уваги (LLA) для трансформерів, яка підвищує ефективність без скорочення обчислювальних витрат. Parallax замінює обчислювач лінійних систем у LLA на навчену матрицю проекції, що спрощує алгоритм, підвищує його ефективність та полегшує реалізацію.
Amazon Bedrock тепер пропонує GPT-5.5, GPT-5.4 та Codex для виробничих додатків штучного інтелекту. GPT-5.5 демонструє високу ефективність у програмуванні та роботі з інформацією, а також відрізняється покращеною здатністю виконувати багатоетапні завдання та підвищеною автономністю.