

Proofpoint інтегрує Amazon Q Business, штучний інтелект-асистент, що підвищує продуктивність на 40% і економить 18 300 годин на рік. Спеціальні додатки оптимізують надання послуг, підвищують кваліфікацію команд і збільшують цінність для клієнтів.

Вікторіанський адвокат втратив ліцензію за те, що не перевірив цитати, згенеровані штучним інтелектом, у судовій справі. Перші професійні санкції в Австралії за використання штучного інтелекту.

Аналітика баз даних природної мови з використанням Amazon Nova FMs оптимізує складні запити для точного аналізу даних. Агенти покращують взаємодію з користувачами, розбиваючи запити та забезпечуючи самокорекцію, революціонізуючи управління даними за допомогою інтуїтивних взаємодій, схожих на розмову.

Інтелектуальна обробка документів автоматизує вилучення даних з різних форматів, забезпечуючи ефективні робочі процеси в різних галузях. Моделі Amazon Nova в Amazon Bedrock пропонують комплексний підхід до створення та оцінки рішень з вилучення ключової інформації для завдань обробки документів.

OpenAI випустила GPT-OSS, велику мовну модель, яка дозволяє користувачам запускати її локально за допомогою Ollama. Локальне запускання LLM забезпечує економію коштів, надійність та підвищену безпеку, залежно від сценаріїв використання.

Amazon Q Business дозволяє незалежним розробникам програмного забезпечення (ISV) вдосконалювати SaaS-рішення за допомогою безпечного доступу до даних. Trusted Token Issuer спрощує інтеграцію ідентифікаційних даних для детального контролю доступу в Amazon Q.
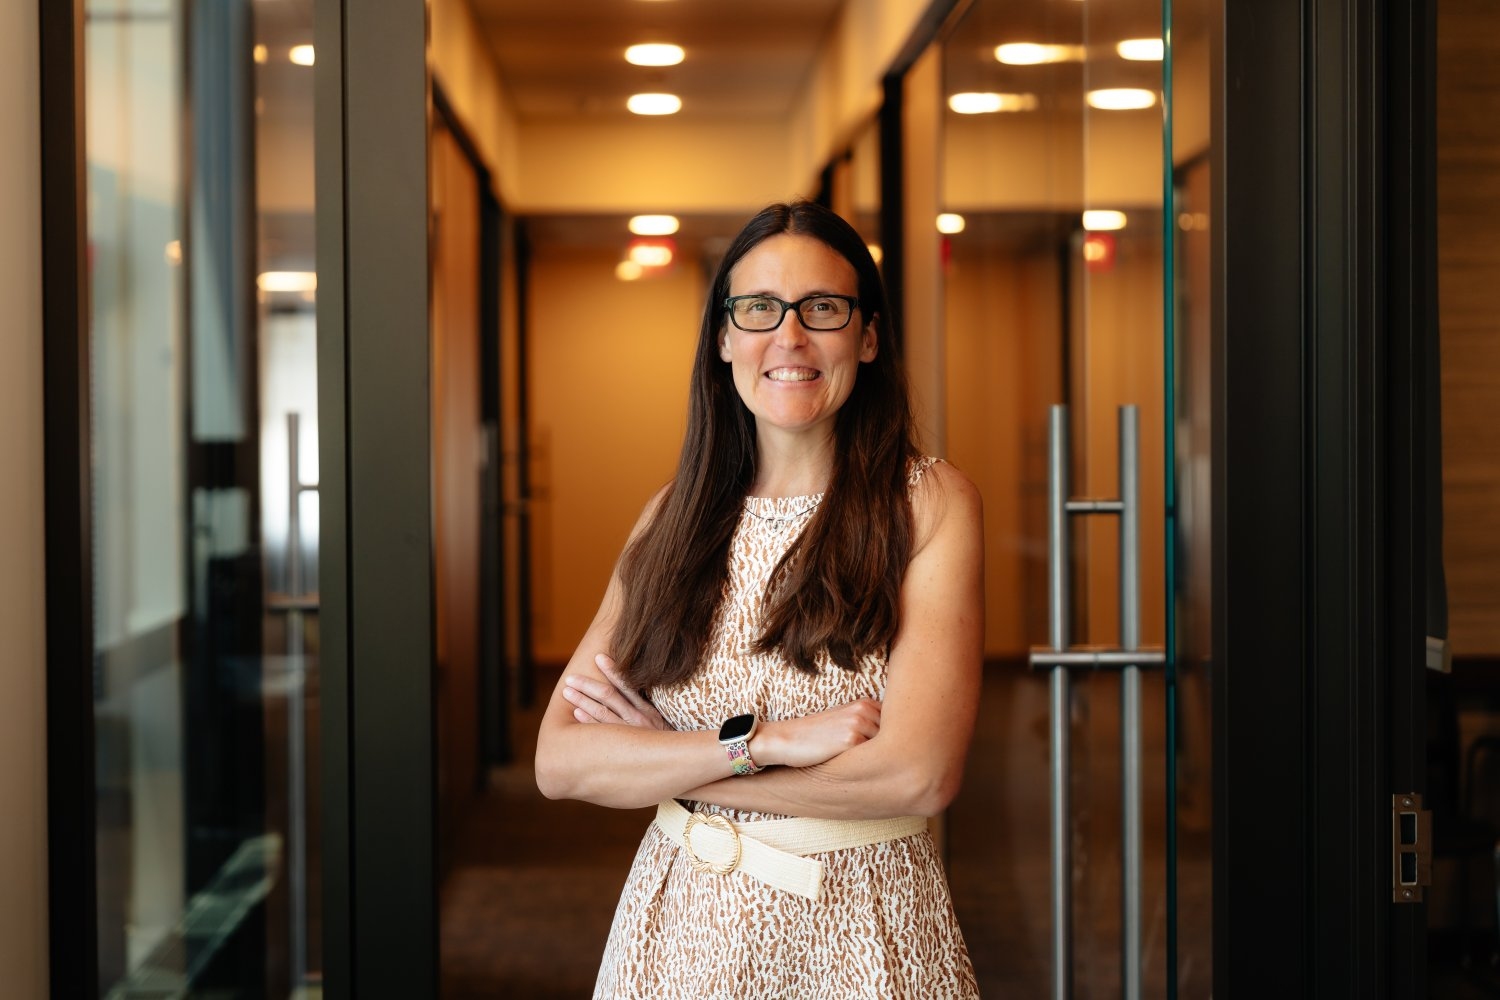
Керолайн Улер обговорює революцію даних у біології та потенціал машинного навчання для відкриття нового розуміння біологічних систем. Такі досягнення, як секвенування ДНК та моделі зору, формують нову еру в біології, надихаючи на інноваційні дослідження в галузі машинного навчання.

OpenAI стикається з ретельним розслідуванням у зв'язку з першим позовом про неправомірну смерть, тоді як гіганти галузі штучного інтелекту виступають проти регулювання. Засновник компанії Сем Альтман попереджає про ризики штучного інтелекту для світу та закликає до посилення регулювання.

Синтетичні дані імітують реальні дані для штучного інтелекту, захищаючи конфіденційність та прискорюючи розробку моделей. Генеративні моделі можуть створювати реалістичні синтетичні дані для різних модальностей, таких як мова, зображення, аудіо та табличні дані.
Режисер Алекс Прояс прогнозує, що штучний інтелект оптимізує кіноіндустрію, спростить і здешевить проекти, а також забезпечить художню свободу. Незважаючи на побоювання, Прояс вважає, що штучний інтелект принесе користь кінематографістам, спростивши виробничі процеси.
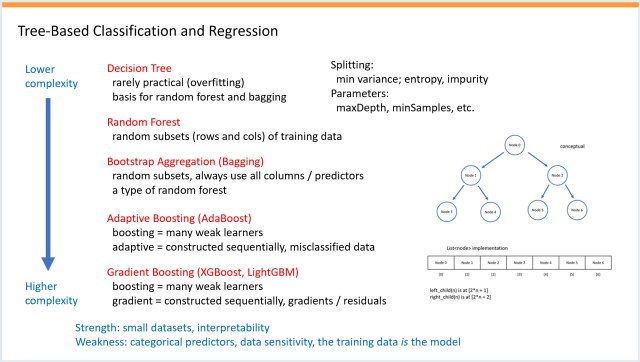
Комплексна презентація PowerPoint про нейронні мережі, розширена для включення деревних методів, під назвою «KitchenSink». Науково-фантастичні фільми на тему пам'яті творчо оцінені автором.

Мюррей Дейл та Ігнасіо Ландівар обговорюють вплив штучного інтелекту на творчість та прогнозування погоди. Вони ставлять під сумнів використання штучного інтелекту в особистій самореалізації та висловлюють занепокоєння щодо відсутності відповідальності за результати роботи штучного інтелекту.

Штучний інтелект, такий як ChatGPT, критикують за створення неточної інформації. Деякі пропонують відмовитися від терміна «slop» при описі їхньої роботи.
У статті розглядаються фактори, що впливають на вибір організаціями платформ штучного інтелекту, підкреслюється важливість бренду, партнерських відносин та ресурсів для розробників. Маккафрі попереджає, що найбільшим ризиком для OpenAI є потенційне погіршення якості ресурсів для розробників, що може призвести до швидкої зміни платформи.
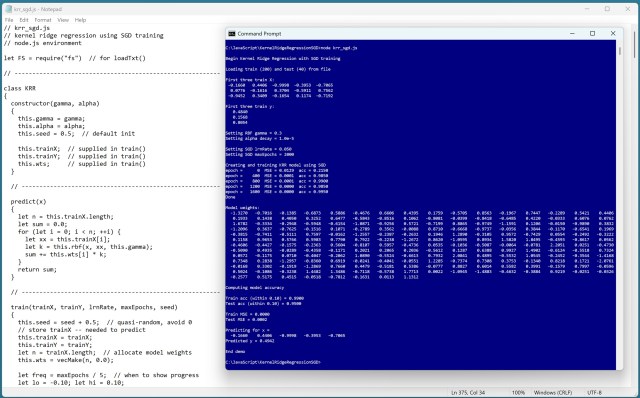
Регресія з використанням ядра (KRR) прогнозує значення за допомогою функції ядра, обробляючи складні дані. Досвід кодера з налаштування KRR в JavaScript демонструє потужність цієї техніки.