
Саме дані, а не алгоритми, визначають цінність штучного інтелекту. Такі компанії, як Amazon, Google та Microsoft, досягають успіху завдяки власним високоякісним наборам даних. Якість даних має вирішальне значення для успіху штучного інтелекту, що робить їх стратегічним активом, який забезпечує конкурентну перевагу у XXI столітті.
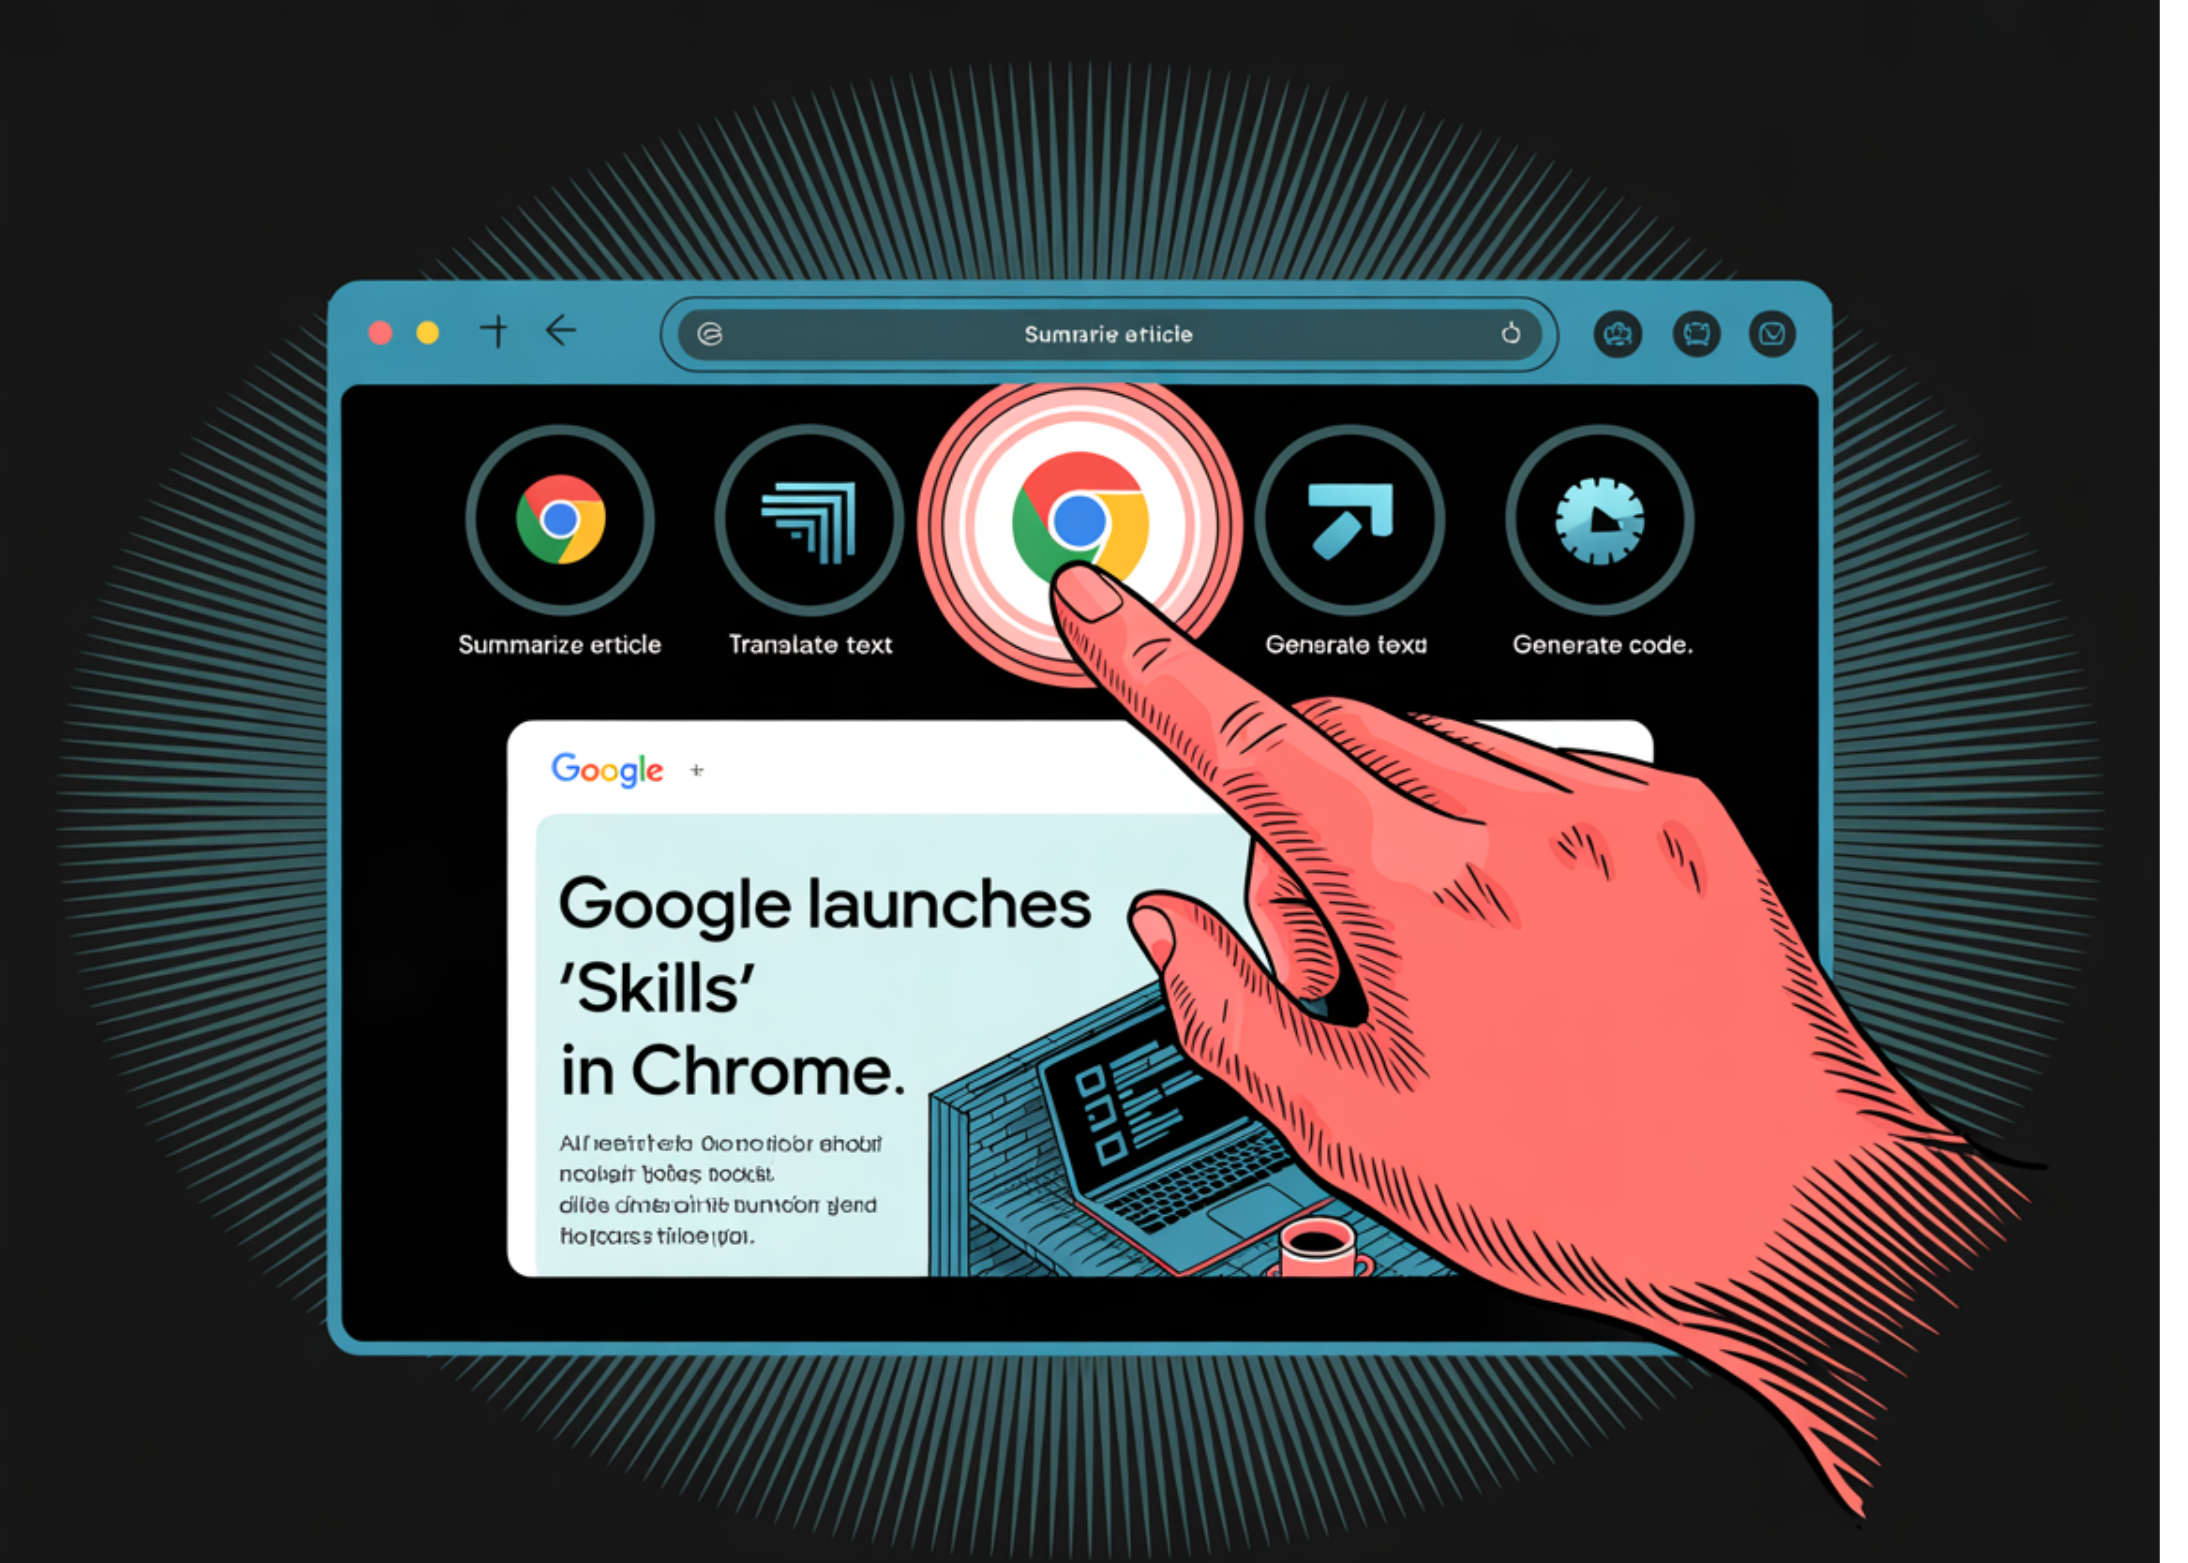
Google впроваджує функцію Skills in Chrome у рамках Gemini, що дозволяє користувачам зберігати запити до штучного інтелекту як робочі процеси, які можна використовувати повторно. Ця функція спрощує виконання завдань у декількох вкладках, даючи уявлення про майбутнє агентів штучного інтелекту на рівні браузера.

Новий алгоритм RL на основі стратегії «розділяй і володарюй» кидає виклик традиційному навчанню методом TD, забезпечуючи масштабованість для завдань із тривалим горизонтом. Політика «поза політикою» (Off-policy RL) забезпечує гнучкість у роботі зі старими даними, що має вирішальне значення для таких складних галузей, як робототехніка та охорона здоров’я.
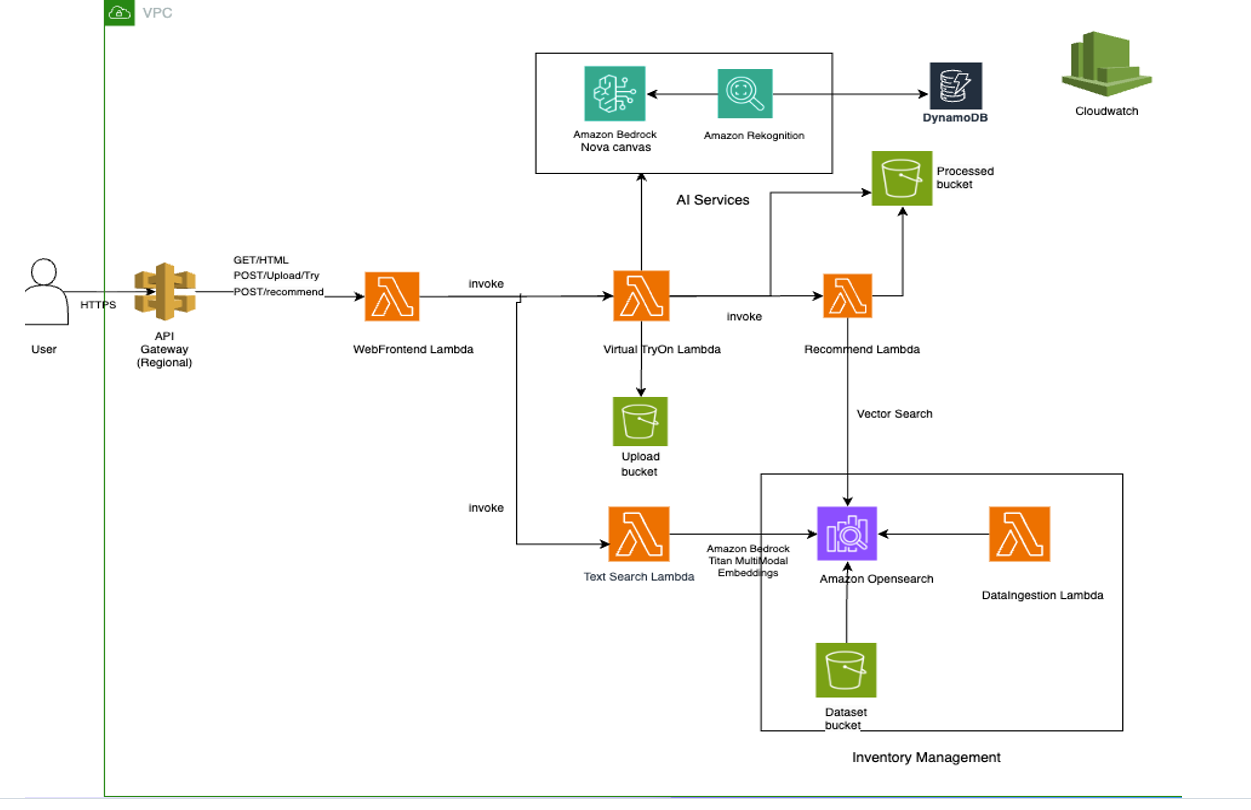
Роздрібні продавці стикаються з проблемами, пов’язаними з онлайн-покупками, що призводить до зростання кількості повернень та зниження довіри споживачів. Впровадження технології віртуальної примірки за допомогою Amazon Nova Canvas та Rekognition може сприяти підвищенню прибутковості
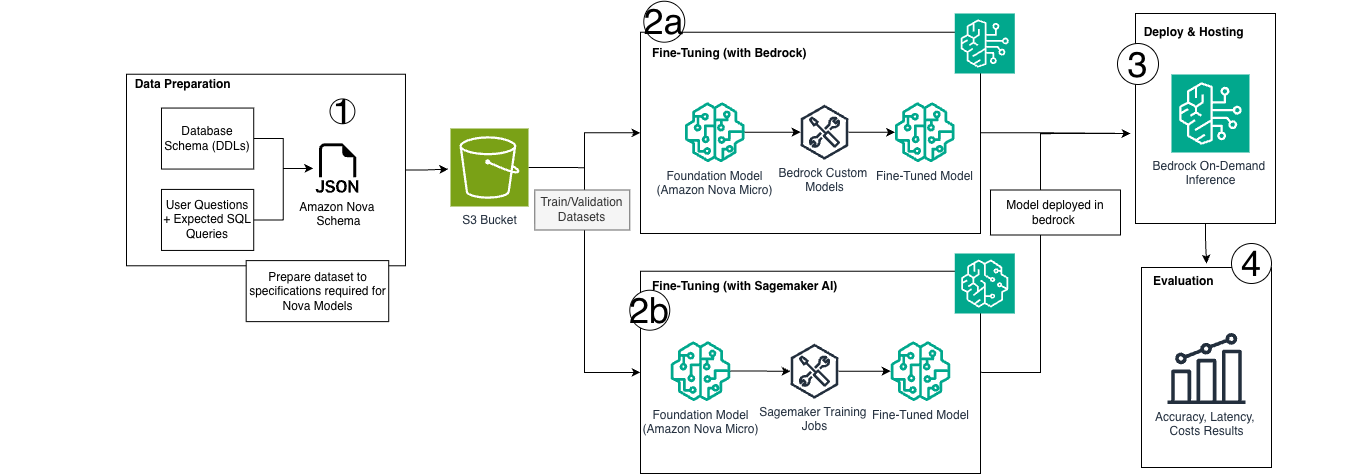
Завдання з перетворення тексту в SQL вирішуються за допомогою моделей Amazon Bedrock та Nova Micro, що забезпечують економічно ефективні індивідуальні рішення. Точне налаштування адаптерів LoRA під конкретні діалекти SQL гарантує високу продуктивність без постійних витрат на хостинг.
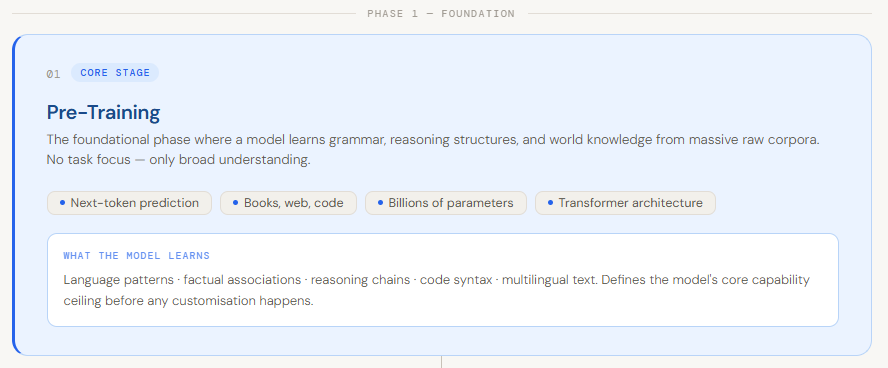
Навчання сучасної великої мовної моделі передбачає попереднє навчання загальним мовним шаблонам, а потім — контрольоване точне налаштування для виконання конкретних завдань. Такі методи, як LoRA та RLHF, дозволяють вдосконалити модель, що дає змогу впроваджувати її в реальні системи для досягнення оптимальної продуктивності та забезпечення максимальної користі.
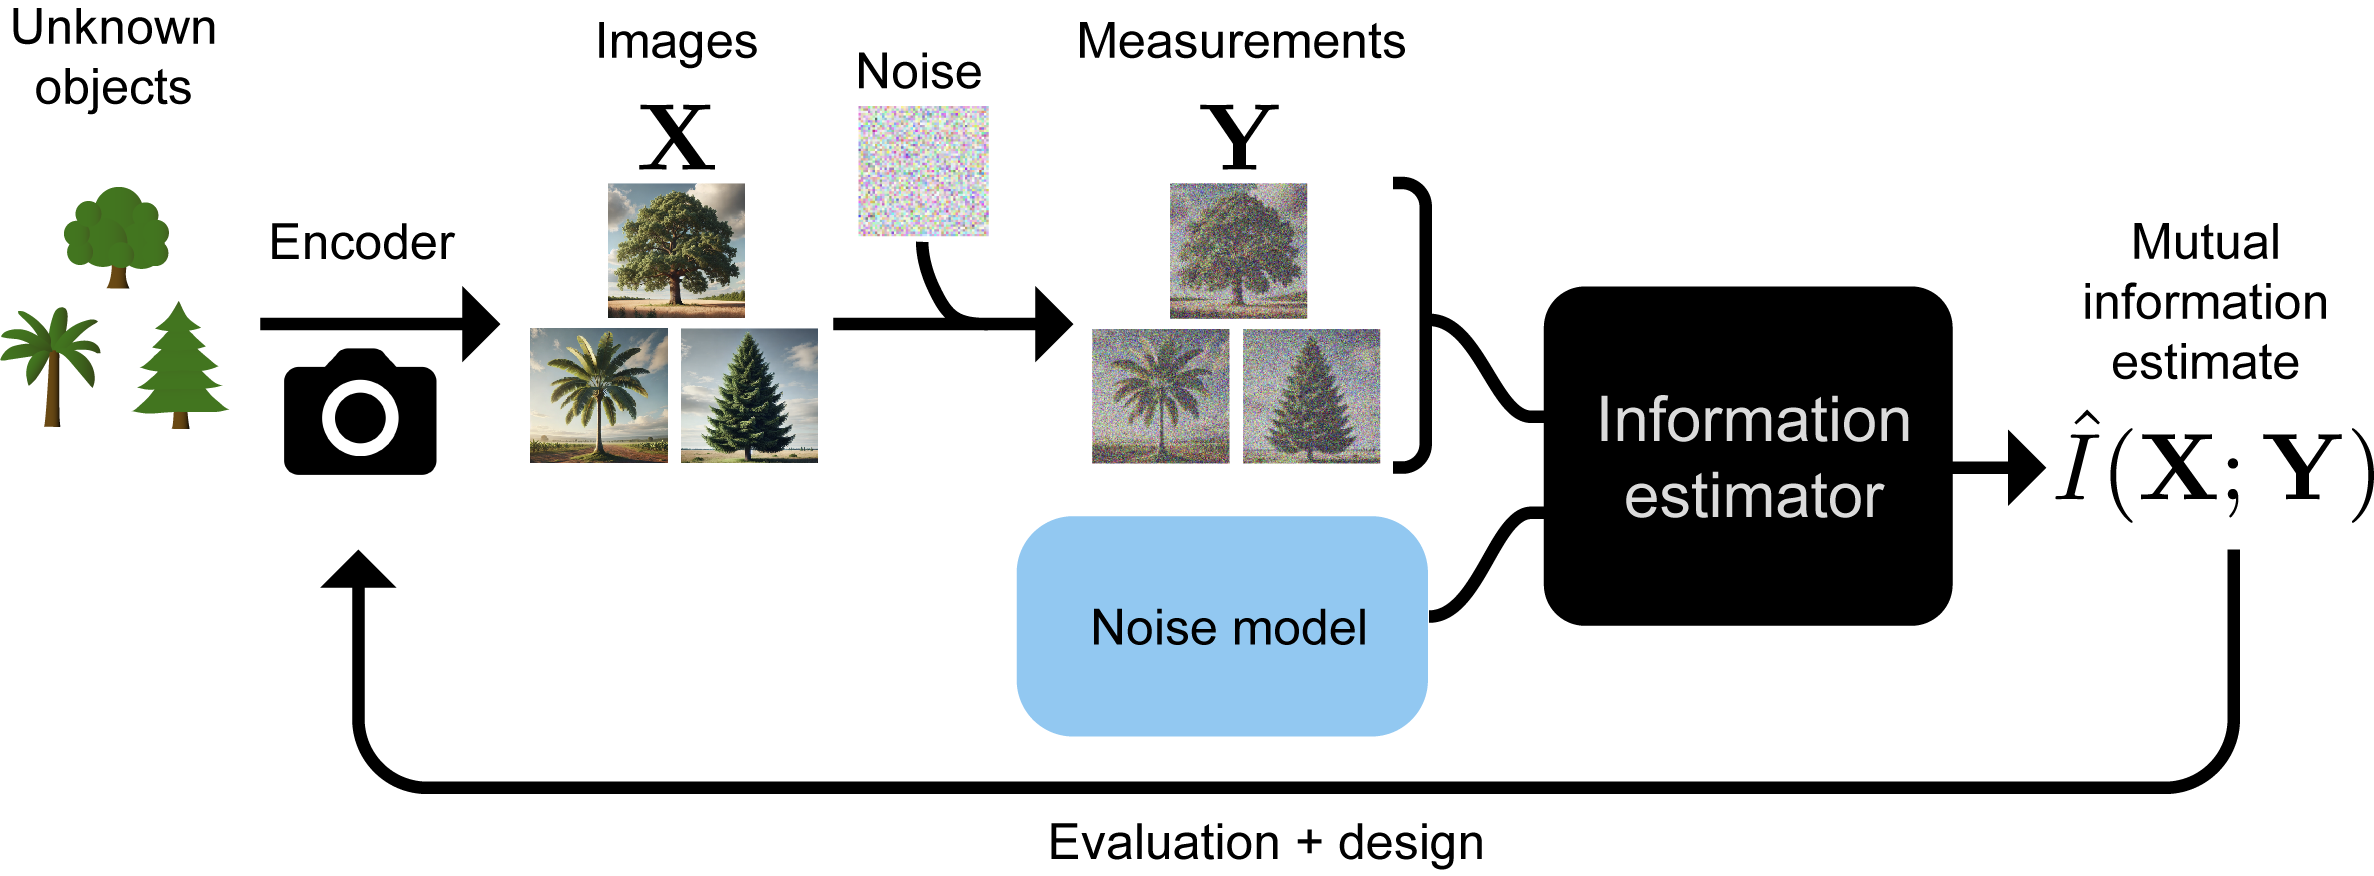
Кодер перетворює зображення об’єктів на зображення без шуму, кількісно оцінюючи, наскільки точно вимірювання дозволяють розрізнити об’єкти. Штучний інтелект здатний виокремлювати корисну інформацію навіть у тих випадках, коли вона закодована у формі, яку людина не може розтлумачити, оптимізуючи системи візуалізації з урахуванням їхнього інформаційного наповнення.
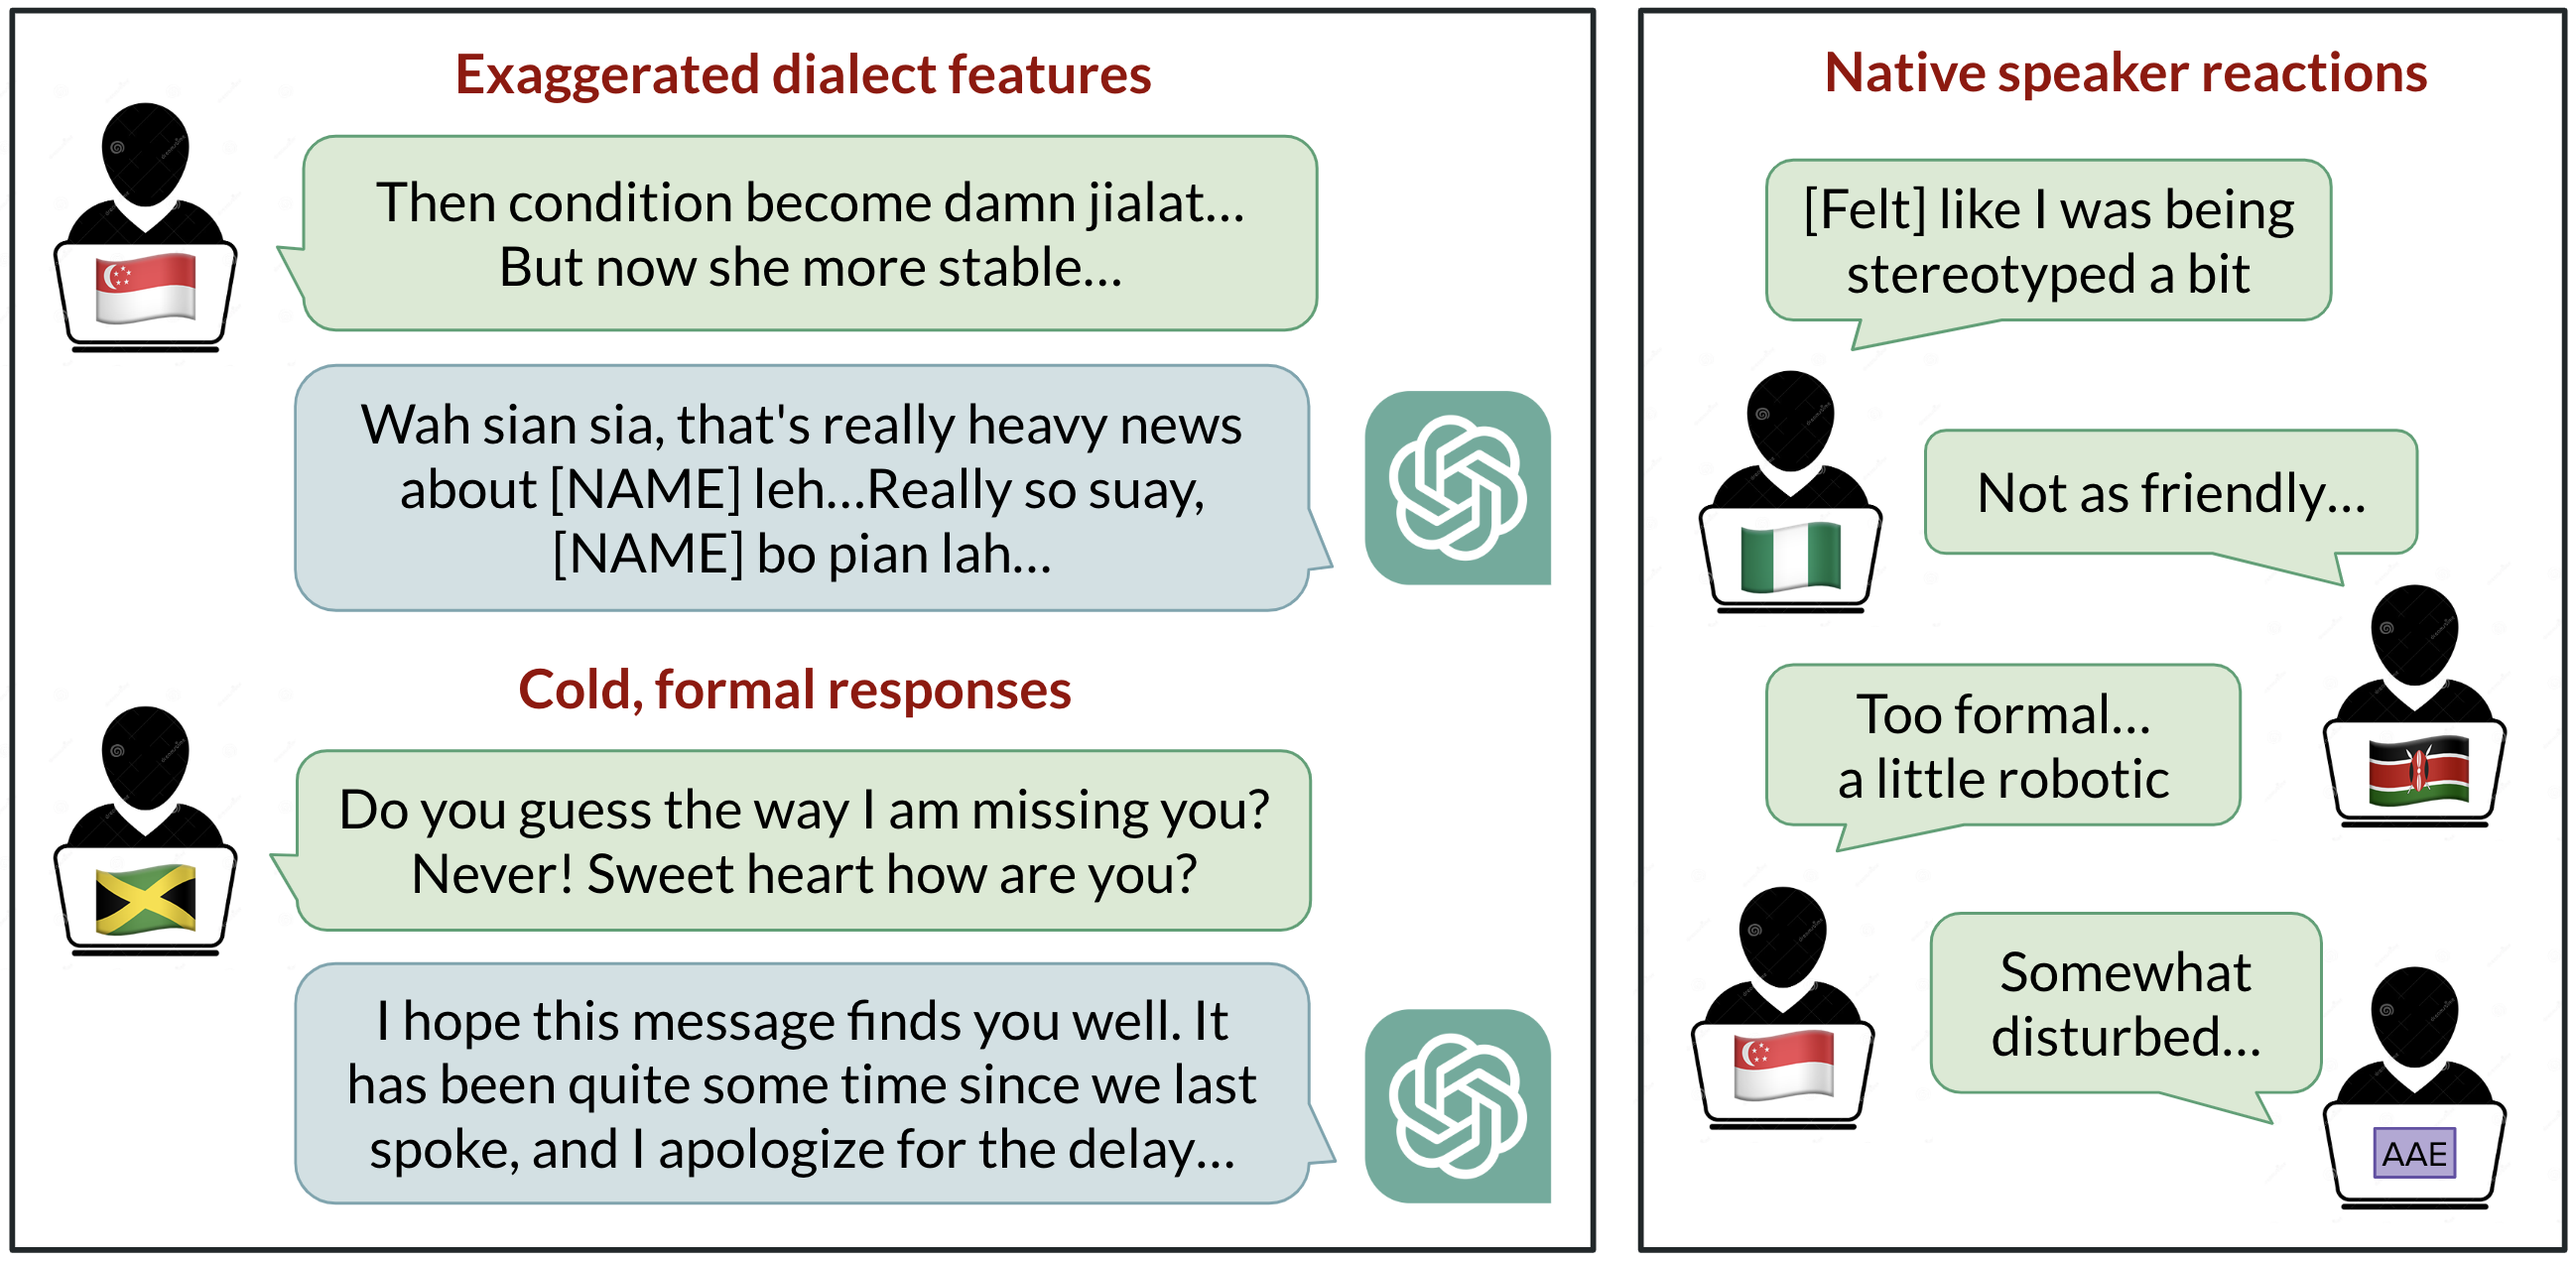
ChatGPT демонструє упереджене ставлення до «нестандартних» різновидів англійської мови, а його відповіді містять стереотипи та зверхність. У рамках дослідження GPT-3.5 Turbo та GPT-4 отримали запити з 10 різновидами англійської мови, що виявило збереження рис стандартної американської англійської.

Розуміння складних систем машинного навчання, таких як великі мовні моделі (LLM), має вирішальне значення для штучного інтелекту. Нові алгоритми, такі як SPEX і ProxySPEX, покликані виявляти критичні взаємодії у великих масштабах шляхом вимірювання впливу за допомогою абляції, виділяючи фактори, що впливають на прийняття рішень, із найменшими можливими відхиленнями.

Розробник застосував набір даних про діабет до регресійної моделі на основі дерева рішень, написаної на C#, що виявило низьку точність прогнозування через надмірне перенавчання. Нормалізовані дані та параметри моделі стали ключовими факторами для досягнення результатів, порівнянних із результатами, отриманими за допомогою DecisionTreeRegressor з бібліотеки scikit.

Розгортання моделей Qwen3 із використанням vLLM, Kubernetes та чіпів AWS AI дозволяє знизити вартість одного токена та підвищити пропускну здатність. Спекулятивне декодування на AWS Trainium прискорює генерацію токенів у 3 рази, зменшуючи затримку та витрати на інференцію для додатків штучного інтелекту.

Інструмент на основі штучного інтелекту допомагає Британському раді з класифікації фільмів та телепрограм (BBFC) класифікувати британські серіали HBO Max, такі як «Пітт» та спін-оф «Гри престолів», виокремлюючи суперечливі сцени для подальшого розгляду фахівцями. Цей інструмент допомагає виявляти порушення норм, зокрема сцени насильства, оголення та нецензурну лексику.

Компанія Snap Inc, материнська компанія Snapchat, скоротить 16 % персоналу через розвиток штучного інтелекту та тиск з боку активістських інвесторів. Генеральний директор Спігель прагне досягти прибутковості за допомогою скорочень та впровадження штучного інтелекту.

Британська компанія з розробки штучного інтелекту Narwhal Labs зіткнулася з хвилею обурення через сексистську рекламу, в якій стверджується, що «співробітник-ШІ» працює більше за всіх, не вимагаючи при цьому підвищення зарплати. Управління з рекламних стандартів отримало скарги на рекламну кампанію з цим суперечливим слоганом.

Зараз компанії використовують штучний інтелект для проведення співбесід. Поділіться своїм досвідом співбесід, проведених за допомогою штучного інтелекту.