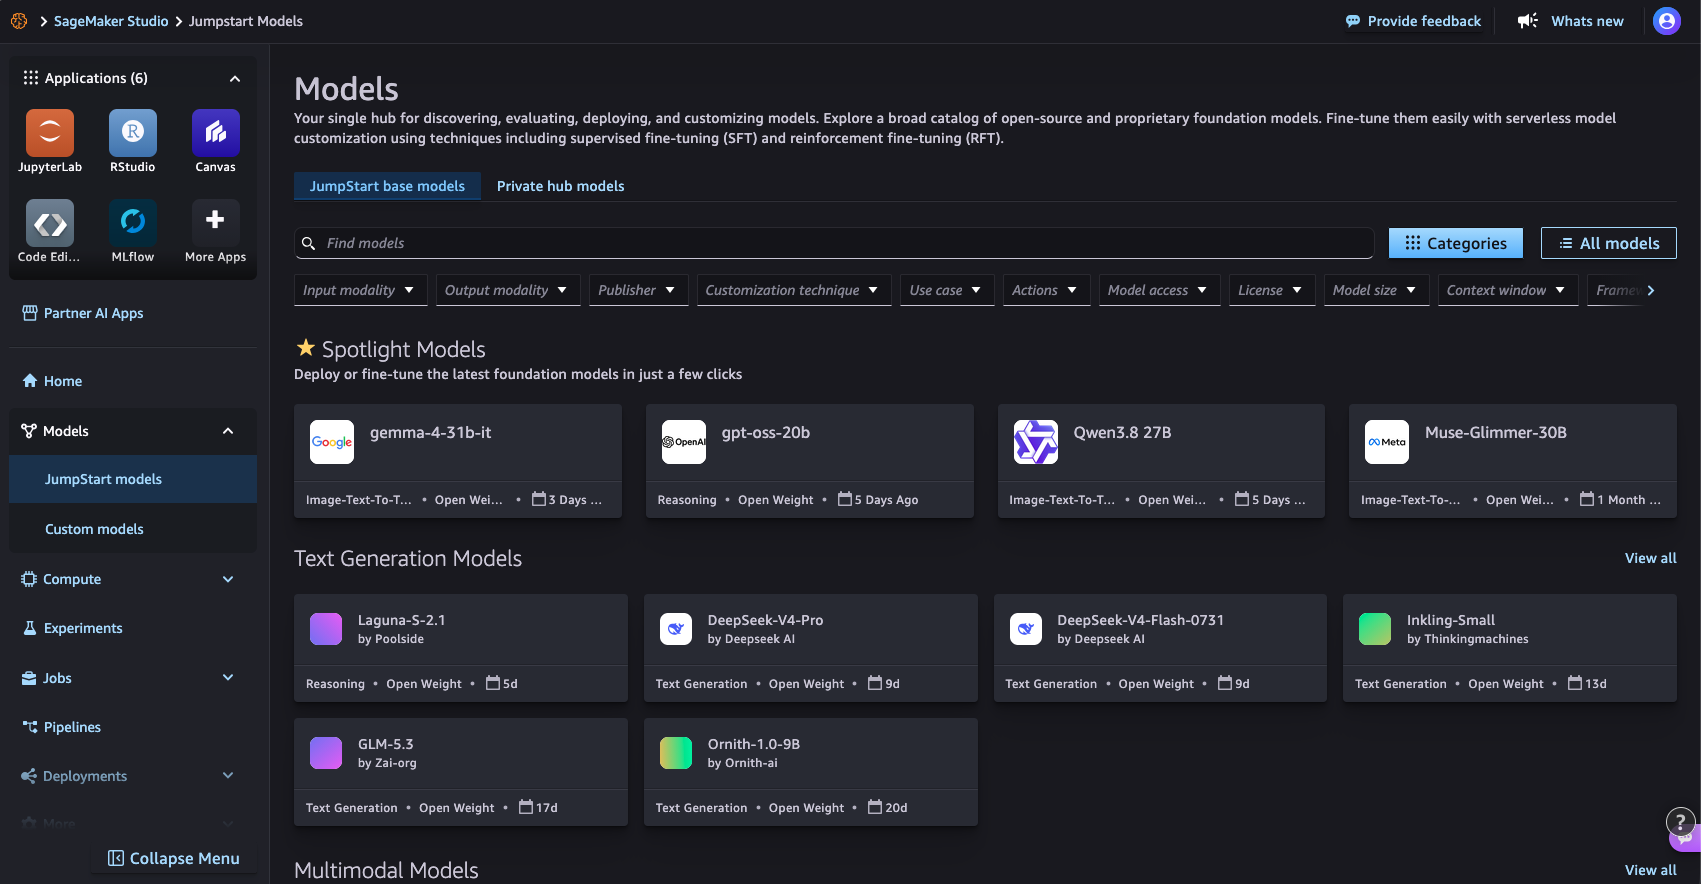
Amazon SageMaker JumpStart спрощує розгортання та тестування моделей, пропонуючи попередньо навчені моделі та оптимізовані конфігурації. Нові покращення, заплановані на 2026 рік, спростять пошук і розгортання моделей, включаючи інтеграцію з глибокими посиланнями для моделей Hugging Face.
Компанія Meta випустила Muse Wonder та Muse Wonder Full, призначені для виконання тривалих завдань, таких як програмування та фінансові операції. Muse Wonder Full показує найкращі результати в таблиці бенчмарків компанії Meta, демонструючи вражаючі показники на MemoryBench.
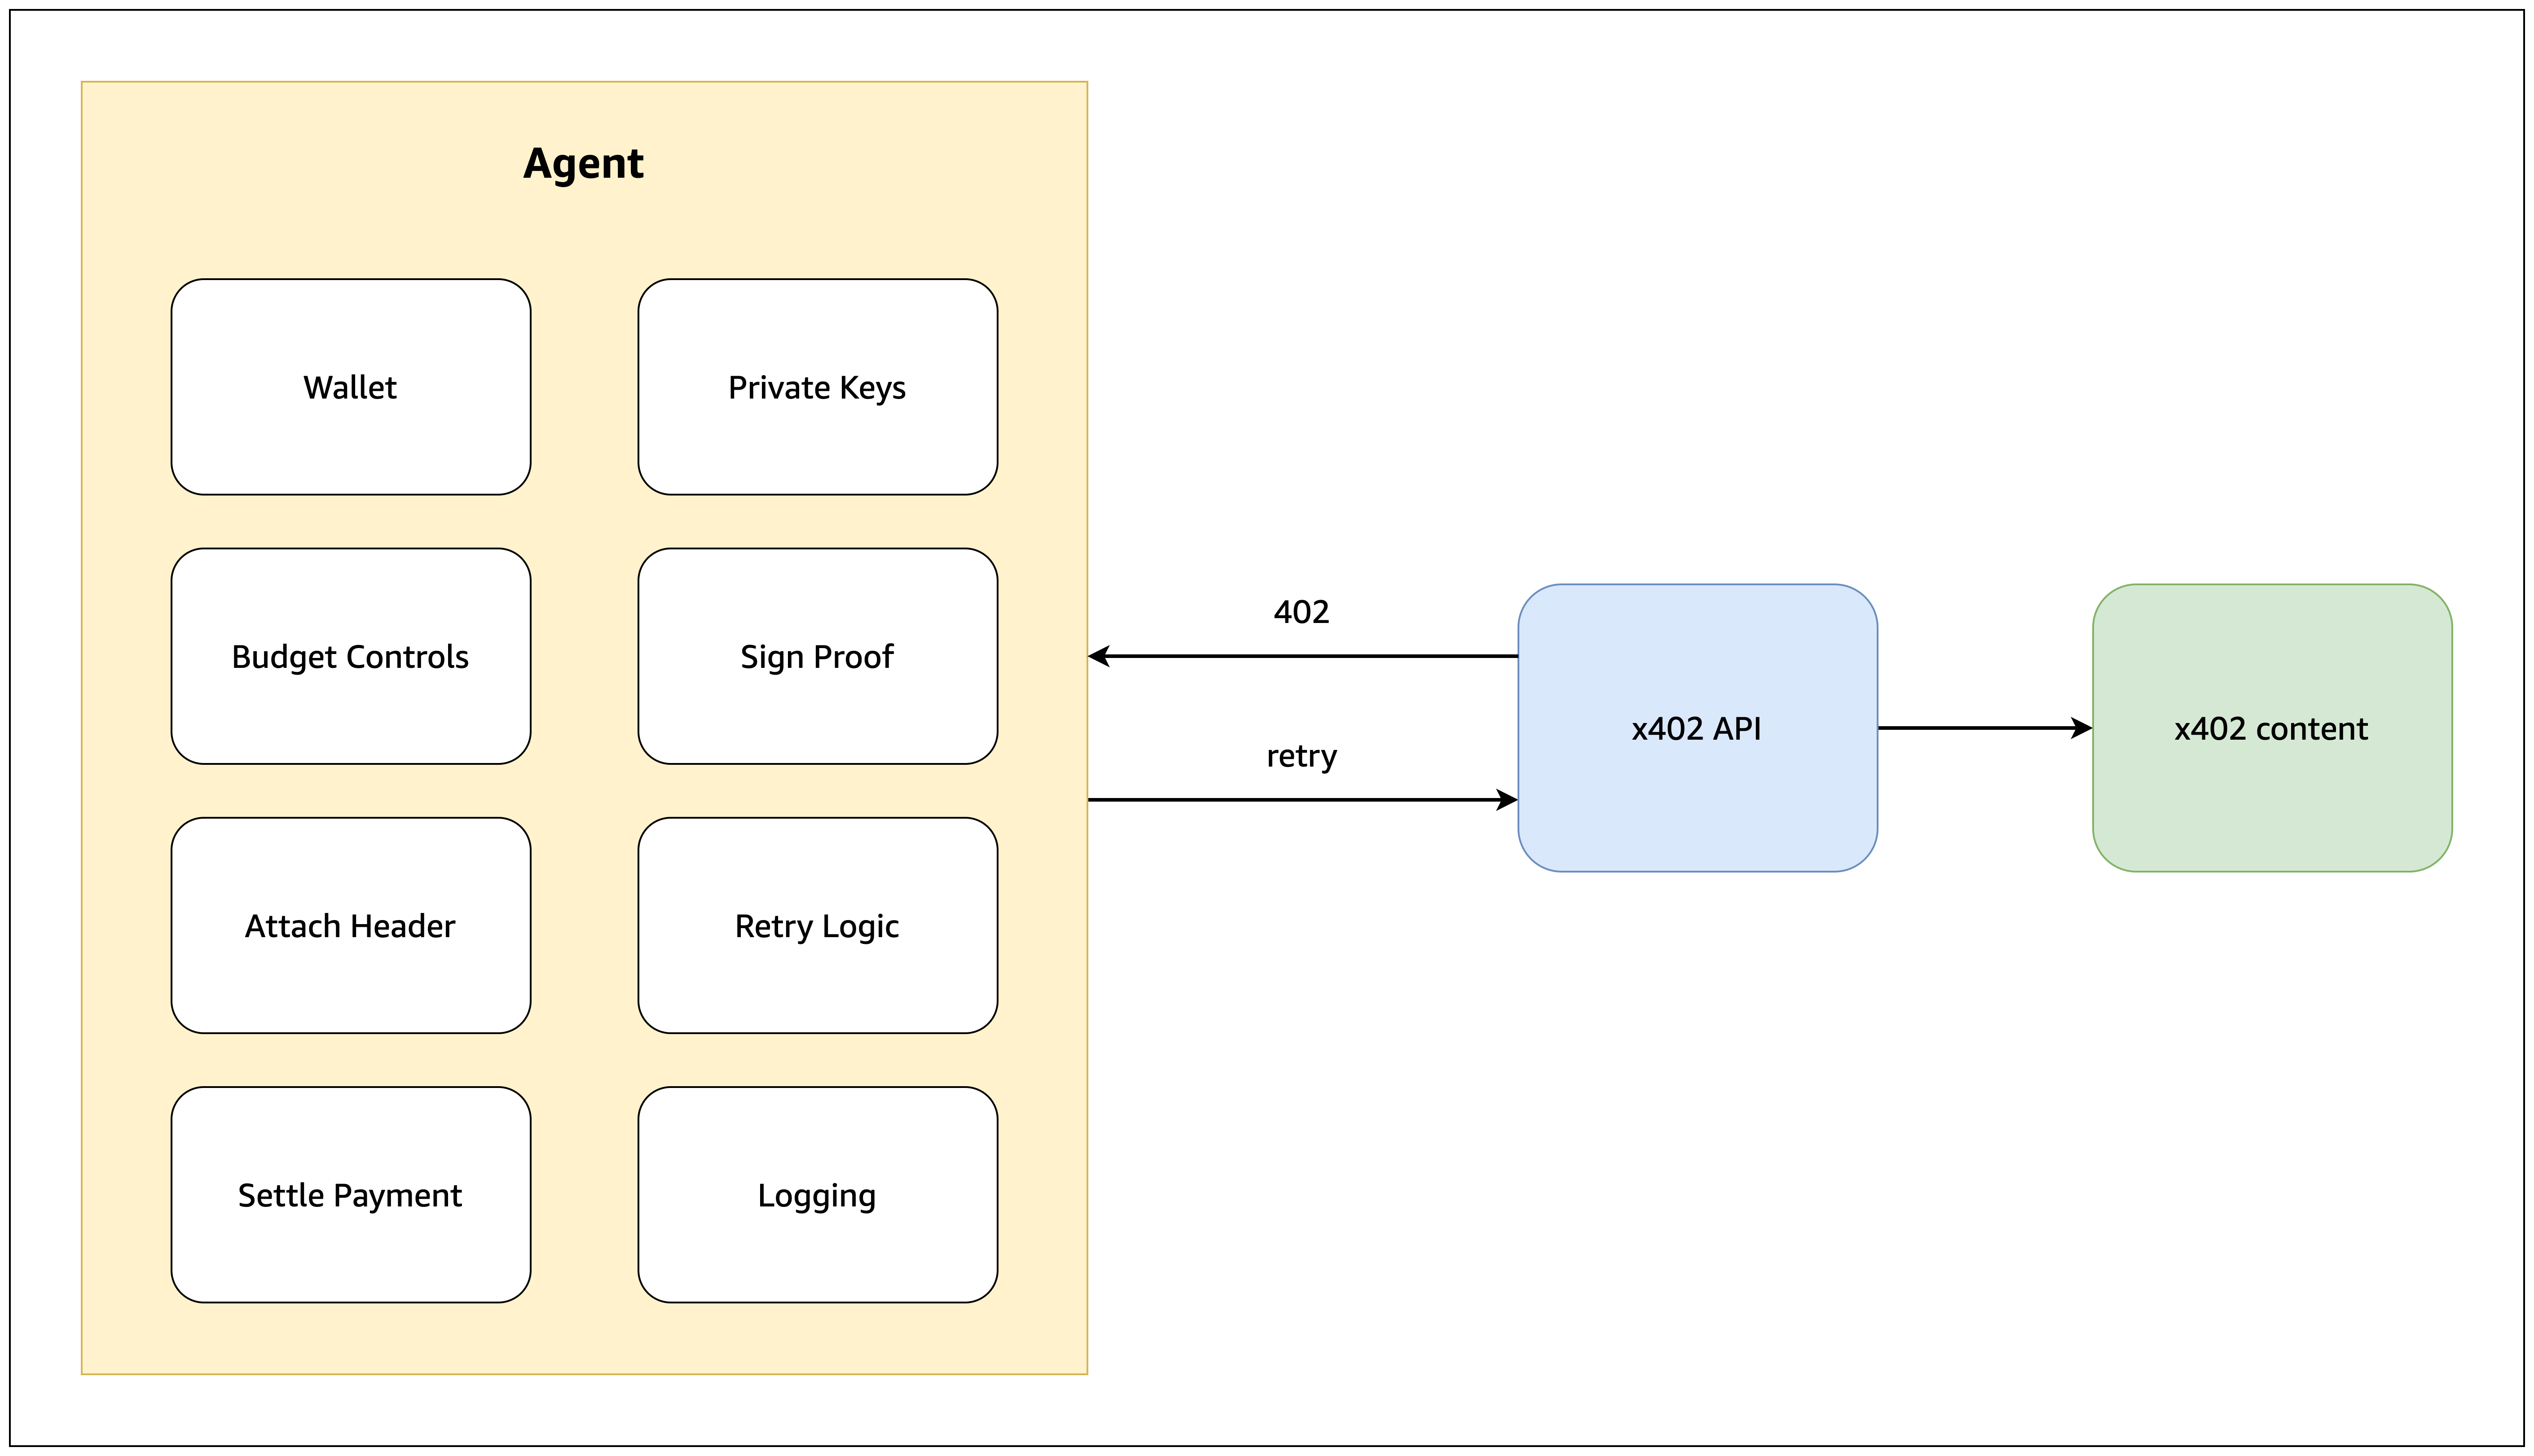
Штучні інтелекти часто мають проблеми з доступом до веб-ресурсів, що вимагають оплати, і стикаються з помилкою HTTP 402 "Payment Required". Браузер Anchor з функцією автоматичних платежів забезпечує автоматизовані платежі між машинами, і тепер він доступний на AWS Marketplace, що дозволяє штучним інтелектам здійснювати транзакції без проблем.
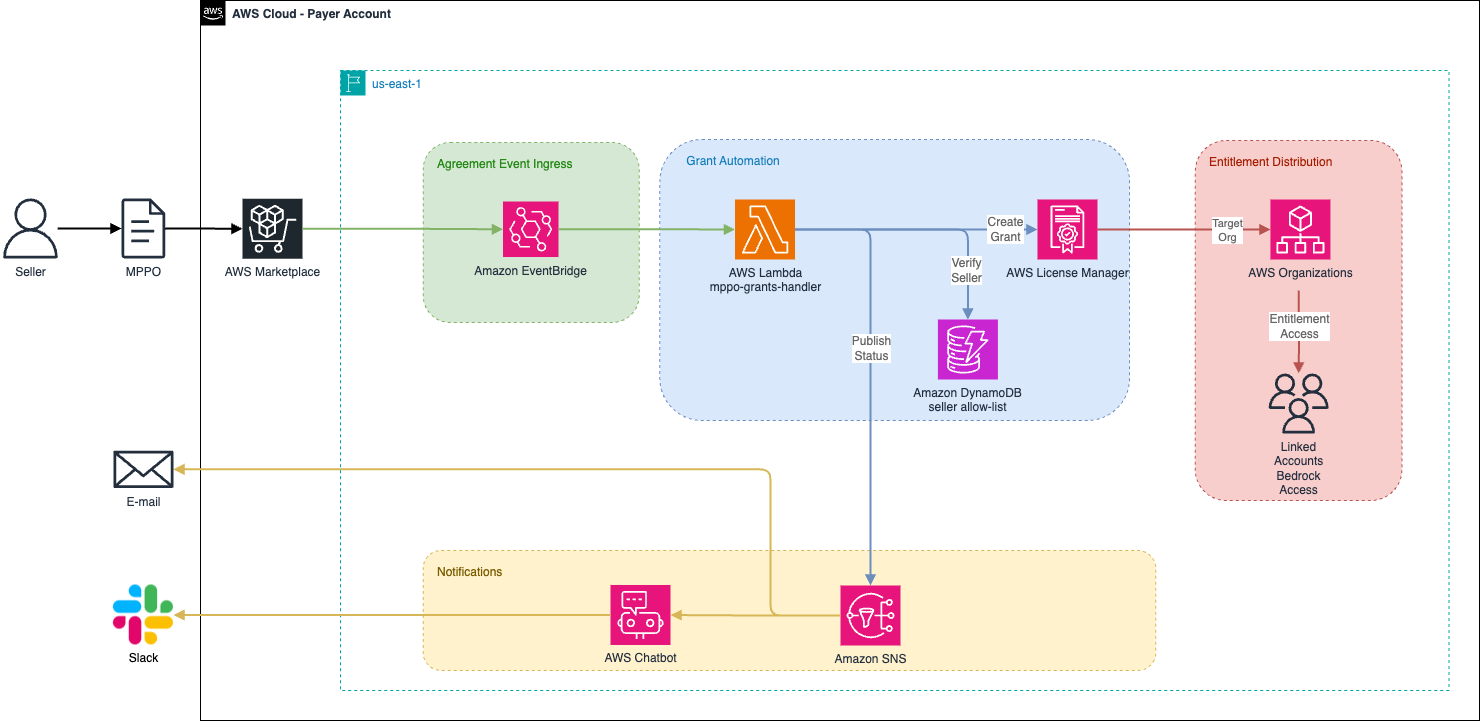
Amazon Bedrock спрощує доступ до моделей штучного інтелекту сторонніх розробників у кількох облікових записах за допомогою централізованого управління правами. Описано два способи активації: простий скрипт для одноразових виправлень та автоматизація за допомогою CDK для постійної обробки.
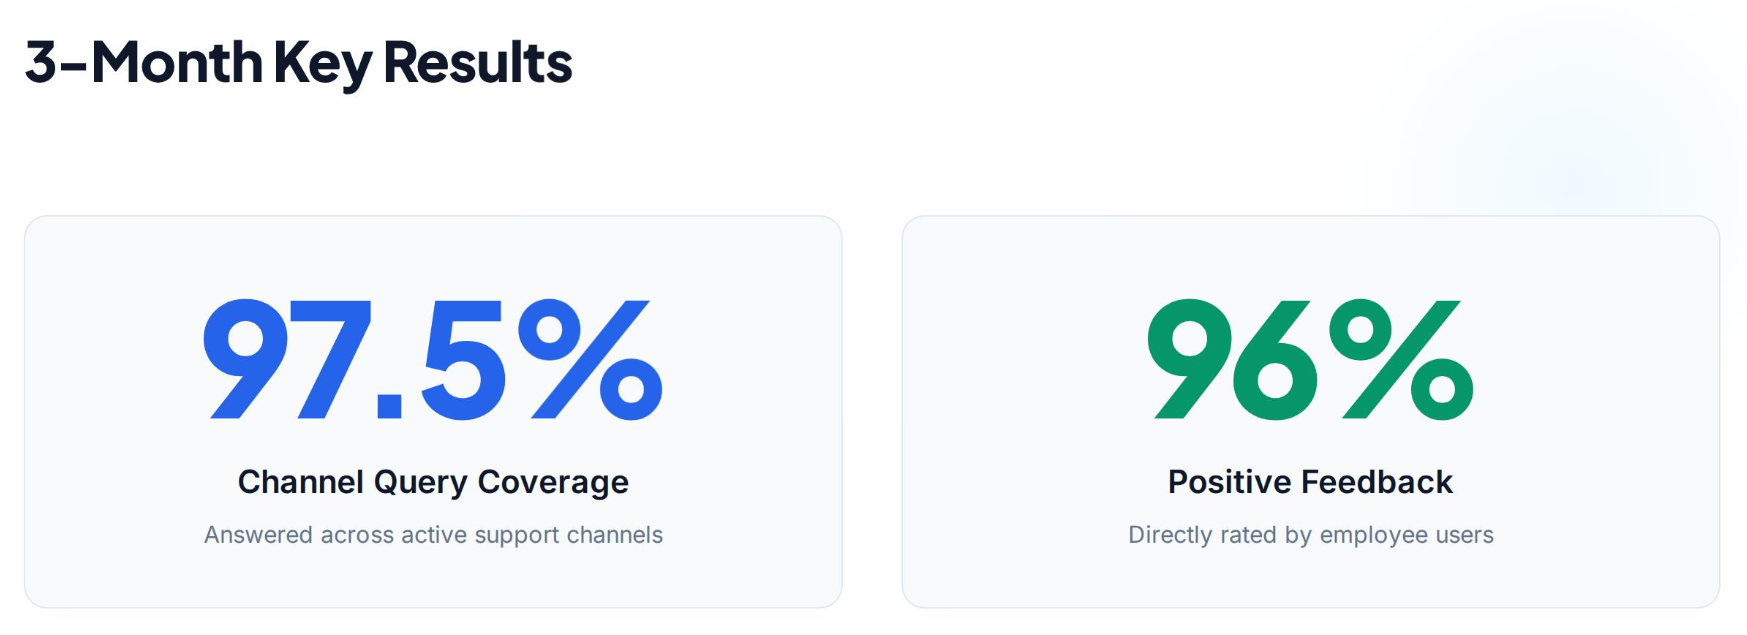
Команда глобальної інженерії ShipStation створила Deckhand – агента служби підтримки IT на основі штучного інтелекту для Slack, який дозволяє ефективно вирішувати типові запити користувачів. Deckhand досяг показника вирішення проблем у 97,5% випадків і отримав 96% позитивних відгуків, що значно спростило підтримку IT для глобальних команд.
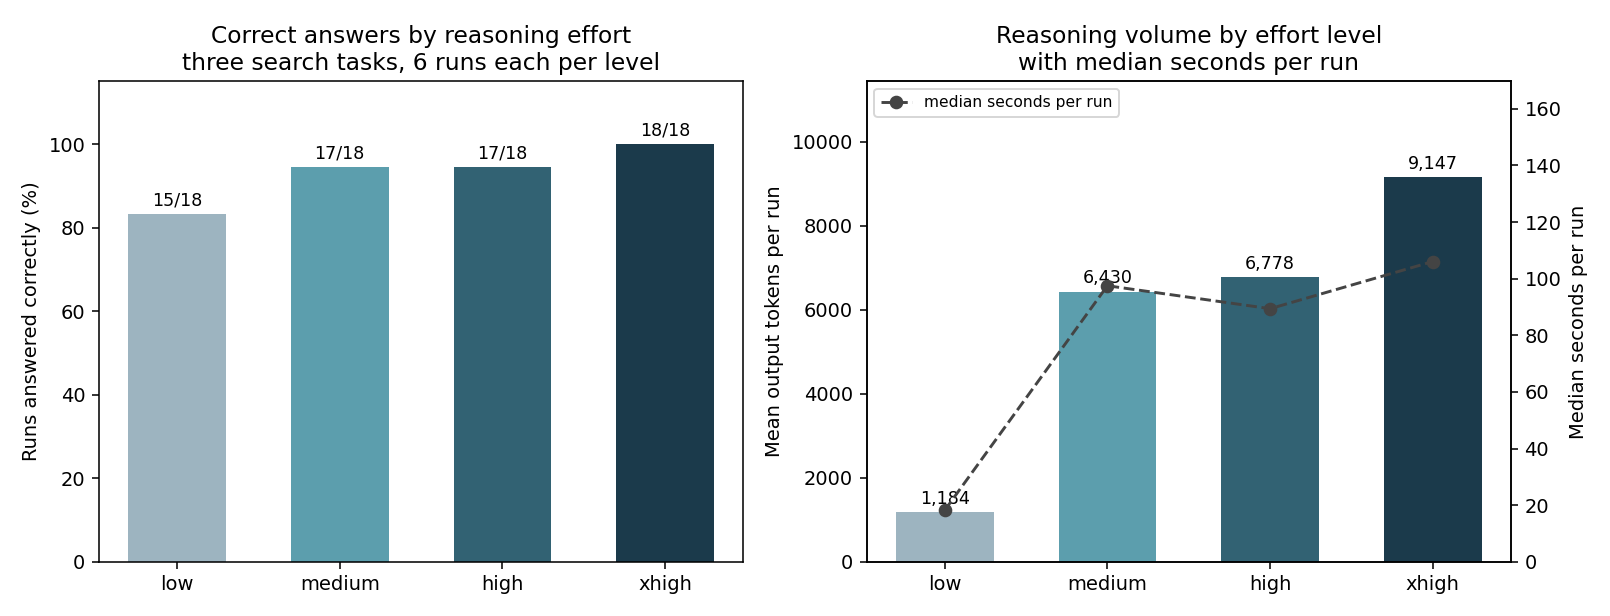
Модель Grok 4.7 від SpaceXAI забезпечує покращену продуктивність при виконанні тривалих завдань, перевершуючи Grok 4.6 за результатами різних тестів. Модель навчена самостійно перевіряти свою роботу та обробляти більший контекст, що забезпечує чіткий баланс між різними рівнями обчислювальних зусиль.
Штучний інтелект ставить під сумнів питання відповідальності у сфері публічних відгуків, за словами професора MIT Деба Роя. Центр конструктивного спілкування при MIT наголошує на важливості довіри в громадянських дискусіях з використанням штучного інтелекту.
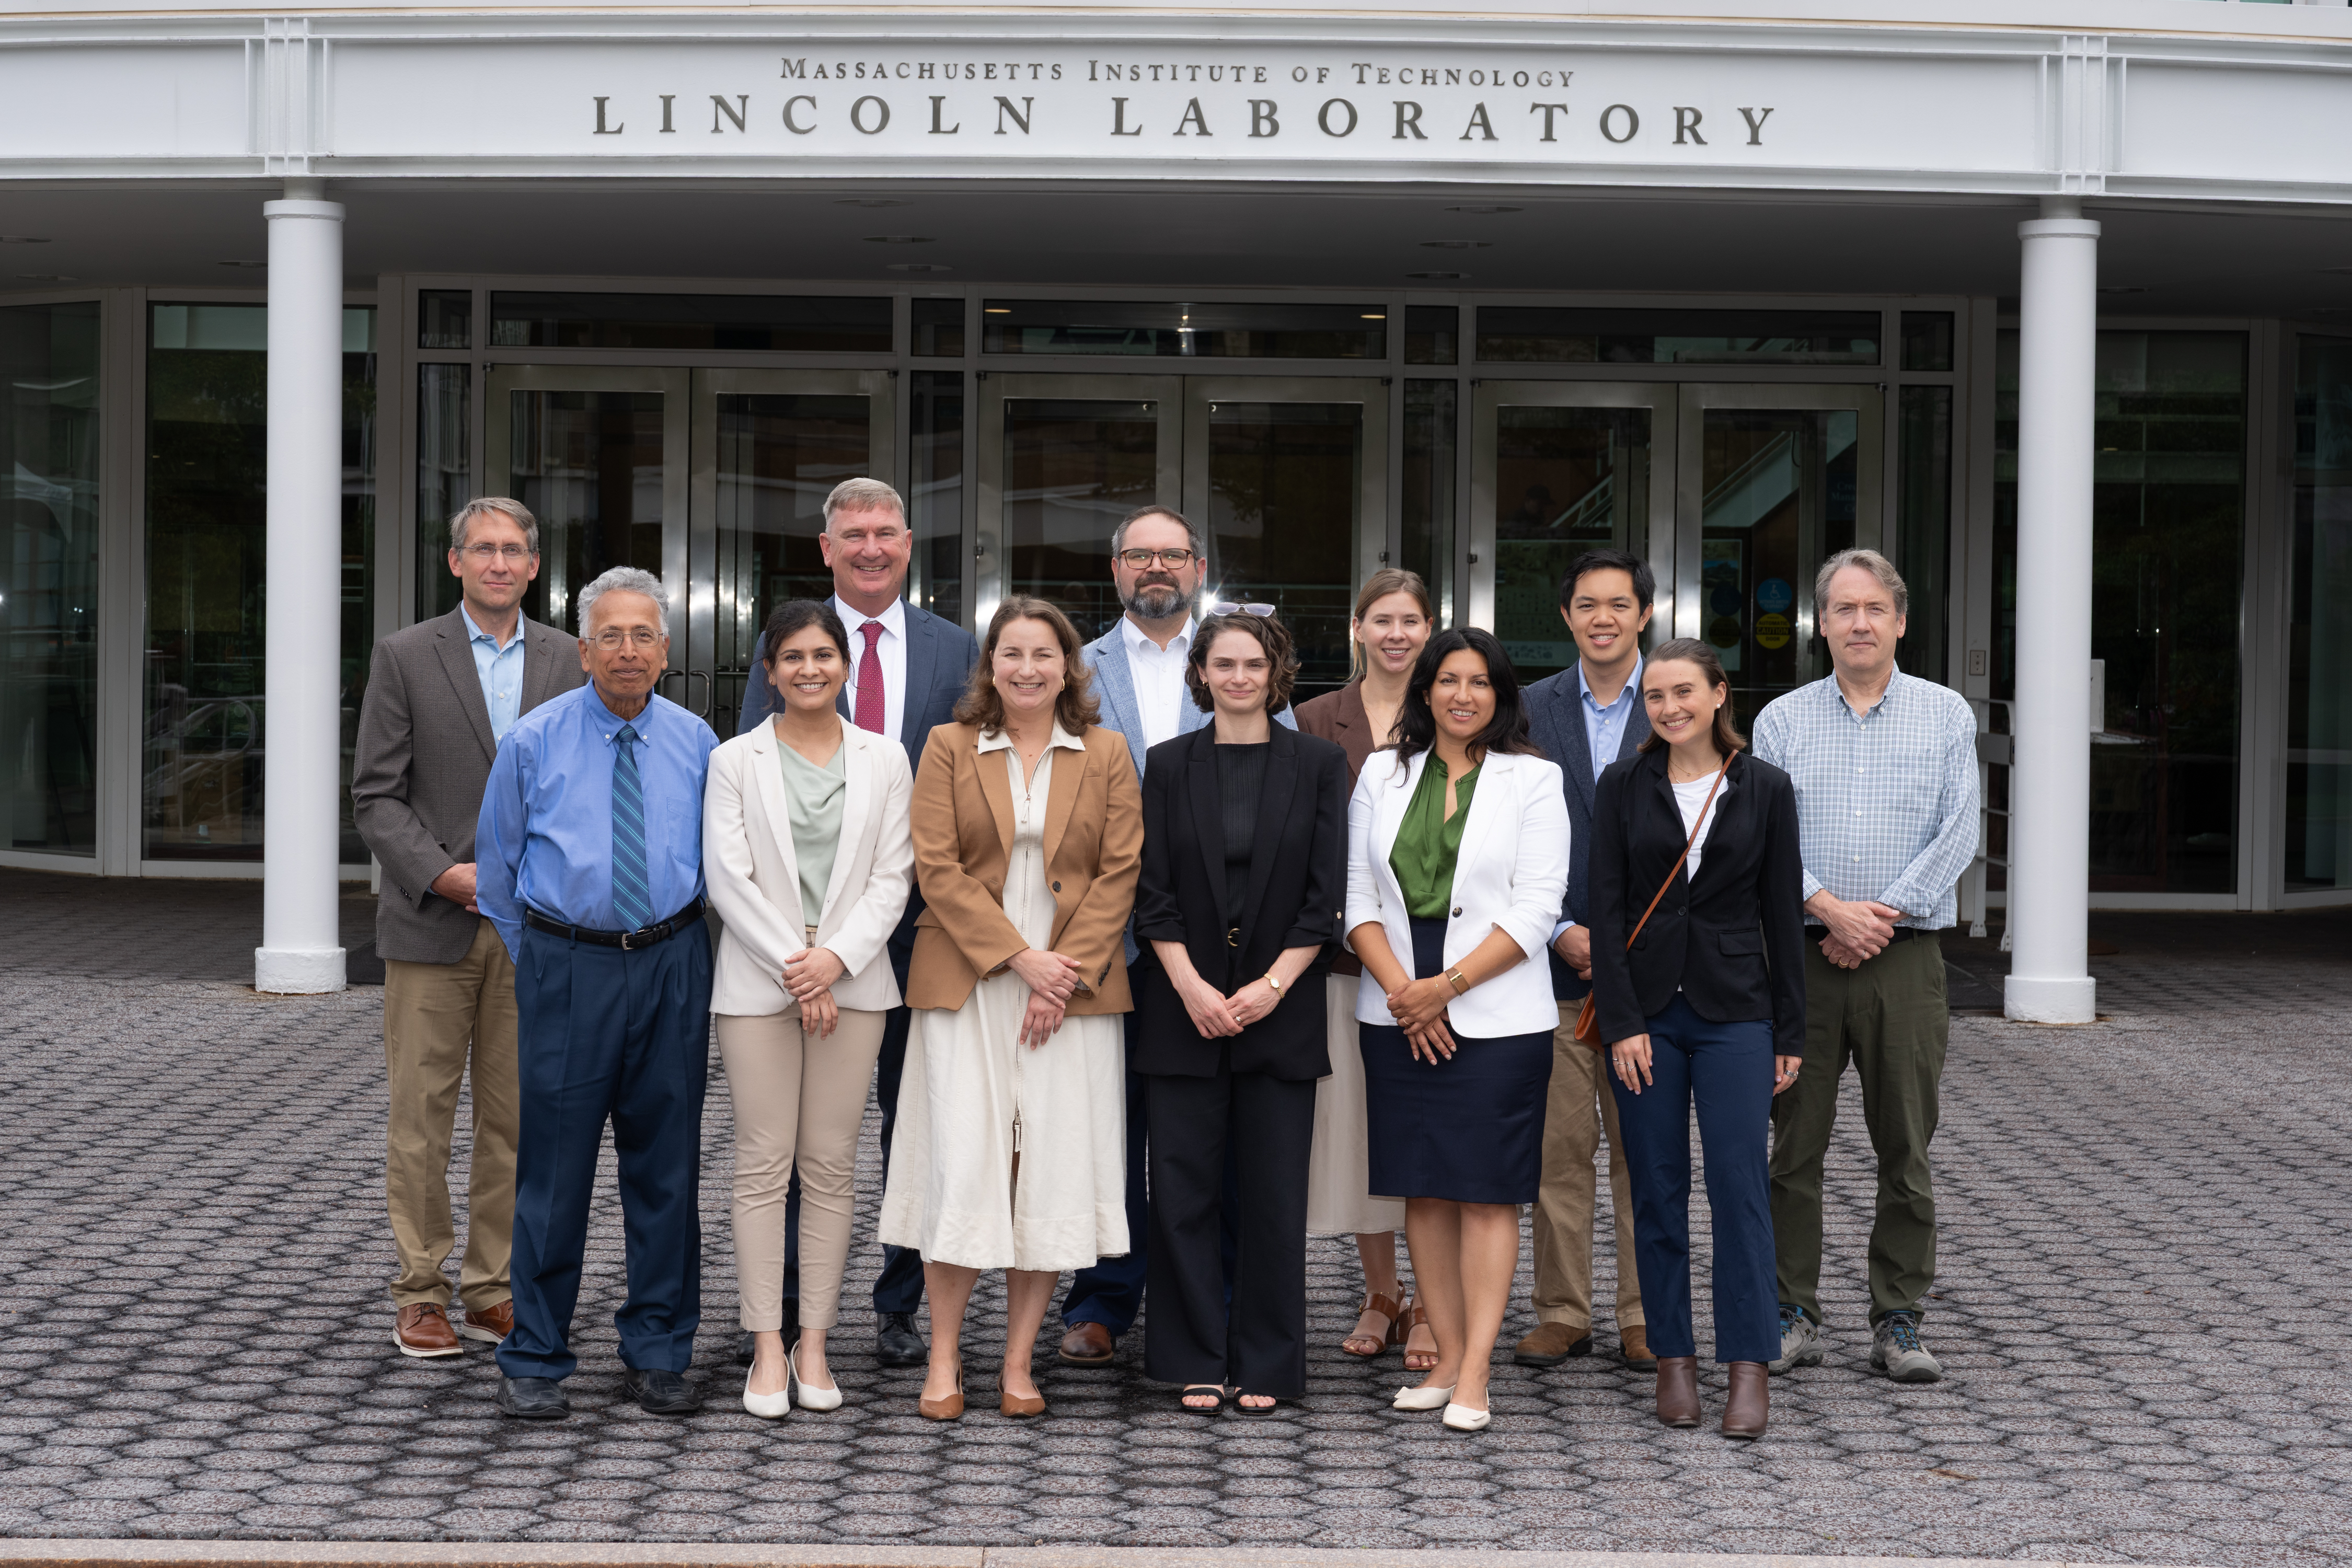
Лабораторія MIT Lincoln Laboratory провела зустріч з організацією NSCEB для обговорення можливостей зміцнення національної біологічної безпеки. Звіт NSCEB передбачає федеральні інвестиції в розмірі 15 мільярдів доларів США для підтримки лідерства Сполучених Штатів у галузі біотехнологій.
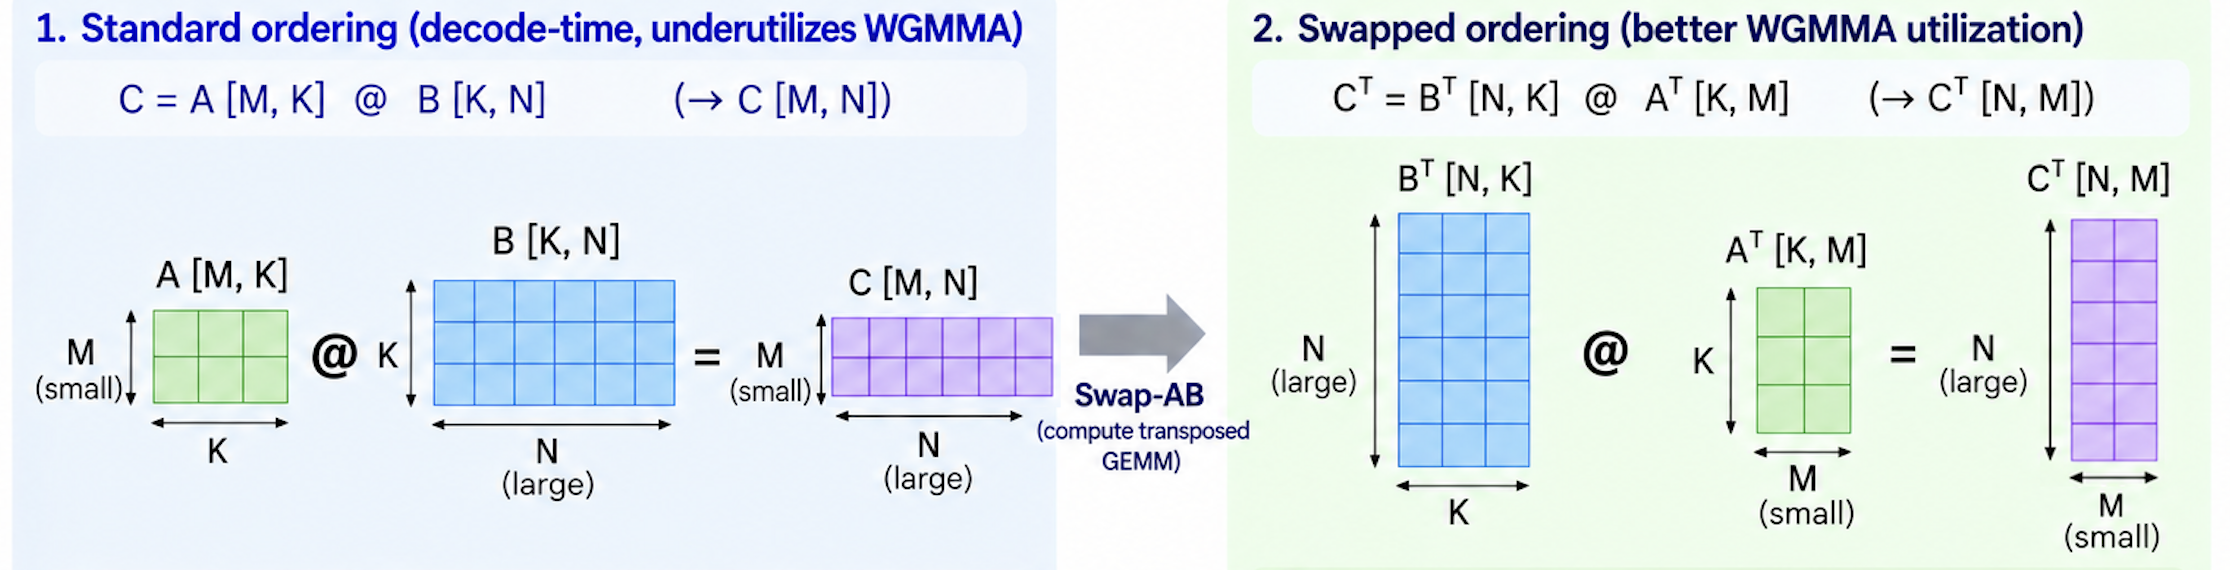
Технологія Fused MoE оптимізує роботу великих мовних моделей, зменшуючи затримки та витрати. Архітектура NVIDIA Hopper використовує технологію WGMMA для ефективної обробки тензорів, що максимізує використання графічних процесорів.
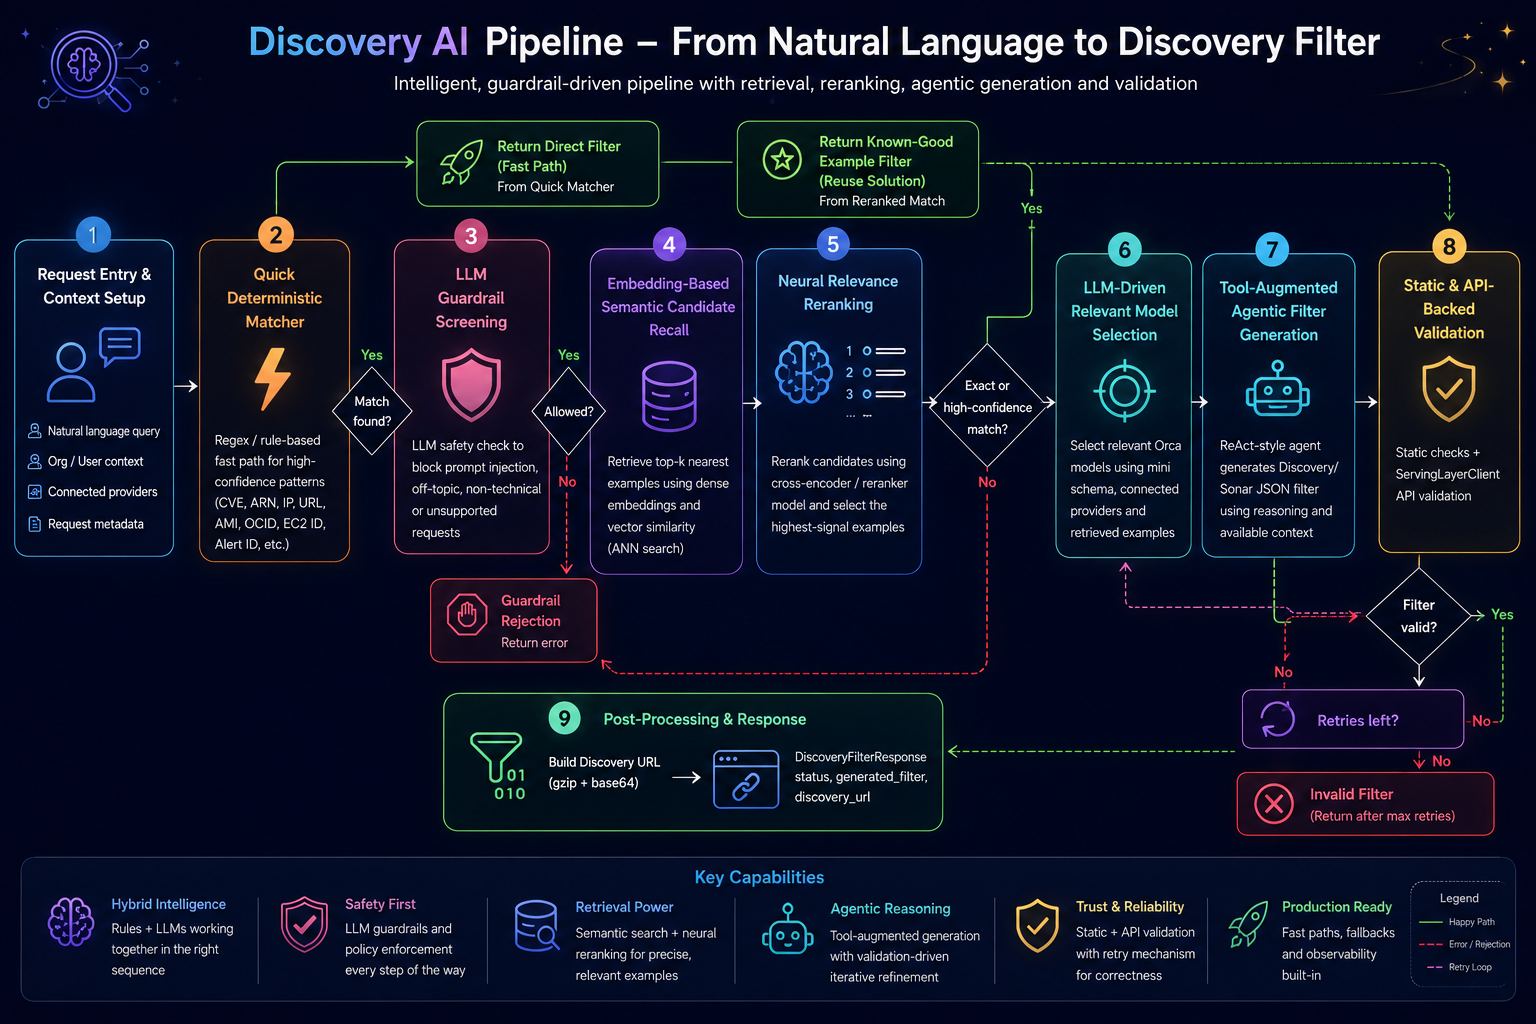
Штучний інтелект Orca Security спрощує запити щодо безпеки хмарних середовищ за допомогою природної мови, що значно зменшує витрати та час обробки. Цей інструмент перетворює звичайний текст у коректні запити Sonar, забезпечуючи зв'язок між природною мовою та структурованими запитами для понад 900 моделей хмарних сервісів.
Штучні нейронні мережі можуть самоорганізовуватися для виконання завдань, подібно до людей. Вчені з MIT стверджують, що мережі повинні мати здатність до самоорганізації, як мозок, щоб надати розуміння біологічного навчання для терапії та інтерфейсів "мозок-комп'ютер".
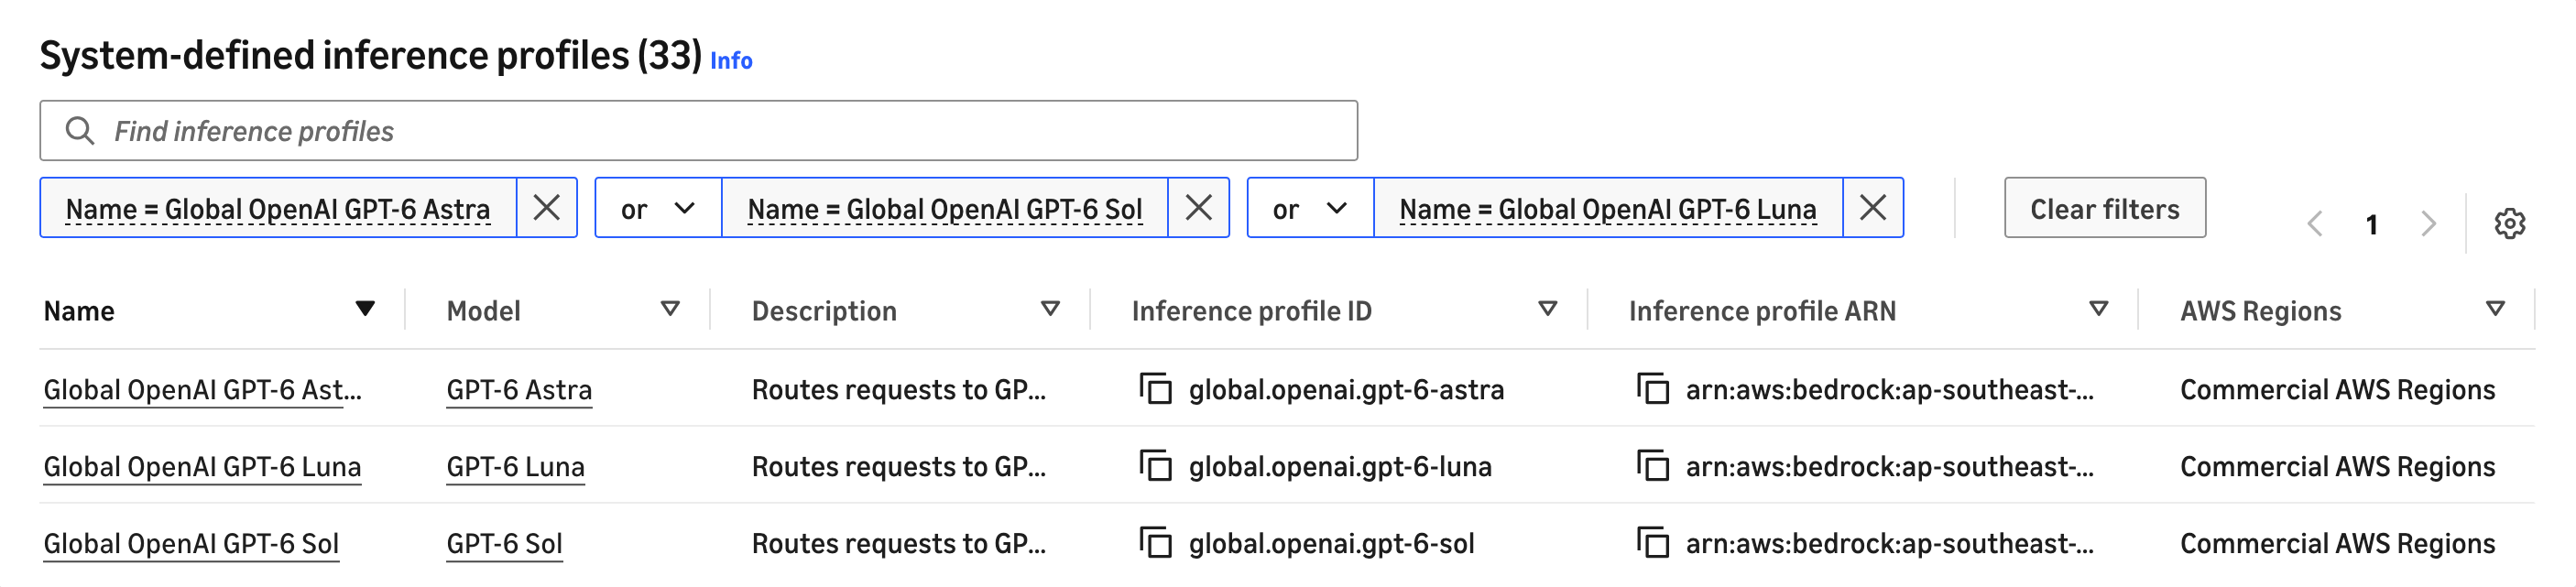
Сервіс Amazon Bedrock пропонує глобальну крос-регіональну обробку запитів для моделей OpenAI GPT-6, зокрема Sol, Luna та Astra, забезпечуючи широкий доступ до ресурсів. Дізнайтеся, як налаштувати сервіс, встановити права доступу та контролювати процес обробки запитів з вашого регіону, враховуючи, що можливості міркування та кодування можуть відрізнятися між різними моделями.
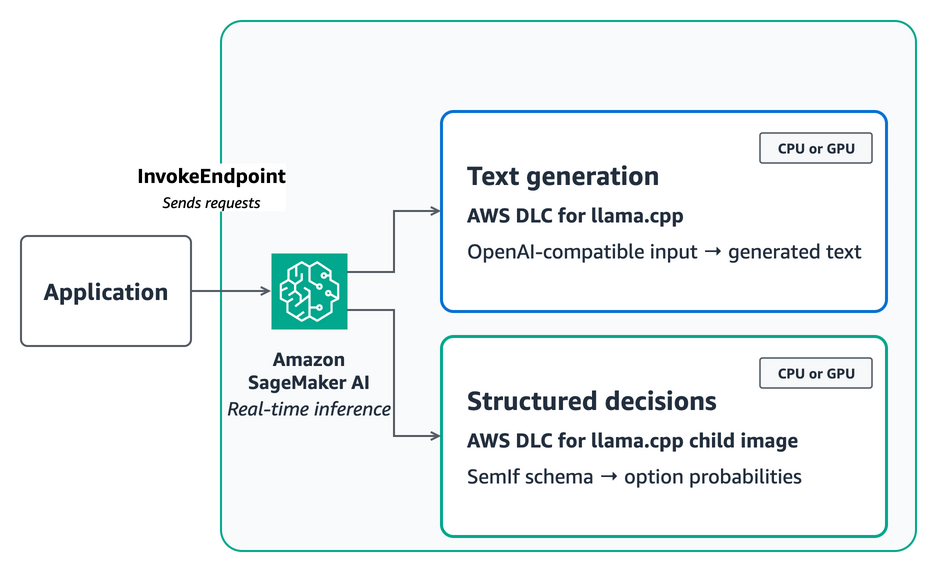
Розгортайте моделі прийняття рішень за допомогою llama.cpp на платформі Amazon SageMaker AI для запуску квантованих моделей на інфраструктурі з процесорами або графічними процесорами. Використовуйте AWS DLC для llama.cpp, щоб забезпечити сумісність з API OpenAI для генерації текстових відповідей, та розширте функціональність за допомогою SemIf для структурованих рішень, пропонуючи варіанти розг...
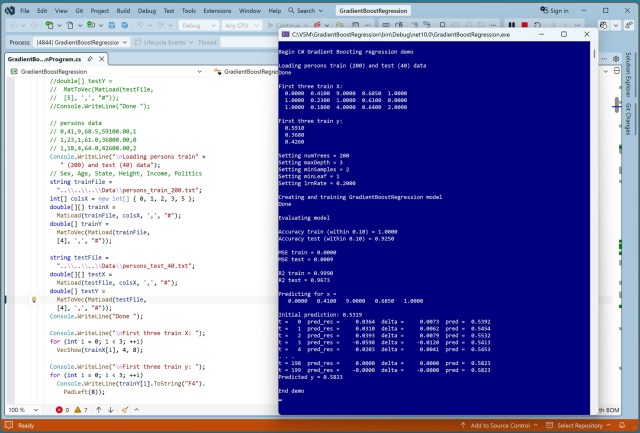
Кодування категоріальних змінних для моделей регресії на основі дерев може бути простим (порядковий тип кодування) або складним (one-hot кодування, згладжене цільове значення). Дивно, але просте порядкове кодування часто працює так само добре, як і більш складні методи, такі як one-hot кодування.
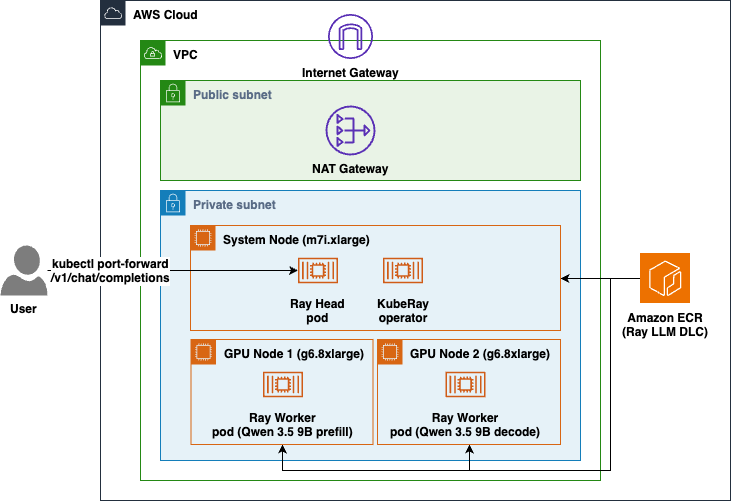
Розгорніть велику мовну модель (LLM) на двох вузлах з графічними процесорами в Amazon EKS, використовуючи контейнери Ray LLM для глибокого навчання з підтримкою кількох вузлів, щоб покращити продуктивність і масштабованість. Окремі вузли для попередньої обробки та декодування підвищують пропускну здатність та ефективність для таких завдань, як RAG (Retrieval-Augmented Generation) та узагальненн...