Організації, що борються з голодом у США, використовують платформу Amazon Quick для досягнення змін.
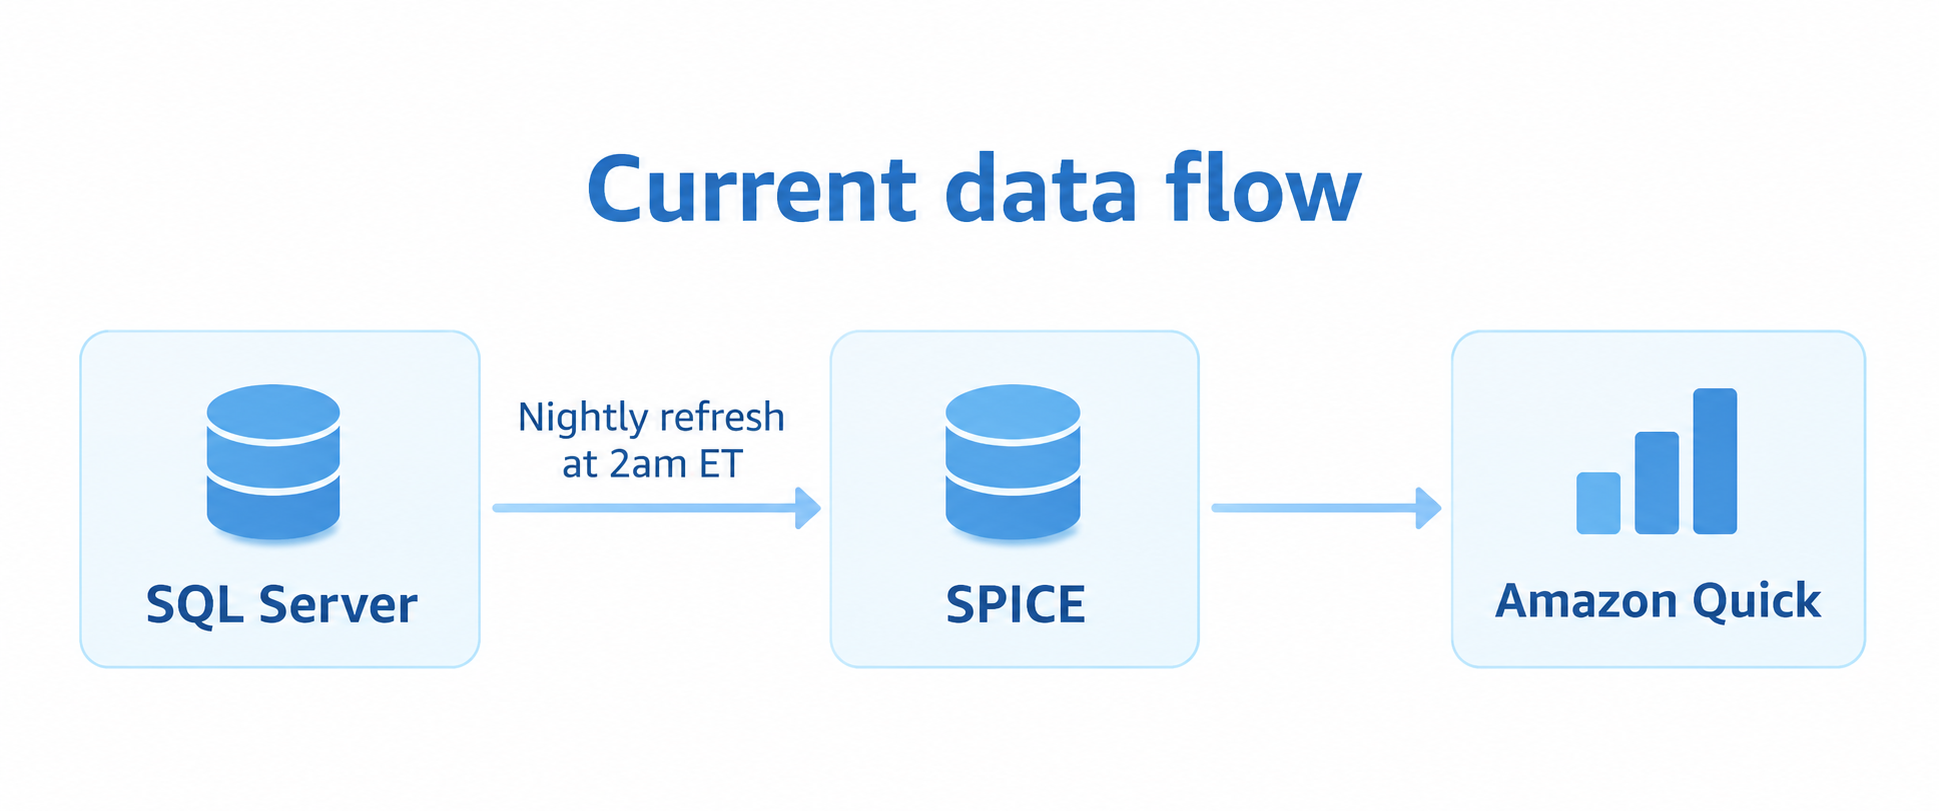
Місія організації U.S. Hunger виходить за рамки простої доставки їжі, зосереджуючись на розумінні потреб сімей. Особиста відданість президента Ріка Віттеда сприяє розвитку організації та її інноваційному використанню Amazon Quick для аналізу даних.
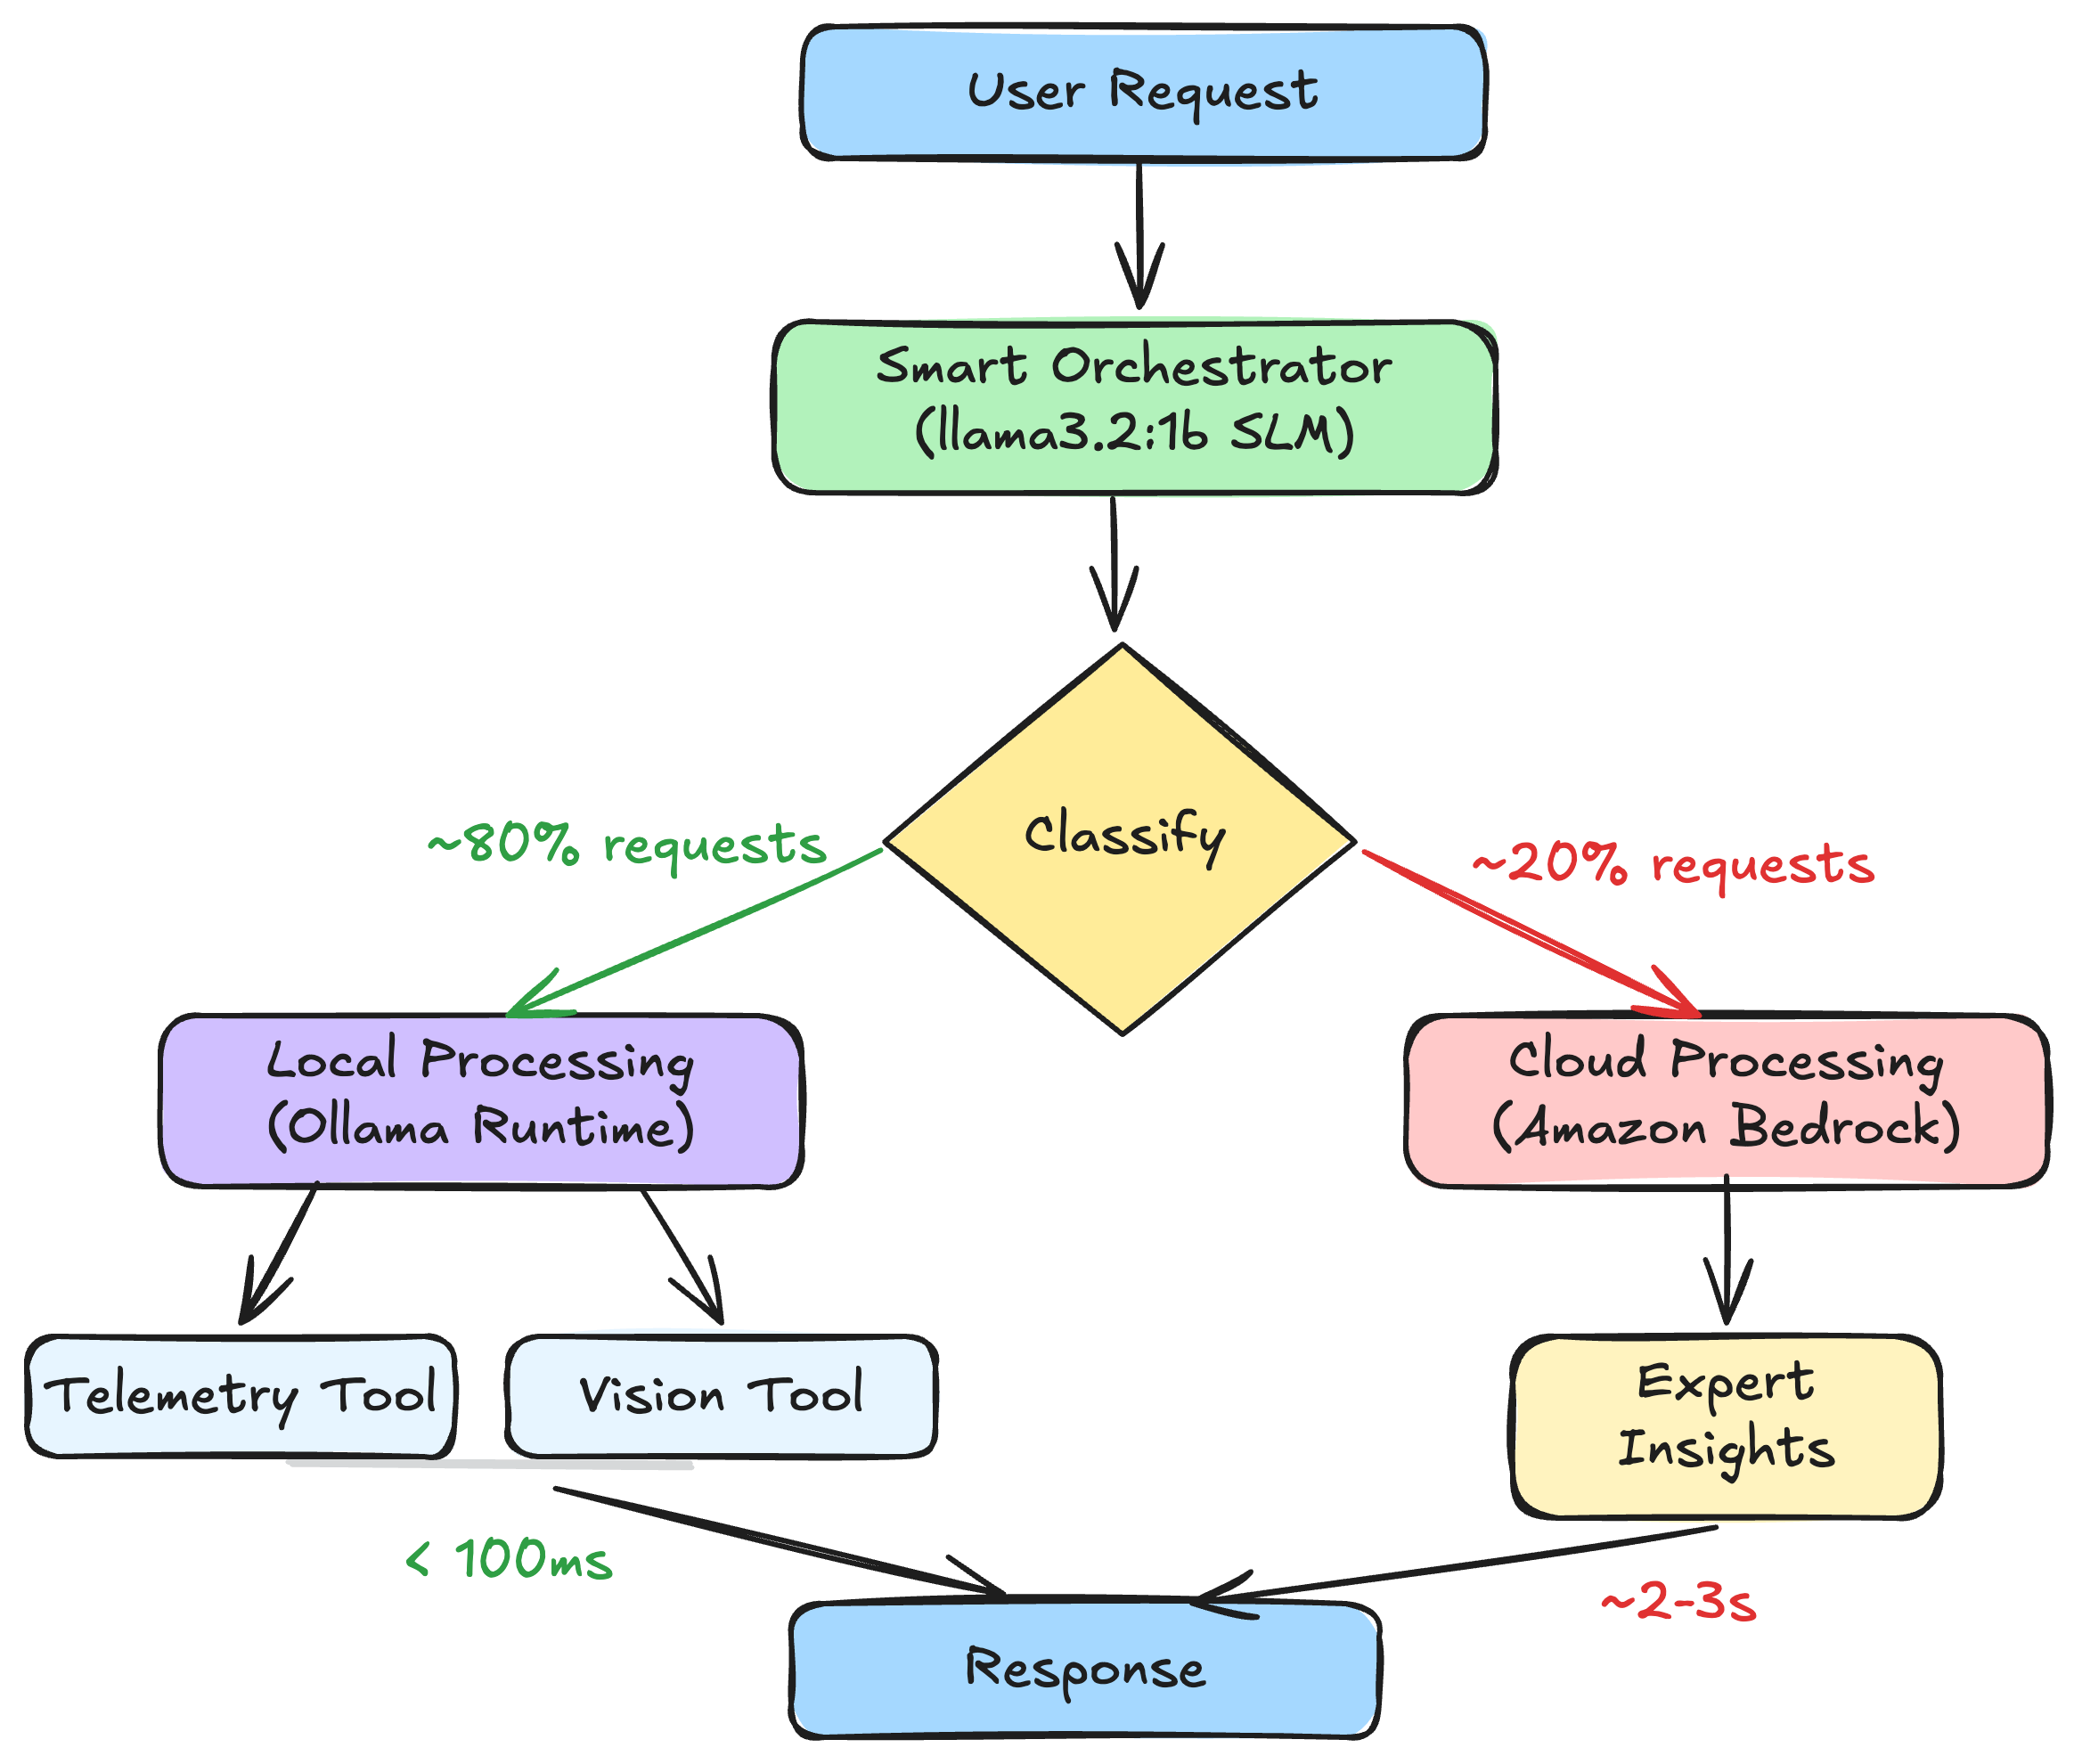
Фреймворк адаптивного інтелекту агентів (AAIF) використовує невеликі мовні моделі (SLM) для рутинних завдань і хмарні моделі для складних запитів, що дозволяє знизити витрати та затримки. Три шари AAIF – розумна оркестровка, локальна обробка та обробка в хмарі – оптимізують роботу штучного інтелекту для різних типів завдань, демонструючи гнучкий і економічно ефективний підхід.
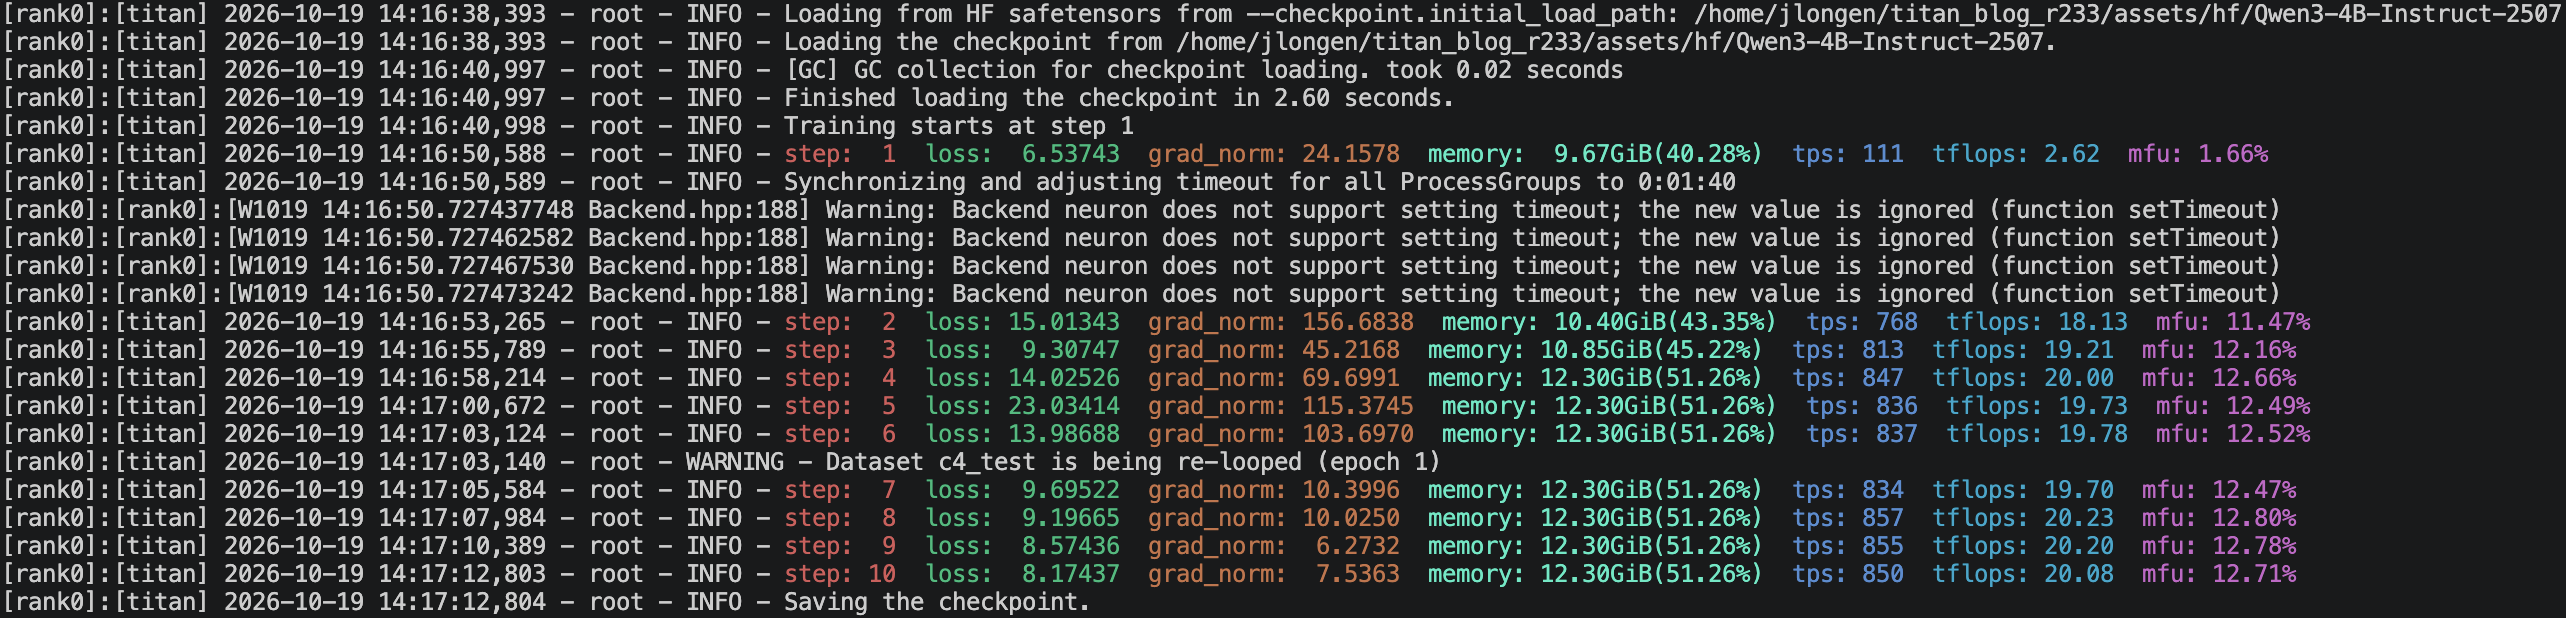
Навчіть модель Qwen3 трьома способами на одному сервері trn2.48xlarge, використовуючи технологію torchtitan на AWS Trainium. Налаштуйте реалізацію моделі та ядра для вашого робочого процесу за допомогою інтерфейсу ядер Neuron Kernel Interface (NKI) та ядер MoE.
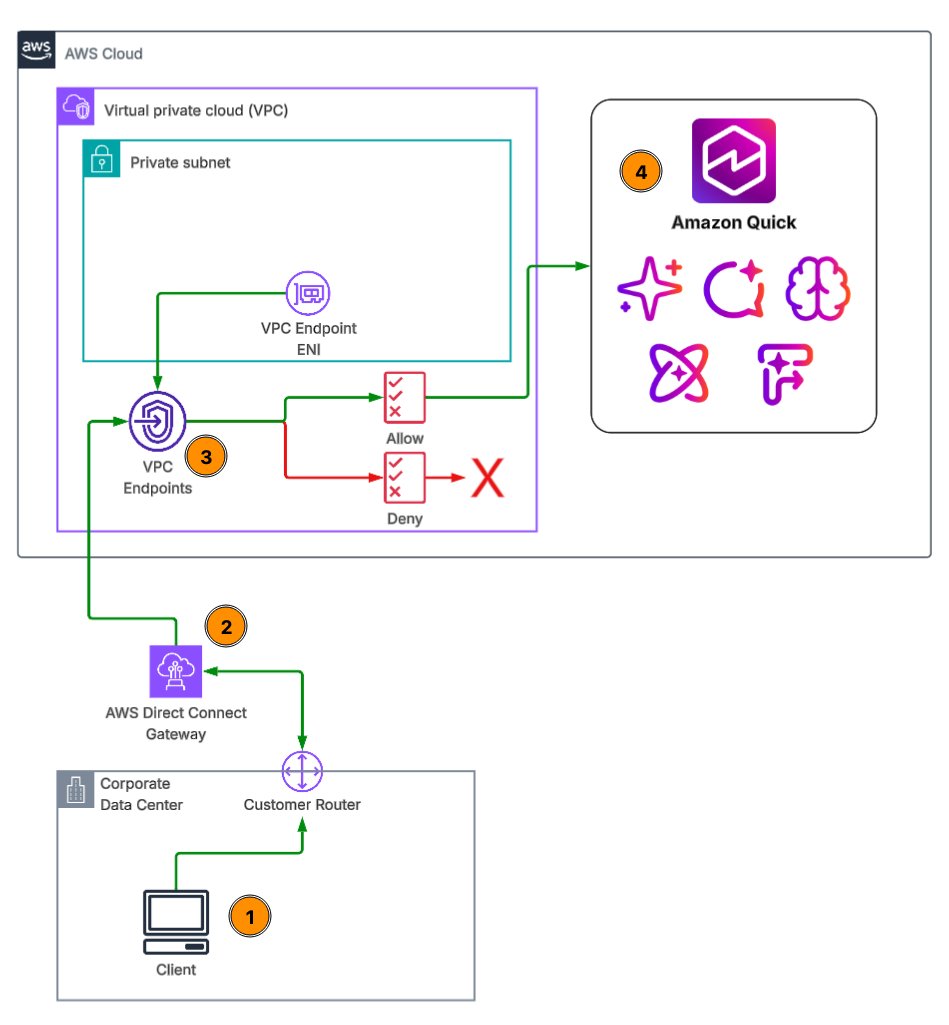
Забезпечте безпечне підключення локальних даних до сервісу Amazon Quick за допомогою приватної мережі, що зменшить площу атаки та забезпечить відповідність вимогам. Сервіс Amazon Quick пропонує пошук, аналітику та автоматизацію на основі штучного інтелекту в приватному, захищеному середовищі для обробки трафіку користувачів і отримання даних.
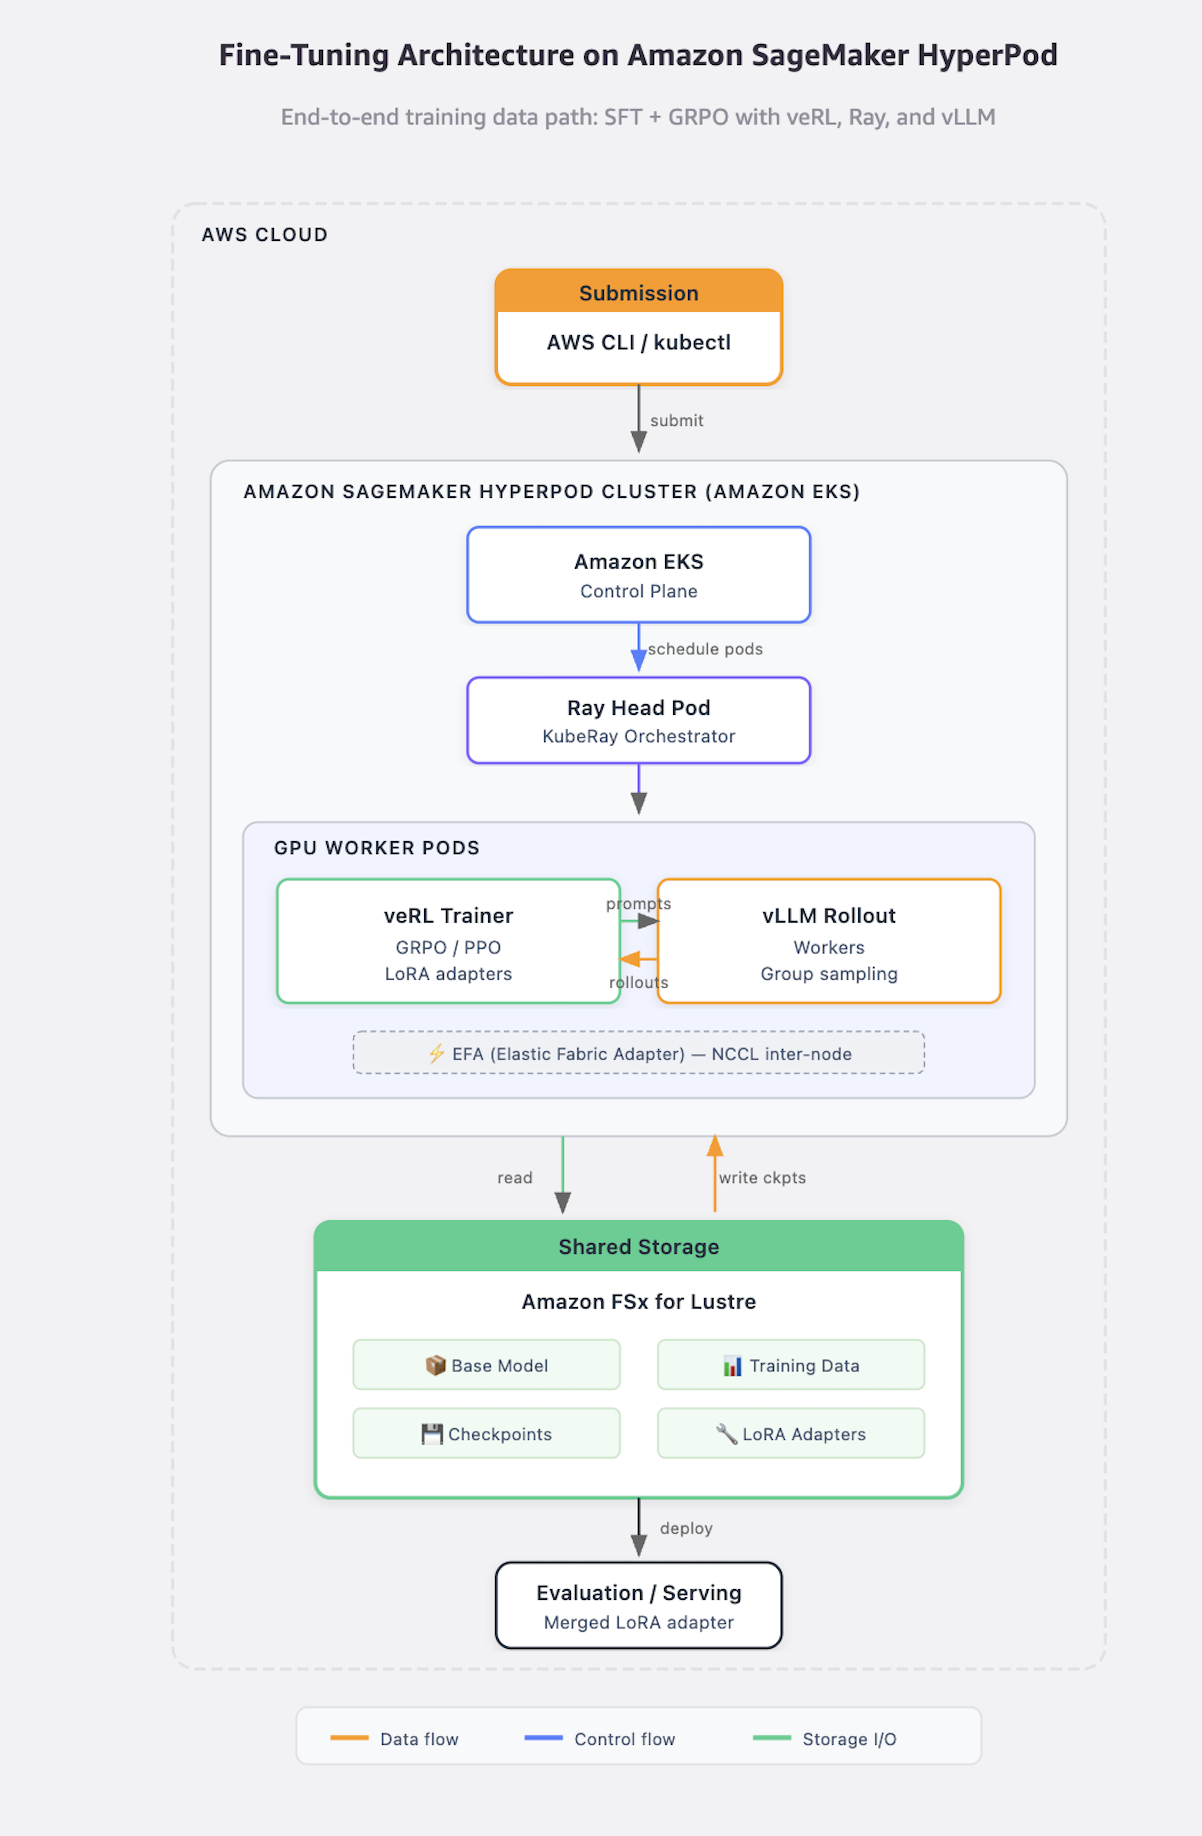
Модель GPT-OSS-20B має труднощі з багатомовною обробкою інформації та часто використовує англійську мову за замовчуванням. Тонке налаштування моделі за допомогою SFT і GRPO на платформі Amazon SageMaker HyperPod покращує точність обробки різних мов.
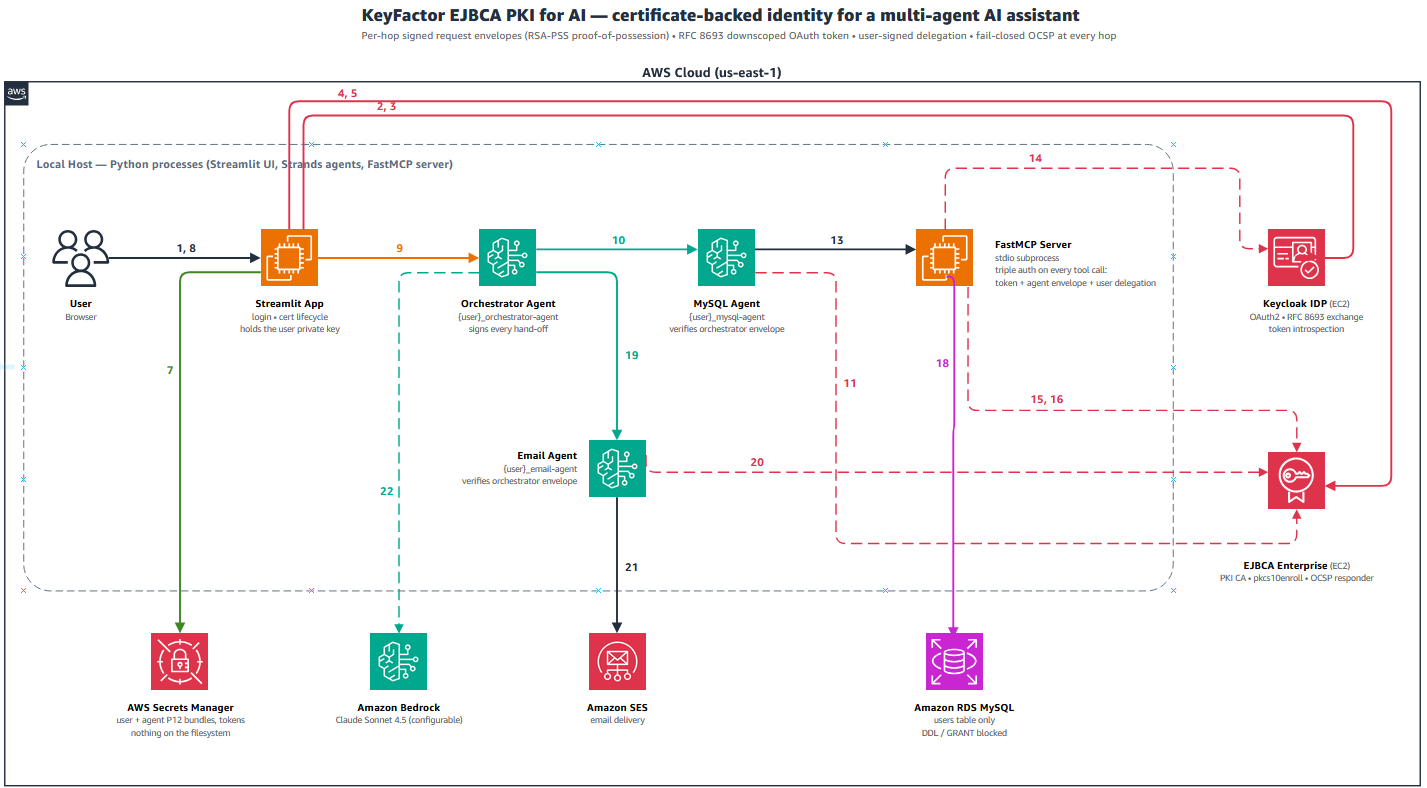
Встановлення криптографічної ідентичності за допомогою стандарту X.509 PKI є критично важливим для агентів штучного інтелекту, які отримують доступ до конфіденційних даних. Сервіси Keyfactor EJBCA та AWS забезпечують безпечну автентифікацію для багатоагентних систем штучного інтелекту, запобігаючи несанкціонованому доступу та гарантуючи надійність ідентичності машин.
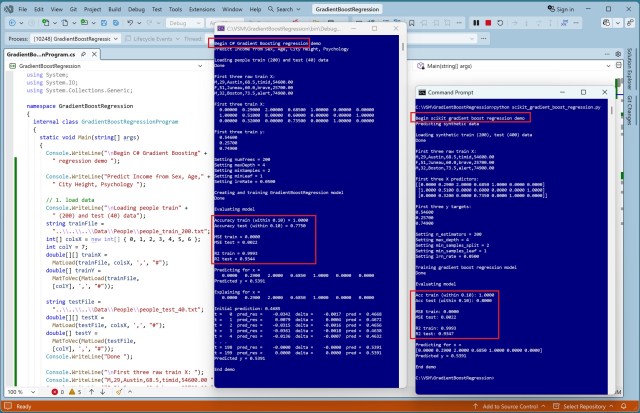
Моя реалізація моделі GBR на C# дає результати, що відповідають результатам scikit-learn, точно прогнозуючи дохід на основі статі, віку, міста, зросту та психологічних факторів. Ця реалізація на C# дозволяє детально пояснювати процес передбачення, демонструючи її ефективність і прозорість у машинному навчанні для задач регресії.
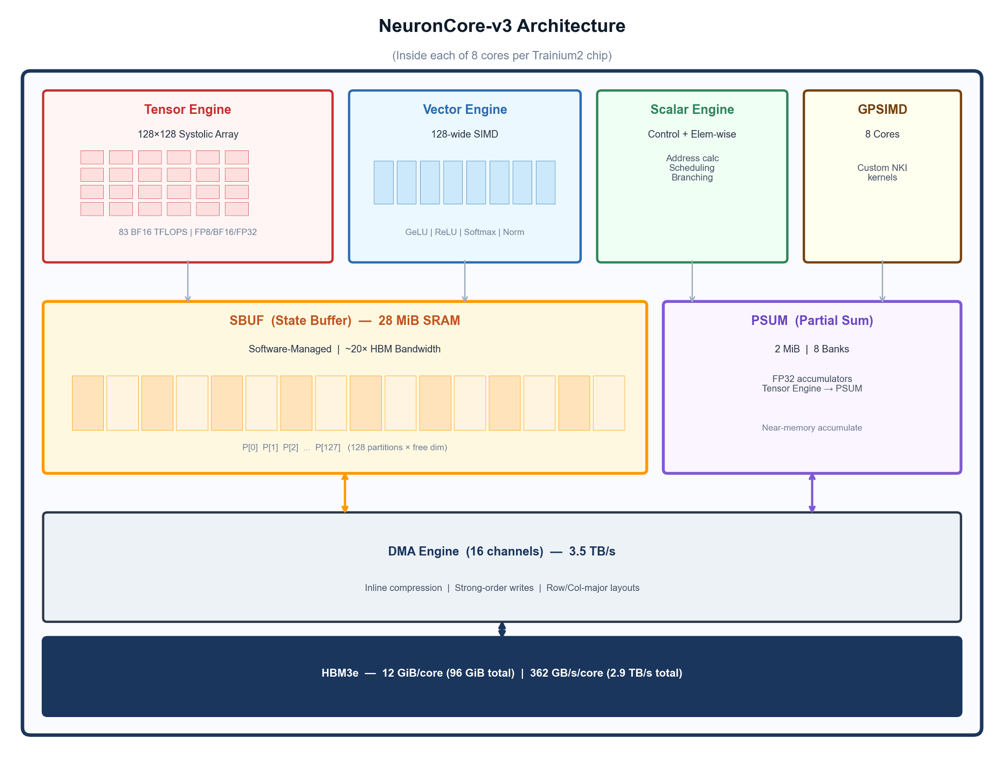
Компанія i14 розробила модель Laplace 3B, яка використовує механізм лінійної уваги, для вирішення проблем масштабованості традиційних великих мовних моделей (LLM). Співпрацюючи з AWS, вони оптимізували цю модель для процесора Trainium2, досягнувши високої швидкості навчання та стабільного обсягу пам'яті, необхідного для роботи.
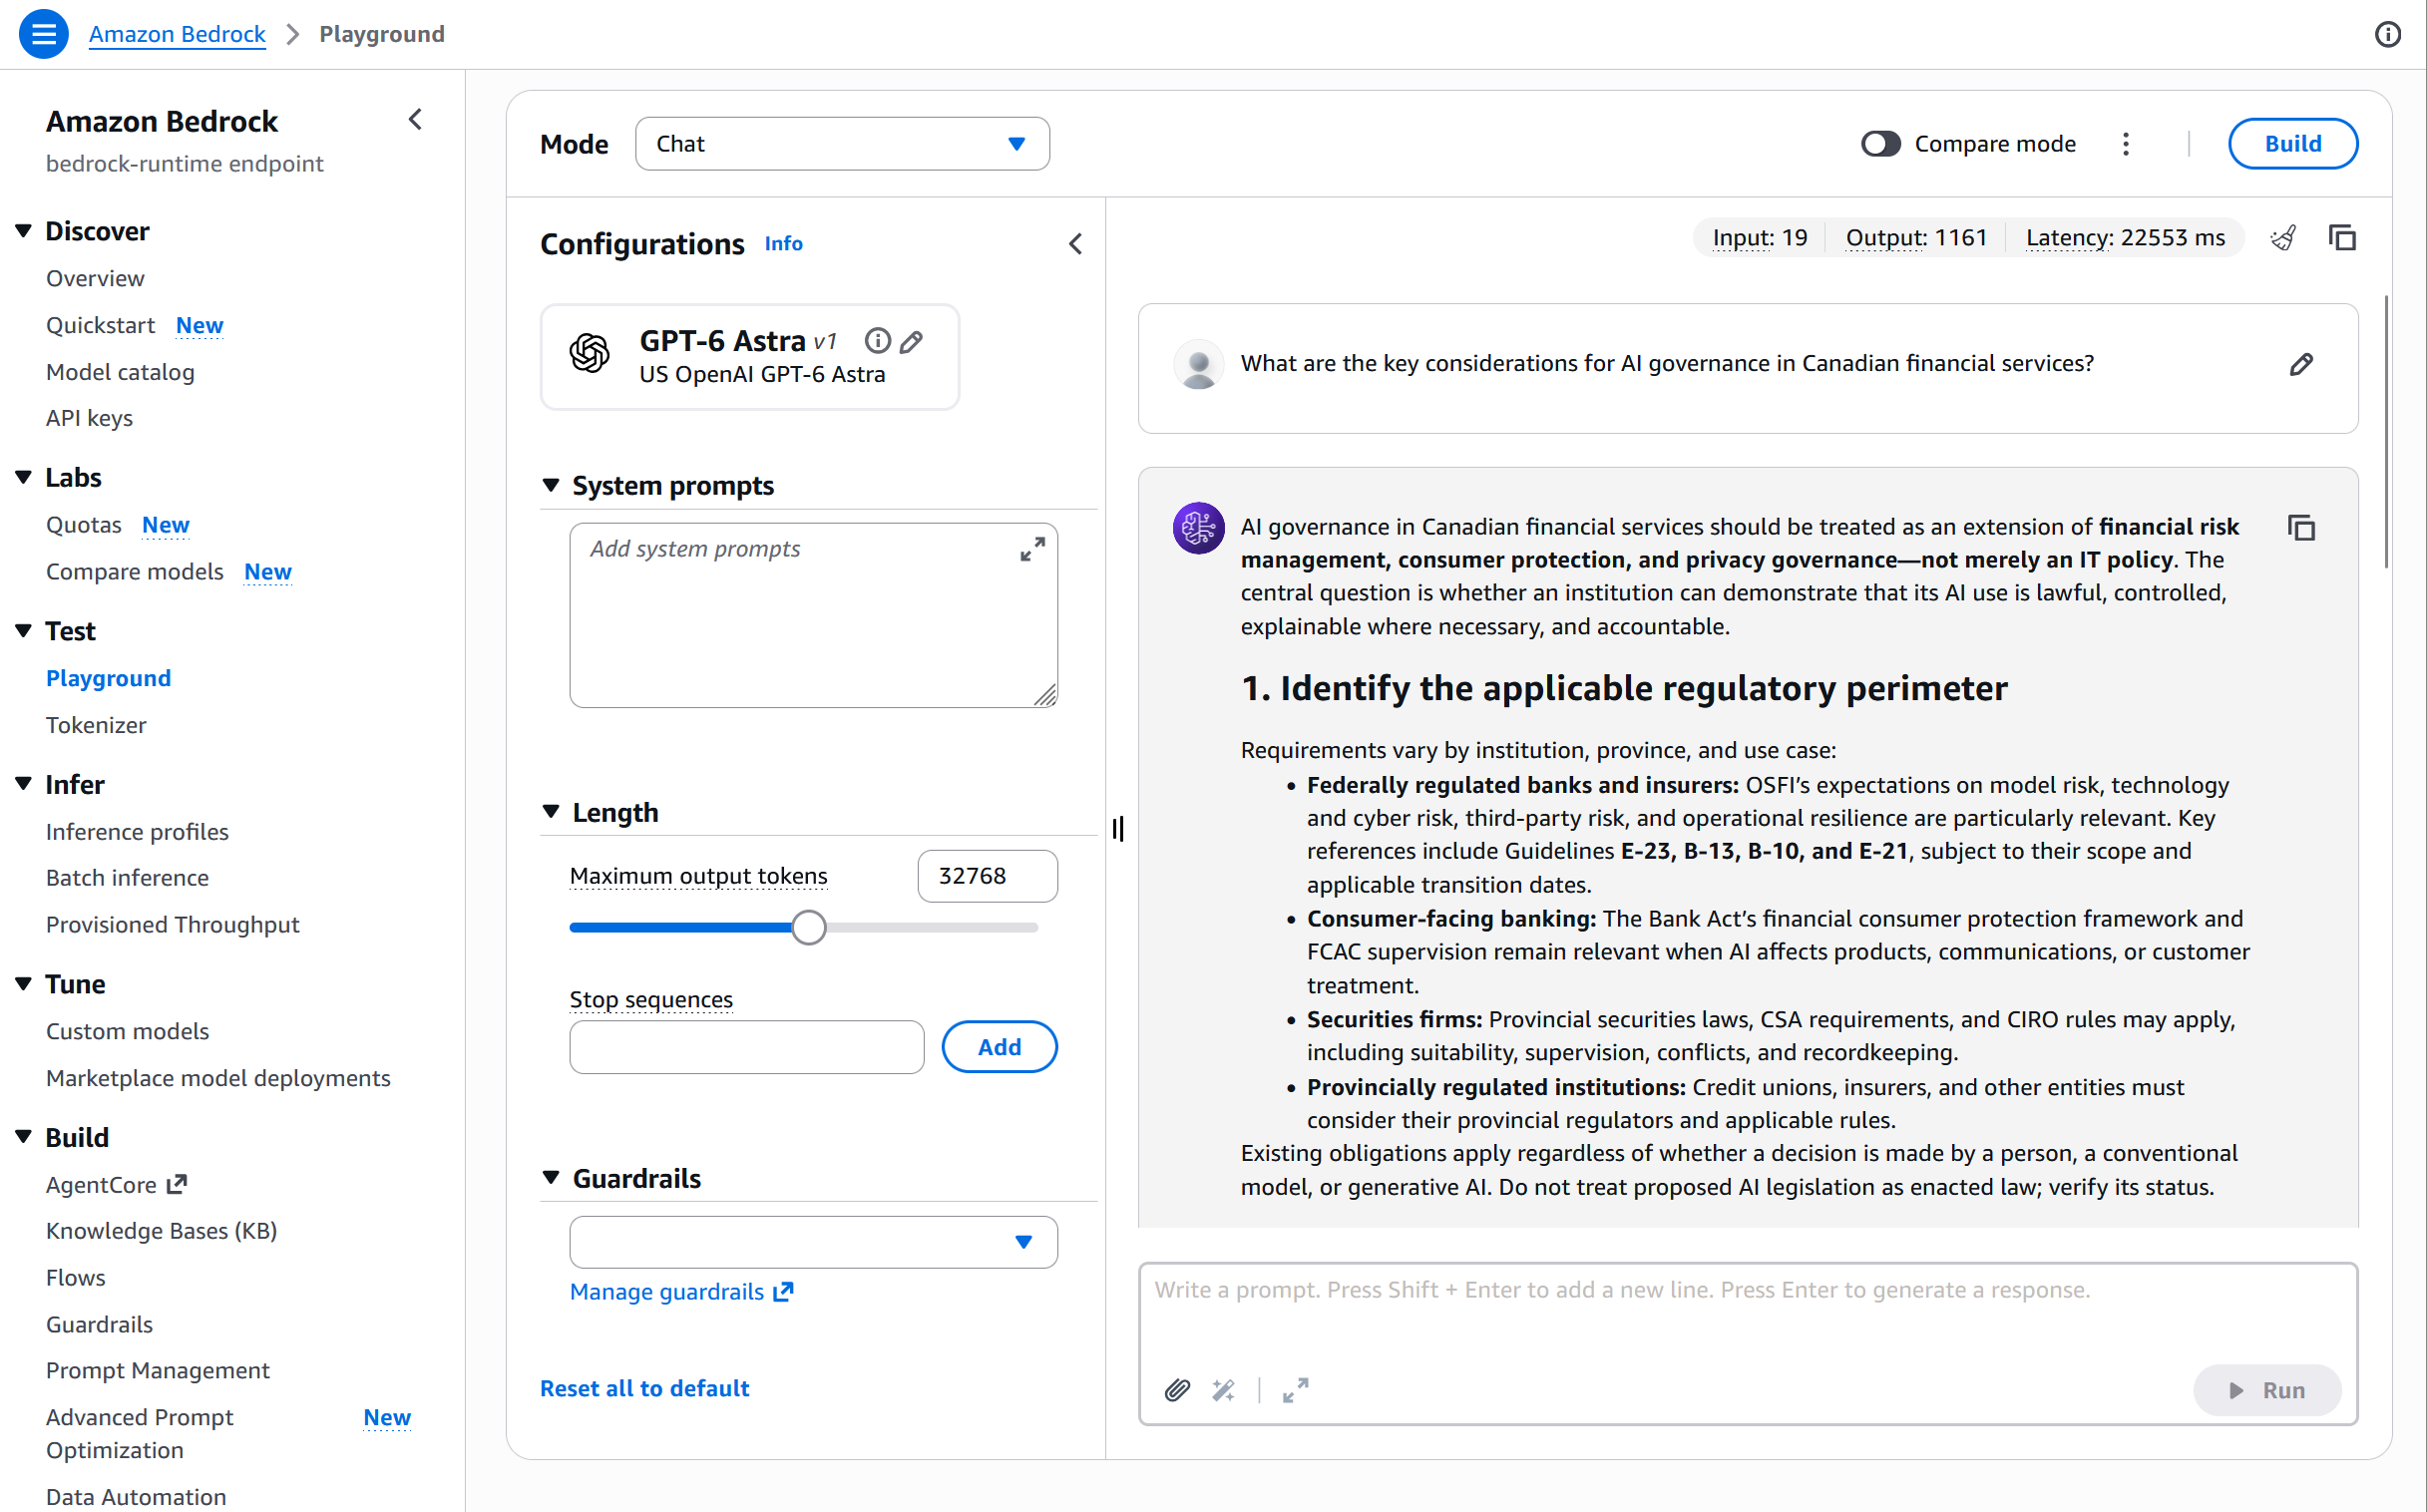
Канадські організації, які використовують Amazon Bedrock, тепер можуть отримати доступ до найновіших моделей OpenAI, включаючи GPT-6, у канадських регіонах AWS з підтримкою обробки даних між різними регіонами. Моделі, доступні в Канаді, пропонують широкий спектр можливостей, від складних обчислень до швидкої та економічної обробки даних, підтримуючи текстові та графічні вхідні дані з контекстни...
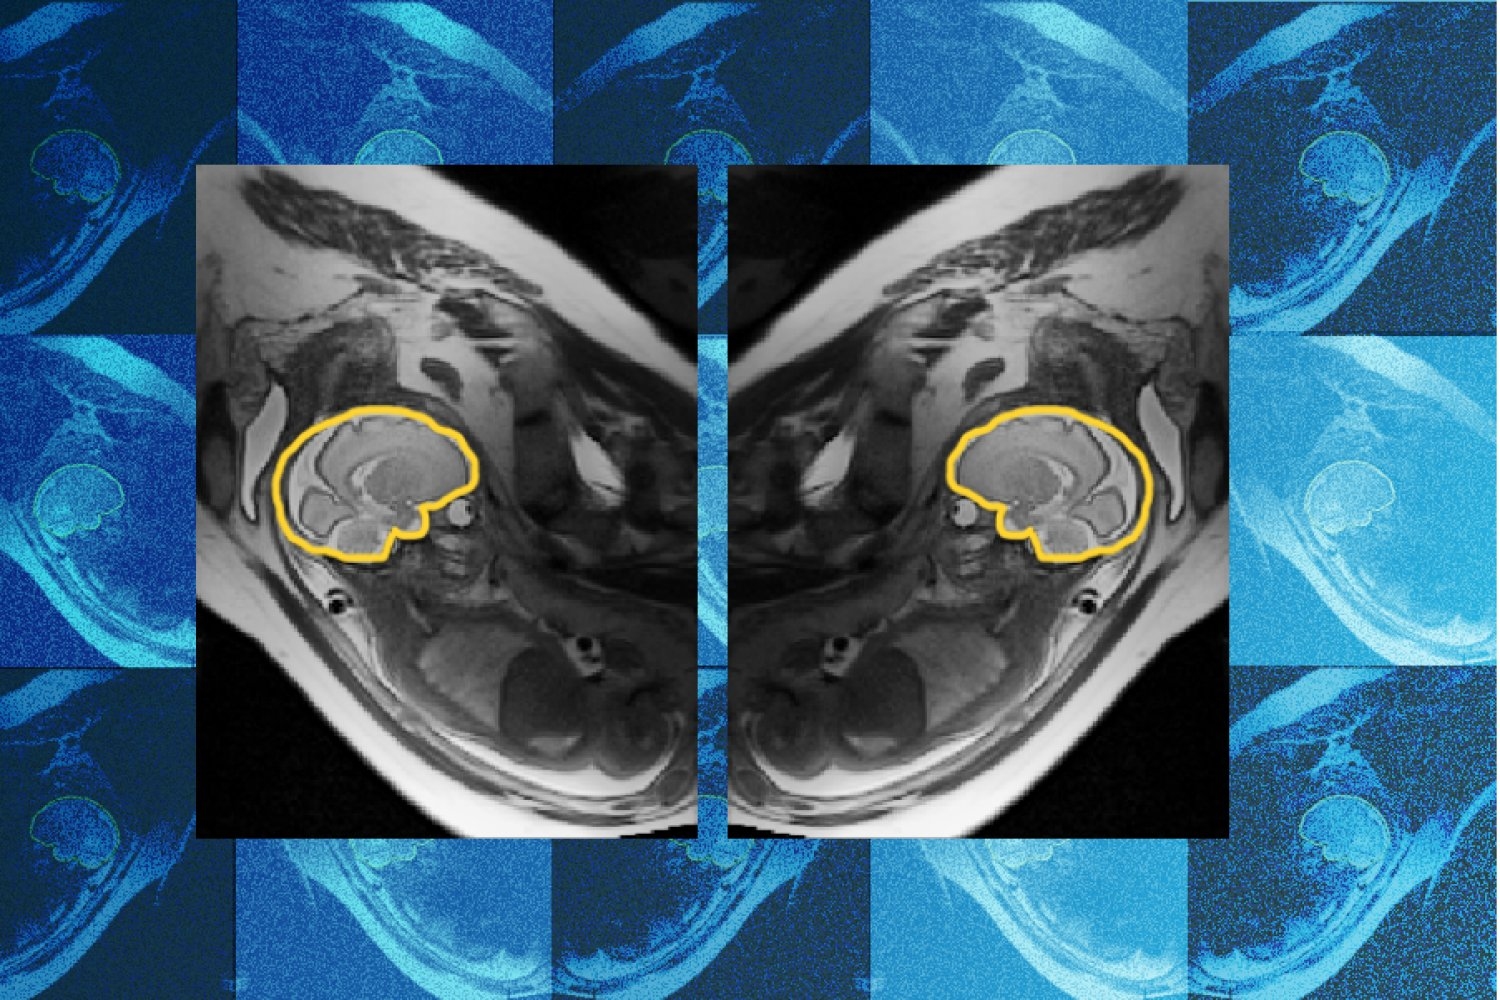
Дослідники з MIT та дитячої лікарні Бостона розробили модель глибокого навчання під назвою E(3)-Pose, яка відстежує рухи мозку плода під час МРТ-сканування для покращення якості зображення та точності. Модель використовує принципи фізики для підвищення точності визначення орієнтації мозку, що допомагає у ранній діагностиці порушень розвитку мозку плода.
Amazon SageMaker JumpStart пропонує відібраний каталог моделей штучного інтелекту, шаблонів і блокнотів, що спрощує вибір та розгортання моделей машинного навчання. Провідні постачальники, такі як Alibaba, NVIDIA та Google, надають різноманітні моделі для пошуку, розгортання та налаштування.
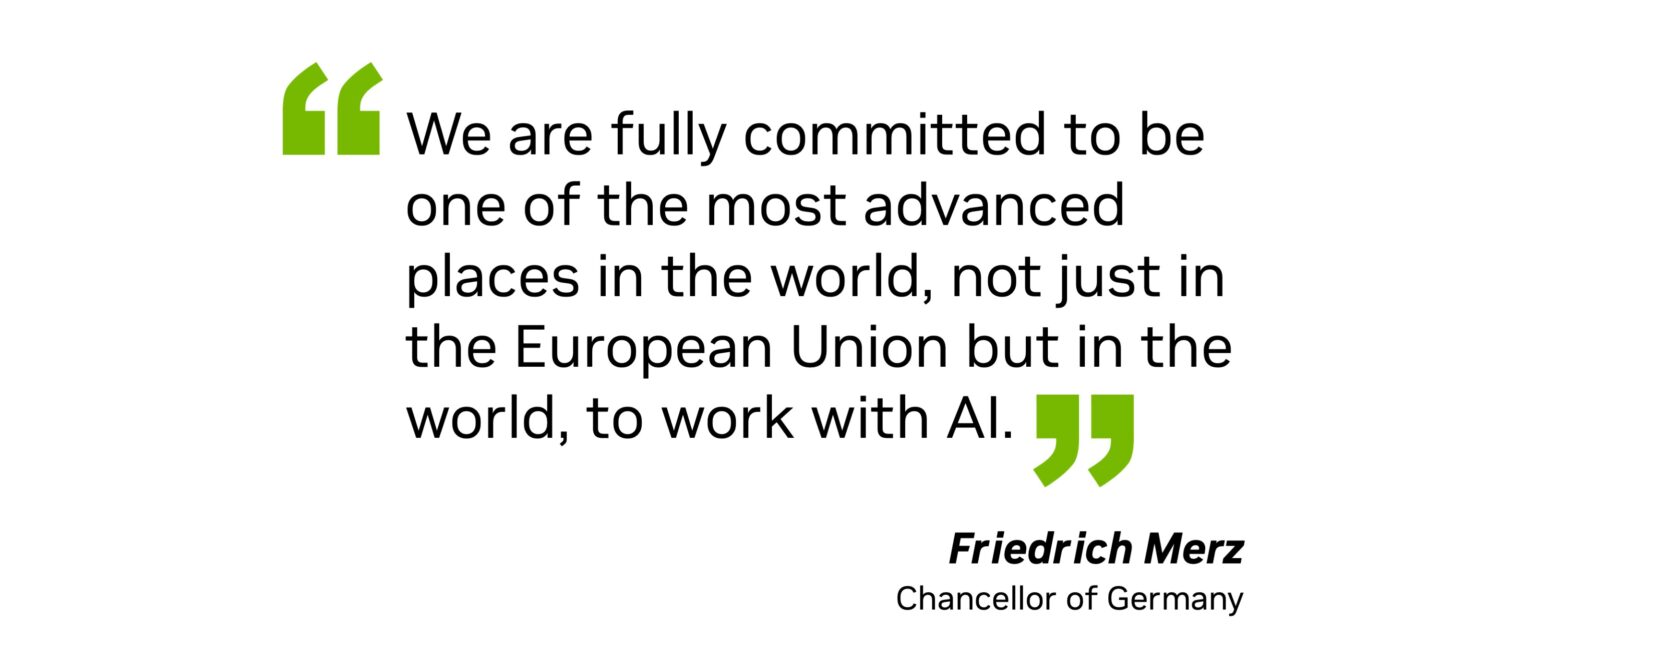
Канцлер Німеччини Фрідріх Мерц та генеральний директор компанії NVIDIA Дженсен Хуанг обговорили стратегію розвитку штучного інтелекту в Німеччині під час зустрічі в Kraftwerk, наголошуючи на застосуванні ШІ у виробництві та автомобільній промисловості. Німеччина прагне поєднати інженерну експертизу з технологіями штучного інтелекту, співпрацюючи з NVIDIA для розвитку промислових моделей ШІ та с...
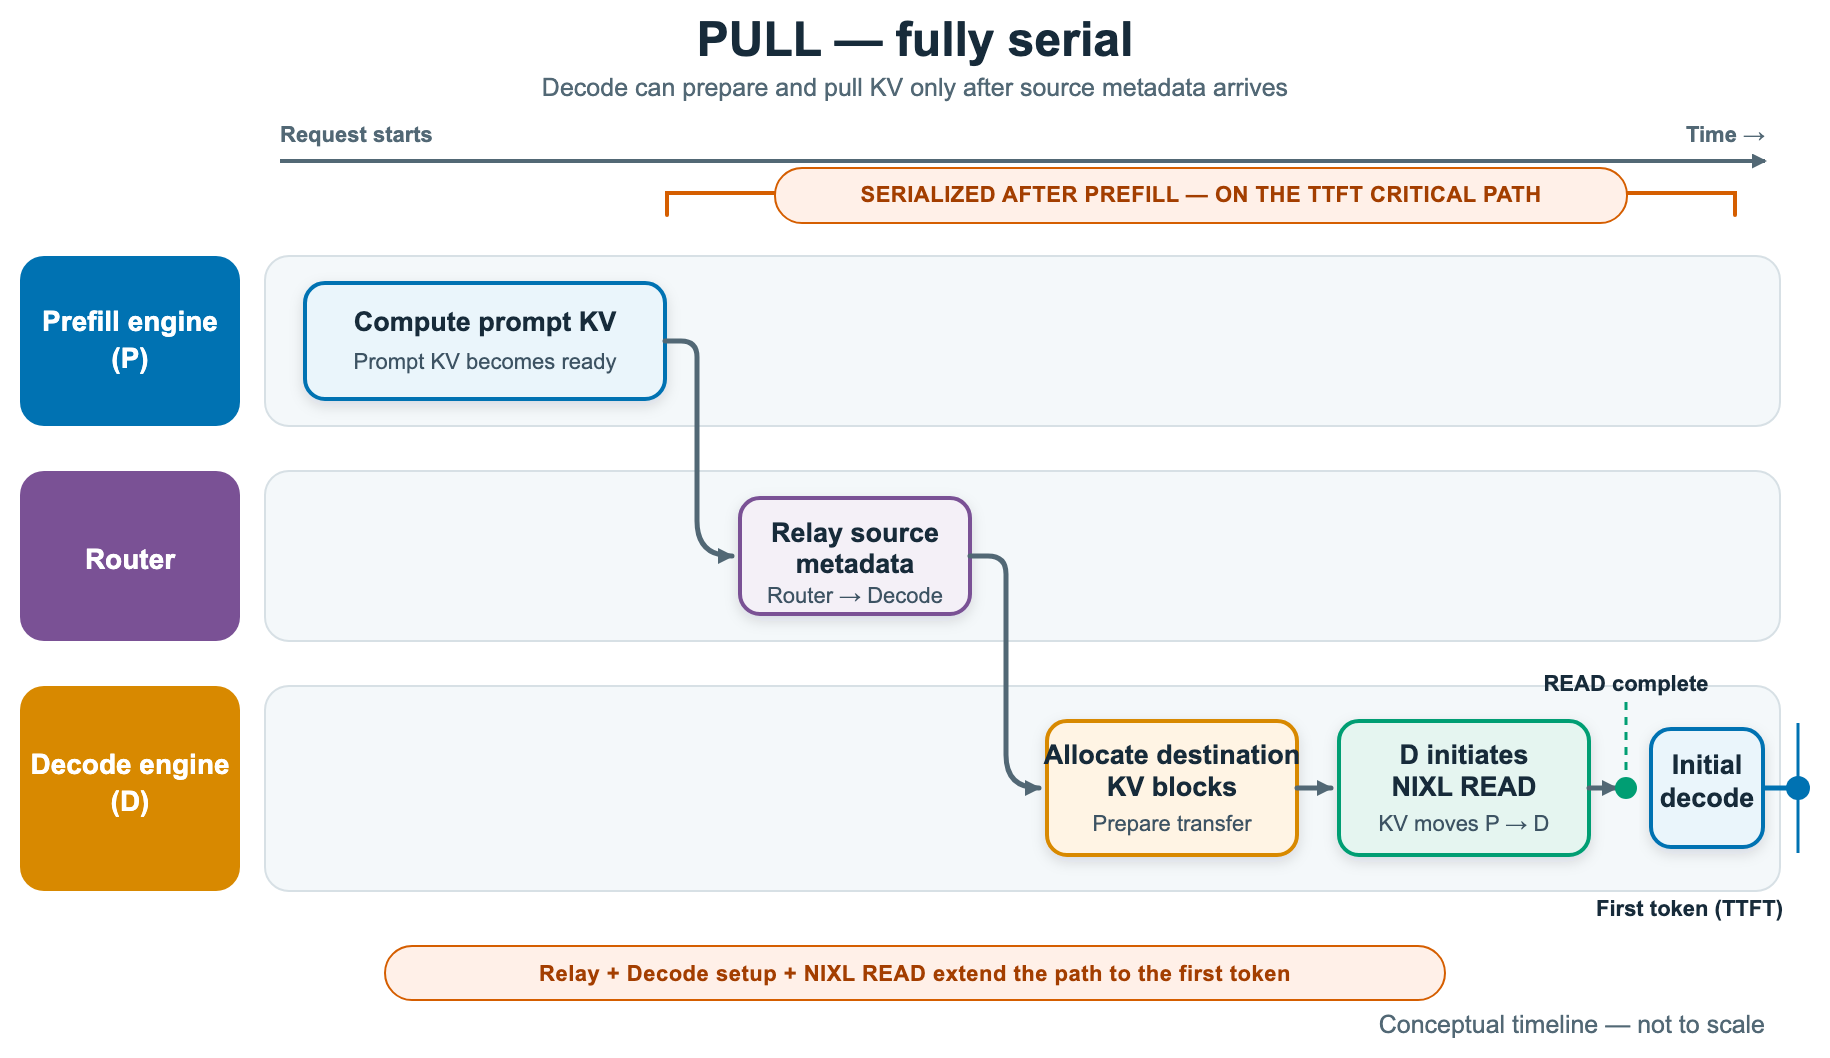
vLLM представляє з'єднання NIXL, що працює за принципом "push", для ефективної передачі даних KV, що дозволяє скоротити час генерації першого токена. Тестування показало, що в режимі "push" час генерації першого токена може бути до 3 рази швидшим порівняно з режимом "pull" для моделі Qwen3-32B на інстансах Amazon EC2 P5en з EFA.
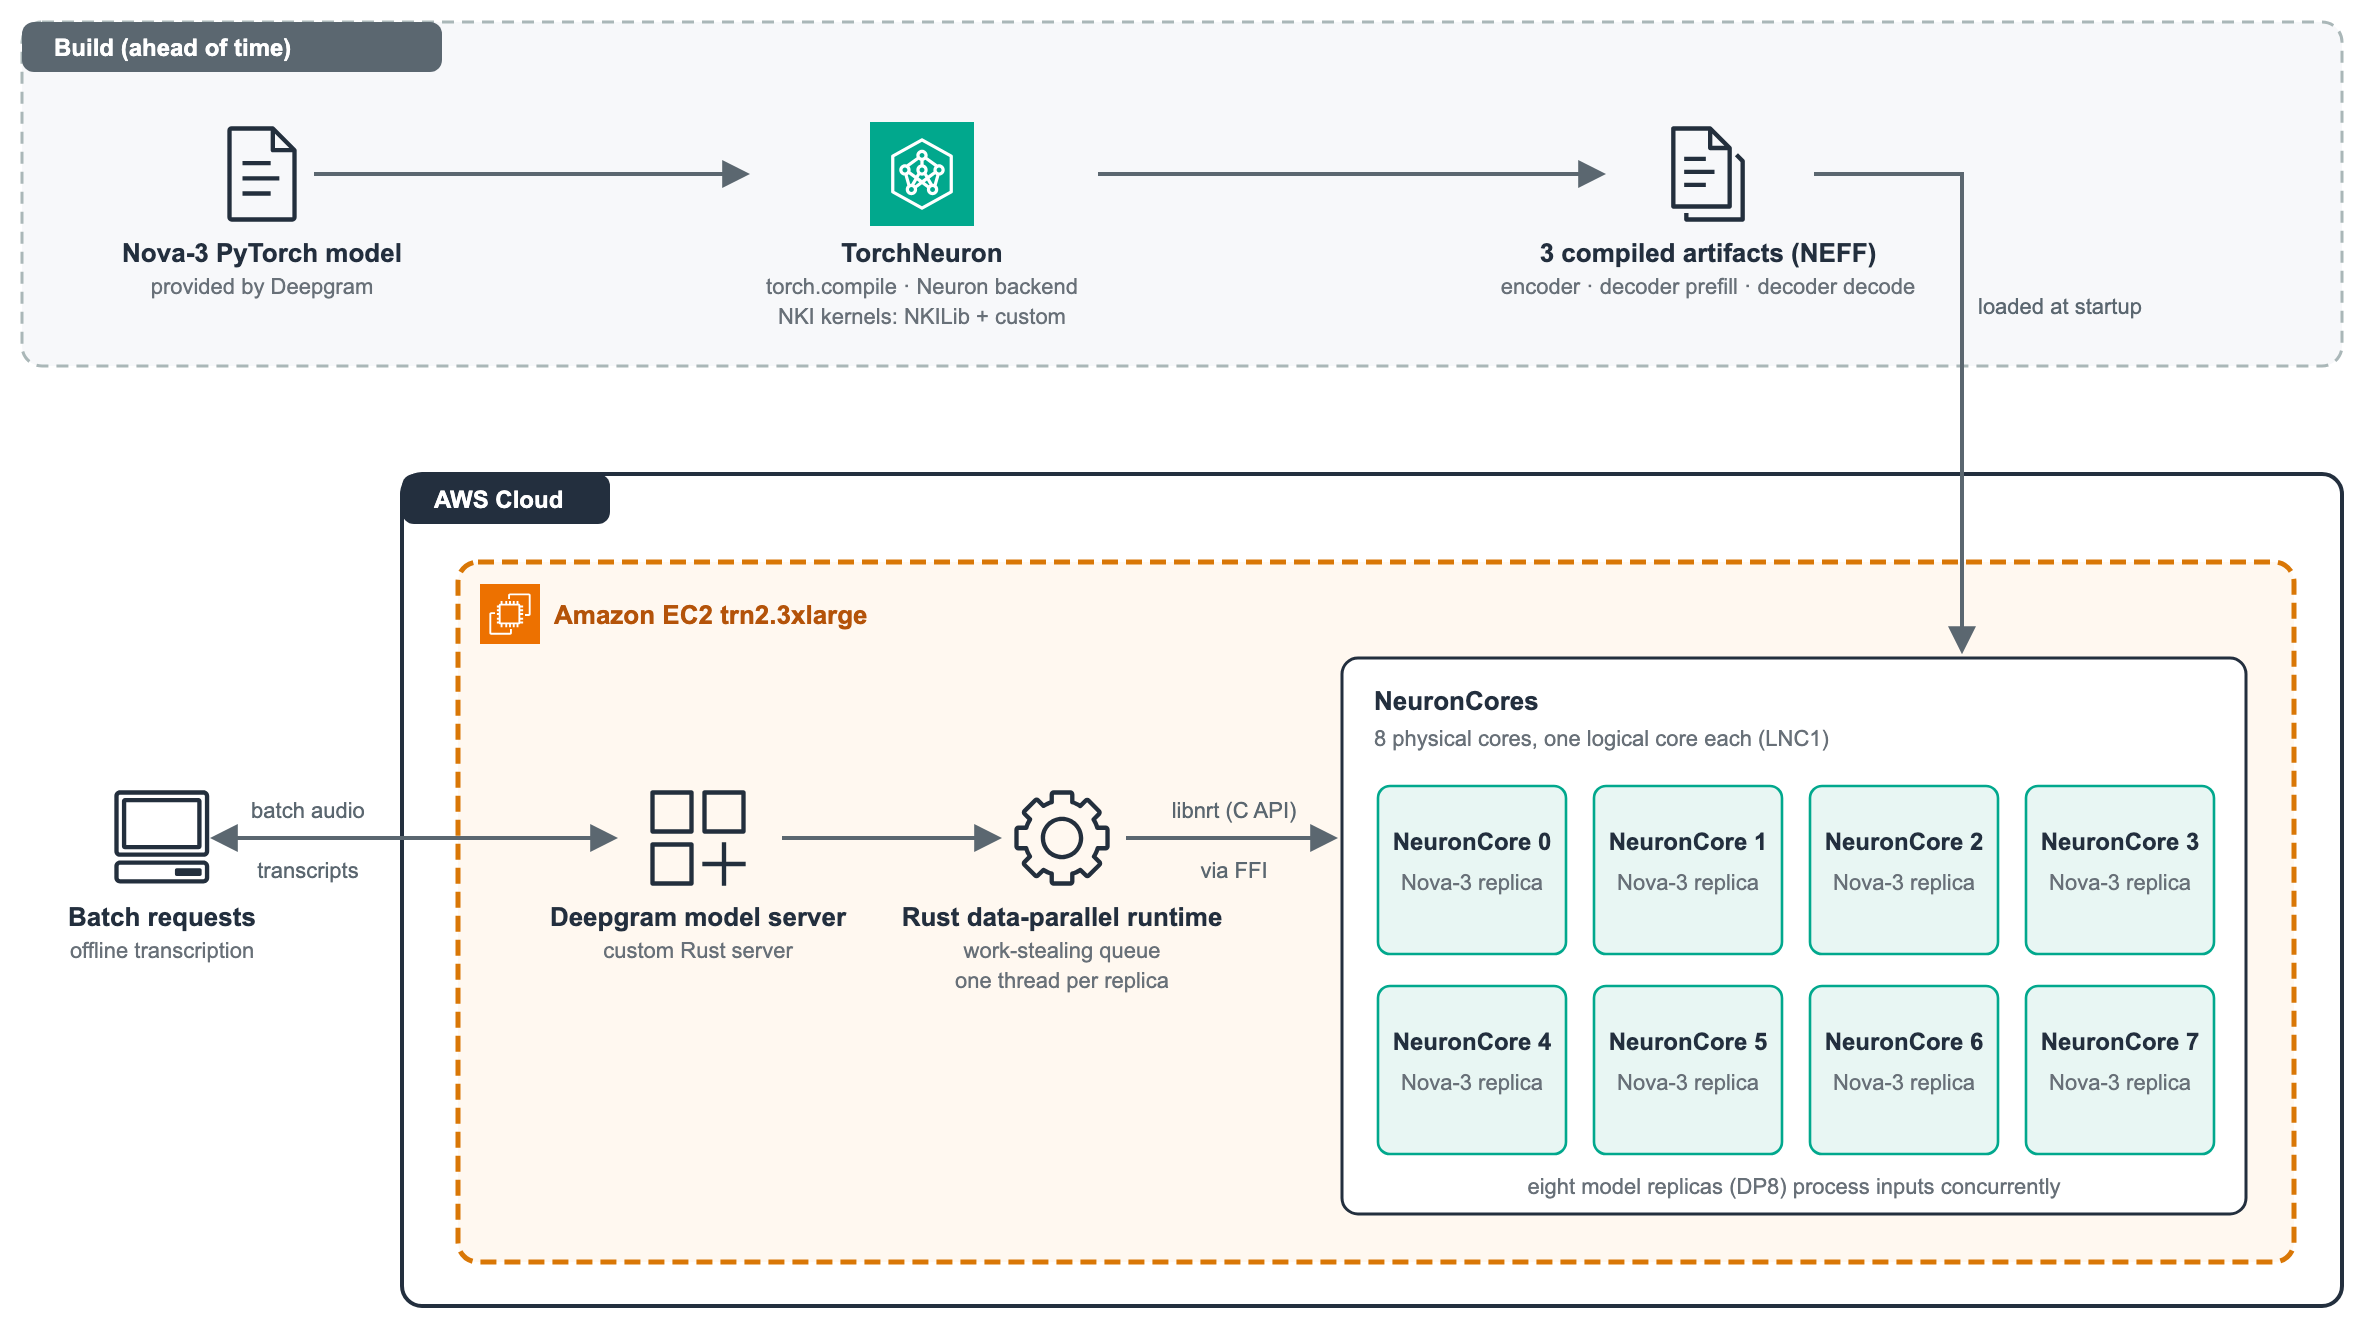
Компанія Deepgram використовує процесори штучного інтелекту від AWS для підвищення ефективності, дозволяючи клієнтам обробляти на 11-70% більше аудіо за ту ж суму грошей. Deepgram та AWS співпрацюють для оптимізації Nova-3 на Trainium2, що покращує роботу моделей перетворення мовлення в текст.
Сервіс Amazon Bedrock тепер підтримує структуровані вихідні дані для всіх моделей Anthropic Claude, що забезпечує відповідність JSON-відповідей заданій схемі. Це усуває необхідність у спеціальній обробці та пост-обробці даних, роблячи такі завдання, як вилучення інформації та аналіз договорів, більш ефективними та надійними.